Hello, RISC-V!
This post covers my RISC-V study notes and personal insights
Introduce
2000년대 초반까지는 하드웨어가 알아서 빨라지던 시대였습니다. 단일 코어 성능이 매년 비약적으로 늘어난 덕분에 소프트웨어 개발자들은 굳이 최적화에 목을 매지 않아도 성능 향상의 이점을 누릴 수 있었습니다.
하지만 2003년경, 발열과 전력 소모, 그리고 ILP(명령어 수준Basic 병렬성)가 한계에 부딪히며 이러한 흐름은 정체되었습니다. 제조사들은 클럭 주파수를 높이는 대신 멀티코어로 선회했고, 이때부터 성능을 제대로 뽑아내기 위해 병렬 프로그래밍과 컴퓨터 구조에 대한 깊은 이해는 필수 역량이 되었습니다.
그렇다면 왜 수많은 아키텍처 중 하필 RISC-V일까요?
일단 X86-64는 제외했습니다. micro operation이 있다곤 하지만 시작부터 너무 비대한 아키텍쳐를 공부하면 제대로 소화하지 못할 것 같았습니다.
RISC 기반 아키텍처는 원리적인 면에서는 비슷비슷합니다. 그렇지만 저는 굳이 복잡한 상업적 제약이 걸린 폐쇄적인 아키텍처를 붙잡고 씨름하고 싶지 않았습니다. 특히 RTL 레벨의 설계 경험이 있는 입장에서, 가장 밑바닥까지 투명하게 파고들 수 있는 RISC-V를 선택하는 것이 기본기를 다지기 가장 좋은 길이라 판단했습니다.
또한, Inference Performance에 관심이 많은 저에게 특수 목적 가속기에서 RISC-V가 보여주는 성장세가 매력적으로 다가왔습니다. 물론 산업계 전체로 보면 RISC-V의 점유율은 여전히 저조합니다. 리스크가 굉장히 많이 존재하는 것도 사실이고요. RISC-V를 사용했을때 설계 검증 및 툴체인 안정화에 긴 리드타임이 걸리는 것도 부담이고, 독자적으로 기술 개발을 해야하는 것도 부담이고, 소프트웨어 생태계를 구축해야하는 것도 부담이고.. 이 외에도 굉장히 많은 부담을 안겨줍니다. 그렇지만 이는 저에게는 좋은 기회라고 생각합니다. ARM이 로얄티를 파격세일 하지 않는 이상, 다양한 도메인에 fit하게 resource를 최적화해주는 가속기는 도메인마다 다양한 방식으로 발전할 것 같았기 때문이죠. 모르겠고 아무튼 RISC-V 화이팅!!!
Processor
Single Cycle
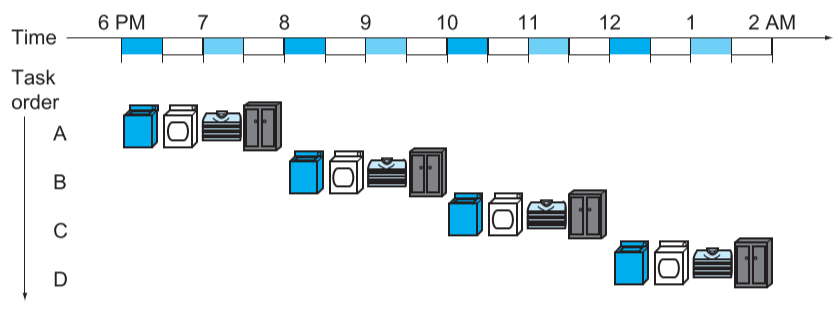 시간별로 한 모듈밖에 돌아가지 않아 굉장히 오래 걸립니다. 단일 사이클 설계를 쉽게 보여주는 예시입니다.
단일 사이클 설계은 참으로 비효율적인 녀석입니다. CPU는 BCLK를 기반으로 내부 클록을 생성하여 작동하는데, 단일 사이클 방식은 한 클록 안에 명령어의 전 과정($IF \rightarrow WB$)을 모두 마쳐야 합니다. 결국 전체 시스템의 클록 주기($T_c$)를 가장 지연 시간이 긴 명령어인 lw의 critical path에 맞춰야만 합니다.
이는 컴퓨터 아키텍처의 황금률 ‘자주 발생하는 케이스를 빠르게 처리하라’ 원칙에 정면으로 위배됩니다. 가벼운 add 연산조차 무거운 lw가 앞에 있으면 끝날 때까지 기다려야 하기 때문이죠. 그래서 현대 프로세서에서는 단계마다 데이터를 유지?(Latch)하며 격리하는 파이프라이닝(Pipelining)을 통해 클록 주기를 극단적으로 끌어올려 사용합니다.
Pipelining
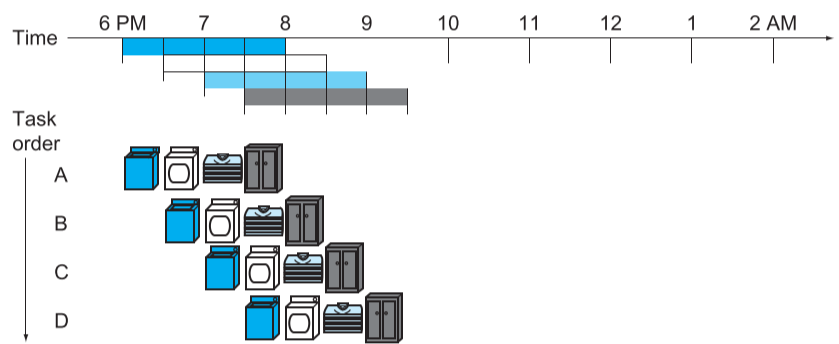 아주 효율적이죠? 모든 부품들이 쉴 새 없이 돌아갑니다.
파이프라이닝은 파이프라인 레지스터를 경계로 명령어 실행 단계를 여러 단계로 분할하는 설계 기법입니다. 각 단계 사이에 벽(Pipeline Register)을 세워 데이터 흐름을 격리함으로써, 하나의 명령어가 끝나기 전이라도 다음 명령어를 즉시 투입하여 하드웨어 자원이 쉬지 않고 가동되게 합니다.
이는 전체 Critical Path를 짧게 쪼개기 때문에 클록 주기를 획기적으로 단축할 수 있으며, 결과적으로 Throughput을 극대화하여 단일 사이클 설계의 구조적 비효율을 해결합니다.
하지만 여러 명령어가 동시에 실행되는 특성상 앞뒤 명령어 간의 간섭으로 인해 실행이 지연되는 장애물이 발생하는데 이를 Hazard라고 하며, Structure Hazard, Data Hazard, Control Hazard로 분류됩니다.
💡RISC-V의 3가지 핵심 장점
1. 명령어 길이의 규칙성: 모든 기본 RISC-V 명령어는 4바이트로 고정되어 있습니다. 명령어의 경계가 명확하기 때문에 하드웨어가 IF(Instruction Fetch)와 ID(Instruction Decoding) 단계를 훨씬 단순하고 빠르게 처리할 수 있습니다.
2. 필드 위치의 일관성: 명령어 형식의 종류가 적을 뿐만 아니라, 첫번째 소스 레지스터(
rs1)와 목적 레지스터(rd)의 위치가 항상 고정되어 있습니다. 덕분에 제어 장치가 명령어를 완전히 해독하기도 전에 미리 레지스터 값을 읽어올 수 있어 성능이 최적화됩니다.3. 연산과 메모리 접근의 철저한 분리: RISC-V는 모든 연산은 레지스터에서만 수행하고, 메모리 접근은
Load/Store명령어로 격리합니다. 이를 통해 값비싼 메모리 지연이 시스템 성능을 저하시키는 것을 방지합니다.
x86-64 아키텍처는 가변길이 명령어의 고질적인 Decoding 병목&전력 소모를 해결하기 위해, 한 번 변환된 명령어 조각들을
μOps Cache에 저장합니다. 이는 파이프라이닝, 비순차 실행(OoOE, Out of Order Execution), 슈퍼스칼라 구조를 RISC-V와 유사한 수준의 효율로 구현할 수 있게 만들어주지만μOps에서 발생하는 물리적인 전력 낭비와 추가적인 Latency 문제에서 자유롭지 못하고, 이 점은 x86 아키텍쳐 대비 RISC 아키텍쳐가 가지는 매우 중요한 장점입니다.
Structural Hazard
Structural Hazard는 하드웨어 자원(Resource)의 종속성으로 인해 발생합니다. 서로 다른 두 명령어가 동시에 하드웨어 부품을 사용하려고 할 때 발생하죠. 그런데 RISC-V ISA가 처음부터 파이프라이닝을 위해 설계한 것이기 때문에 Structural Hazard는 다른 Hazard에 비해 비교적 피하기 어렵지 않습니다.
Data Hazard
파이프라이닝은 여러 명령어를 겹쳐서 실행하기 때문에, 논리적인 실행 순서와 물리적인 데이터 완성 시점 사이에 괴리가 생기기 쉽습니다. Data Hazard는 파이프라인에서 앞선 명령어의 결과값이 아직 준비되지 않았음에도 불구하고, 다음 명령어가 해당 값을 사용하려 할 때 발생하는 데이터 종속성 문제입니다.
Data Hazard의 해결 구조는 크게 두 가지 파트로 나누어 보면 이해하기 쉽습니다. 첫째는 데이터 경로를 틀어주는 Forwarding Unit이고, 둘째는 데이터가 준비되지 않아 Forwarding만으로는 해결할 수 없을 때(Load-Use, 메모리에서 레지스터로 데이터를 복사하기 전 해당 레지스터를 사용하려고 시도하는 경우) nop을 삽입하여 Stall을 거는 Hazard Detection Unit입니다
Forwarding
Fowarding은 앞선 명령어에서 ALU - 레지스터/메모리 구간에 있는 데이터를 조금 빨리 땡겨쓰는 기법입니다. 정확히 아래의 조건을 만족하는 경우 Fowarding Unit이 동작합니다.
Fowarding 의 동작 조건
- EX/MEM.RegisterRd = ID/EX.RegisterRs1
- EX/MEM.RegisterRd = ID/EX.RegisterRs2
- MEM/WB.RegisterRd = ID/EX.RegisterRs1
- MEM/WB.RegisterRd = ID/EX.RegisterRs2
RegisterRd: ALU 출력 값을 기록할 레지스터의 번호 (5비트 주소, 0~31)
RegisterRs: ALU에 입력값으로 넣어줄 데이터가 저장된 레지스터의 번호 (5비트 주소, 0~31)
그런데 여기 MEM 단계나 WB 단계의 Destination 레지스터가 현재 ALU 단계의 Source 레지스터와 동일한 경우 이중 연산을 막기 위해 WB단계의 Destination 레지스터를 무시하고 MEM단계의 Destination 레지스터를 Source 레지스터로 넣어야합니다. 해당 로직을 포함하여 Fowarding 로직을 코드로 구현하면 아래와 같습니다.
EX Hazard
1
2
3
4
5
6
7
if (EX/MEM.RegWrite
and (EX/MEM.RegisterRd != 0)
and (EX/MEM.RegisterRd = ID/EX.RegisterRs1)) FowardA = 01

if (EX/MEM.RegWrite
and (EX/MEM.RegisterRd != 0)
and (EX/MEM.RegisterRd = ID/EX.RegisterRs2)) FowardB = 01
MEM Hazard
1
2
3
4
5
6
7
8
9
10
11
12
13
14

+++ 중첩 Fowarding을 막기 위해 전전 결과는 무시하고, 전 결과를 Fowarding하는 제어문

if (MEM/WB.RegWrite
and (MEM/WB.RegisterRd != 0)
+and not (EX/MEM.RegWrite and (EX/MEM.RegisterRd != 0)
+    and (EX/MEM.RegisterRd = ID/EX.RegisterRs1))
and (MEM/WB.RegisterRd = ID/EX.RegisterRs1)) FowardA = 01

if (MEM/WB.RegWrite
and (MEM/WB.RegisterRd != 0)
+and not (EX/MEM.RegWrite and (EX/MEM.RegisterRd != 0)
+    and (EX/MEM.RegisterRd = ID/EX.RegisterRs2))
and (MEM/WB.RegisterRd = ID/EX.RegisterRs2)) FowardB = 01
데이터가 메모리에서 나오는 시점(MEM)이 다음 명령어가 실행하려는 시점(EX보다 늦기 때문에 Load-use data hazard가 발생합니다.
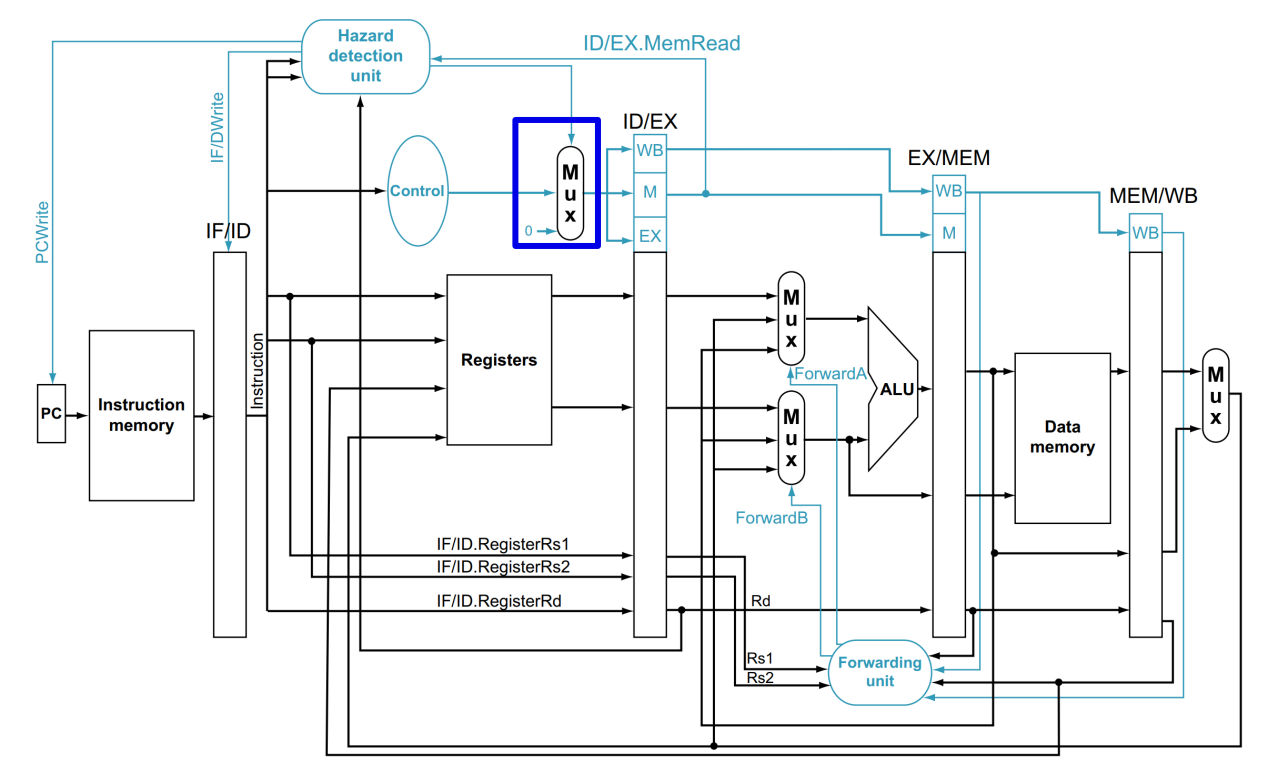
Hazard Detection
앞에서 간단하게 설명했지만, Fowarding Unit이 해결 못하는 경우 중 하나가 Load명령어를 뒤따르는 명령어가 Load명령어에서 쓰기를 행하는 레지스터를 읽으려고 시도하는 경우입니다.
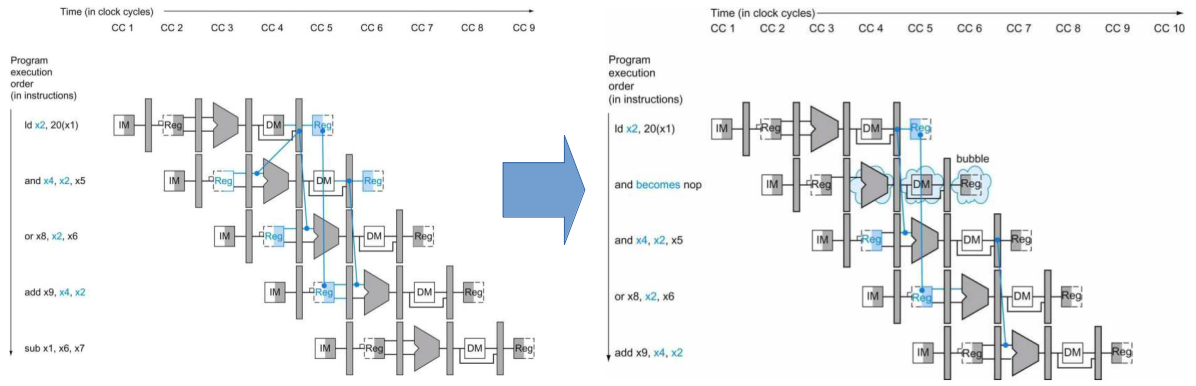
위 그림에서 CC 4에서 Load명령어가 데이터를 읽고 있는데 ALU는 이미 그 다음 명령어를 위한 연산을 수행하고 있죠. 따라서 적재 명령어 뒤에 이 결과값을 읽는 명령어가 뒤따라 나오면 누군가가 파이프라인을 Stall(지연)시켜야 합니다.
그래서 Fowarding Unit외에 Hazard Detection Unit이 필요합니다. 이 유닛은 ID 단계에서 동작하며 적재 명령어와 결과값 사용 명령어 사이에 지여을 추가할 수 있도록 돕죠. 적재 명령어만 검사하면 되므로 Hazaed Detection Unit에 대한 제어는 아래와 같은 단 한가지 조건을 가집니다.
Hazaed Detection Unit
1
2
3
4
if (ID/EX.MemRead and
	((ID/EX.RegisterRd = IF/ID.RegisterRs1) or
	(ID/EX.RegisterRd = IF/ID.RegisterRs2)))
	stall the pipeline
위 Hazard Detection Unit은 CC 3에 작동하며 조건이 만족되면 명령어는 1 clock cycle만큼 지연됩니다. 1 clock cycle stall 후에는 Fowarding Unit이 종속성을 처리할 수 있어 실행은 계속 진행되며, 만약 Fowarding Unit이 없으면 1Cycle 더 Stall됩니다.
위 로직을 적용한 Data Hazard는 아래 그림과 같게 됩니다.
Control Hazard
Data Hazard만큼 자주 일어나지 않지만, Data Hazard의 Fowarding 같은 완벽한 해결책이 없기 때문에 더 복잡해질 수 있습니다.
파이프라인이 계속 일하기 위해서는 매 클럭마다 명령어가 fetch되어야 하는데, 지금의 설계대로라면 branch에 대한 결정이 MEM단계에 이루어집니다. 이렇게 fetch할 명령어를 결정하는 일이 늦어지는 현상을 Control Hazard라고 합니다.
파이프라인이 길어지고 Superscalar 실행에 Dynamic Branch Prediction이 적용되면서 지연 분기는 없어도 그만이 되어버렸습니다.
Always Taken(Static Branch Prediction)
분기가 일어나지 않는다고 가정하고, 일어나면 이전에 발생했던 IF, ID. EX를 Flush해버리는 방식입니다. Load-Use Data Hazard의 경우처럼 기존 제어값을 0으로 바꾸면 되는데, 버려야 하는 명령어가 1개에서 3개로 바뀐 점이 다릅니다.
분기가 일어날 확률이 절반 정도 되고 명령어를 버리는 비용이 거의 없다면 이 최적화 방법은 Control Hazard의 비용을 절반으로 줄입니다.
그러나 파이프라인이 깊어질수록 branch손실이 증가하고, 현대 프로세서에서 표준이 된 Superscalar방식에서 큰 복잡성을 만들고 branch손실을 증가시킬 수 있습니다.
Dynamic Branch Prediction
90년대 초에는 dynamic branch predicton이 너무 많은 자원을 차지하여 고성능 컴퓨터에서도 쓰이지 않았습니다. 그러나 트랜지스터 수가 계속 증가되고 논리 회로가 메모리보다 훨씬 더 빨라지면서 Multiple Functional Unit을 칩 안에 더 때려박을 수 있게되었고 결과적으로 Multiple Issue와 Dynamic Branch Prediction을 사용할 수 있게 되었죠
코어 내부에 SRAM기반 Branch Prediction Buff구성하여 만들어 이 명령어가 이전에 branch여부를 조사합니다. 1Bit Prediction 은 연속된 branch속에서 한 번 branch하지 않으면 2번 예측에 실패하는 단점이 있는데, 이 같은 약점을 보완하기 위해 두번 연속 예측에 실패해야 Buffer Data가 바뀌는 2Bit Prediction이 있습니다.
이 외에도 Correlating Predictor, Tournament Predictor가 있는데.. 프로세서의 성격에 맞춰서 사용됩니다.
위 방식대로 진행할 경우, 분기 목적지 계산에 1 Cycle이 사용되는데, 이는 BTB를 사용하여 해결할 수 있습니다.
RISC-V에서는
Conditional Branch명령어를 줄이는 방법으로Conditional Move명령어를 사용하는 방법도 있습니다.move명령어는rs1,rs2,rd로 이루어지는데, Buffer를 확인하고 ID/EX.registerRd를 중간에 변경해버리는 방식으로 구현됩니다. 그러나 해당 방식의 ISA를 사용하려면 Zicond(Custom Extension: Conditional Operations)를 추가하거나, 직접 손을 봐야합니다.
Exception
제어에서 가장 어려운 부분이 Exception/Interrupt 구현이라고 합니다. 실제로는 아래 표와 같이 굉장히 다양한 예외가 존재하는데요, 포스팅에서는 정의 안된 명령어의 실행과 하드웨어의 오작동으로 발생하는 예외만 다루겠습니다.
그리고 포스팅에서는 원인이 내부에 있건 외부에 있건 구별 없이 제어 흐름에서의 예기치 못한 변화를 지칭할 때 Exception이라 지칭하고, 사건이 외부적인 요인으로 일어날 경우에만 Interrupt용어를 사용하겠습니다.
| 분류 (명칭) | 발생 원인 (Trigger) | 대표적인 실제 사례 |
|---|---|---|
| Interrupt (Timer Interrupt) | mtime 레지스터 값이 mtimecmp 값보다크거나 같을 때 | OS 스케줄러가 멀티태스킹을 위해 현재 프로세스를 중단하고 Context Switch 하는 경우 |
| Interrupt (External Interrupt) | PLIC(Platform-Level Interrupt Controller)를 통해 외부 장치 신호가 들어올 때 | 키보드 입력, 네트워크 패킷 도착 등 주변 장치가 처리를 요청할 때 |
| Exception (Environment Call) | ECALL 명령어 실행 | 사용자 프로그램이 OS 커널(시스템 콜)을 호출할 때 |
| Exception (Page Fault) | 가상 메모리 변환(Virtual Address Translation) 실패 또는 권한 위반 시 | 메모리에 로드되지 않은 페이지에 접근하거나 (Swap) 읽기 전용 페이지에 쓰기를 시도할 때 |
| Exception (Illegal Instruction) | 디코더가 알 수 없는 Opcode를 만났거나, 권한 없는 CSR에 접근할 때 | 지원하지 않는 확장 명령어를 실행하거나, 손상된 바이너리를 실행할 때 |
CPU가 Exception이나 Interrupt를 감지하면, 하드웨어 레벨에서 즉시 문제가 발생한 명령어의 주소를 sepc(Supervisor Exception Program Counter) 레지스터에 저장하고, 그 원인을 scause(Supervisor Exception Cause) 레지스터에 원인을 기록합니다.
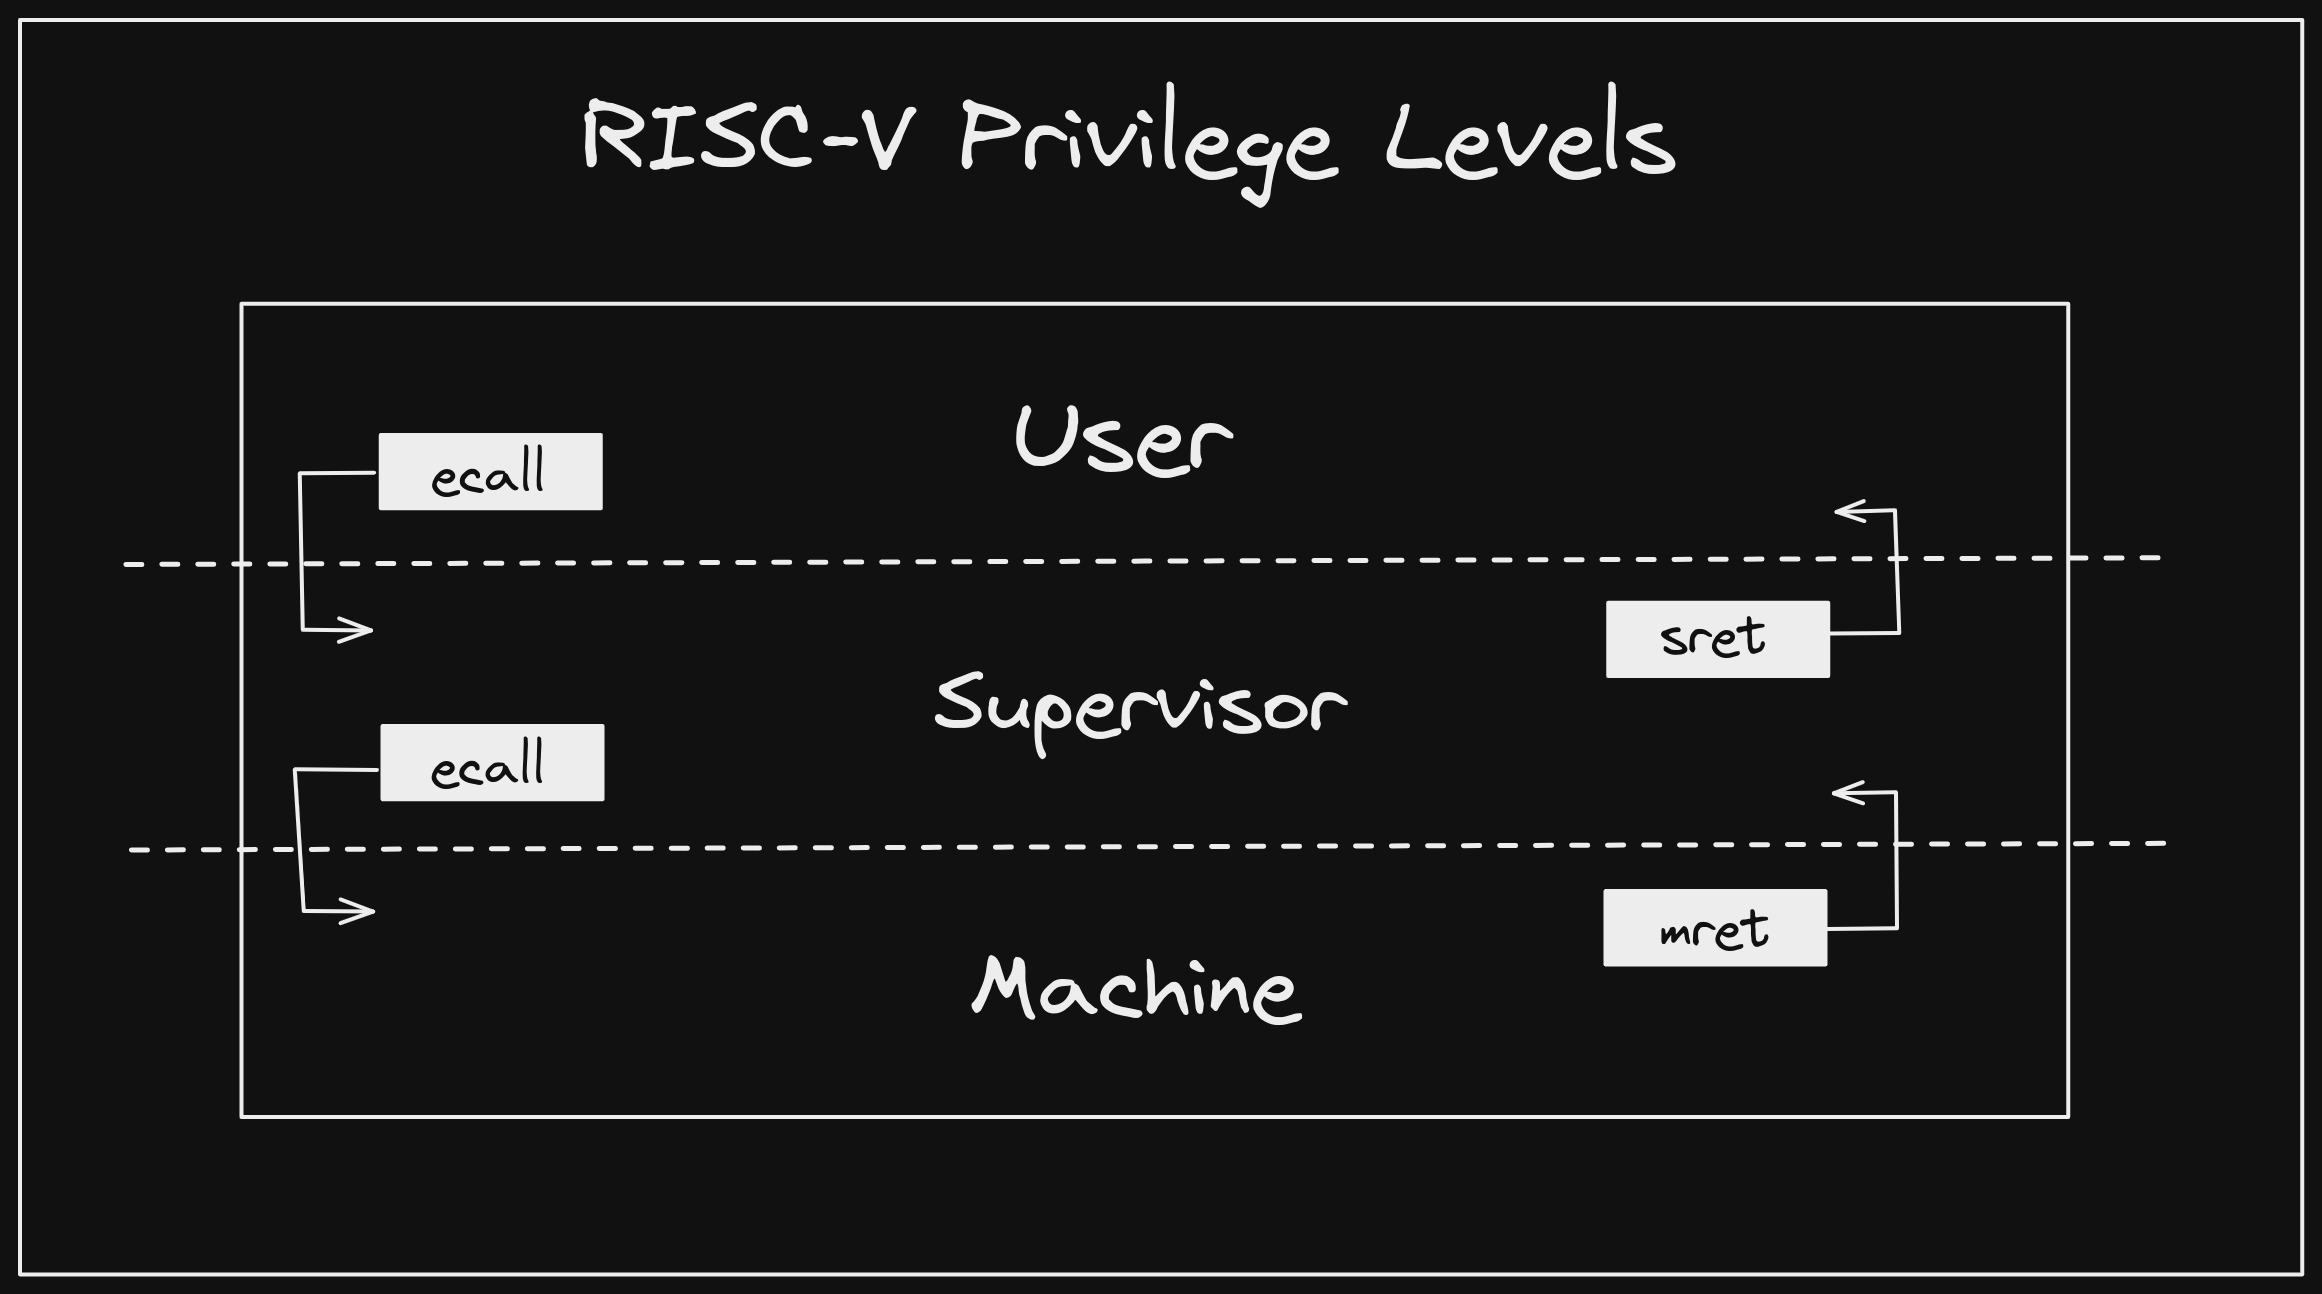
그리고 CPU는 현재 Privilege 를 U-Mode(User Mode)에서 S-Mode(Supervisor Mode)로 변경함과 동시에, stvec 값을 보고 PC를 변경합니다.
\[\text{New PC} = (\text{stvec} \ \& \ \text{0xFFFFFFFC}) + (\text{SCAUSE.Exception Code} \times 4)\]
stvec Mode 0:
\[\text{New PC} = (\text{stvec} \ \& \ \text{0xFFFFFFFC})\]Base Modestvec Mode 1:
Vectored Interrupt Mode
그러면 PC에 따른 OS trap handler가 실행되고, OS는 역할을 다한 뒤 sret 명령어를 실행합니다. 이때 하드웨어는 SEPC 값을 PC로 복구함과 동시에, 저장해뒀던 이전 상태를 확인하여 Privilege를 다시 U-Mode로 변경해줍니다
이 과정에서 함수는 반드시 4 byte로 정렬(Alignment) 되어야 합니다(aligned(4)). 이는
stvec가 하위 2비트를Mode Flag로 사용하기 때문입니다.
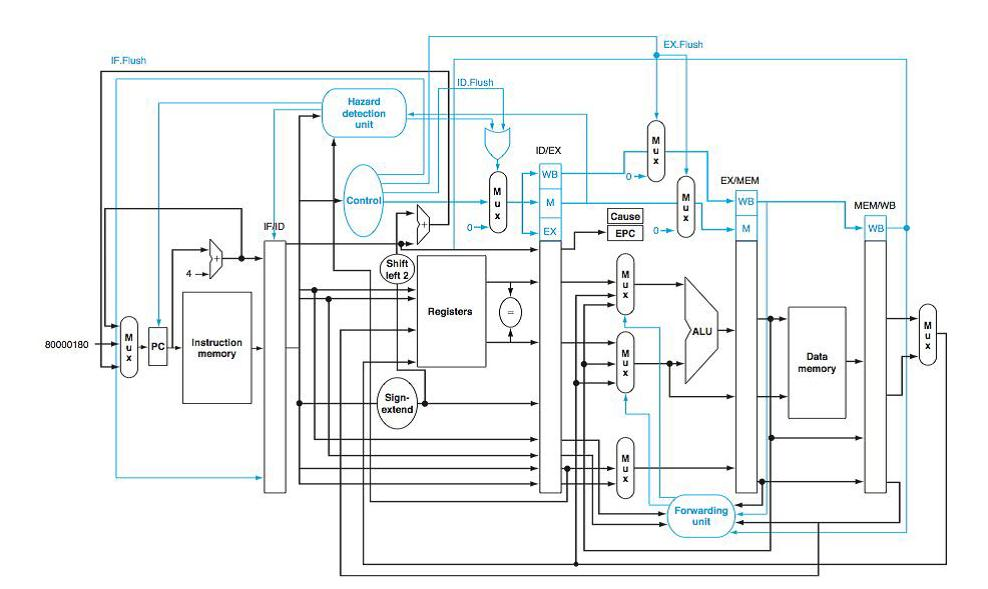
Exception을 고려한 pipelined datapath은 위와 같습니다. 사실 기능적으로는 Load-Use와 거의 동일합니다.
기능적으로 동일함에도
MUX에 제어선을 추가로 연결하지 않은 이유는 제어 신호의 bit width만큼MUX를 확장하는 것보다OR Gate를 추가하는 것이 비용적인 측면에서 훨씬 저렴하기 때문입니다.
Parallelism
파이프라이닝은 명령어들 사이에 병렬성을 이용하며 이를 ILP(Instruction-Level Parallelism)라고 합니다.
ILP 양을 증가시키는 방법은 다음과 같습니다.
- 파이프라인의 깊이를 중가시키기
- Multiple Issue
Multiple Issue는Static Multiple Issue와 Dynamic Multiple Issue로 구분되며 아래 두가지 기본적인 문제를 해결해야 합니다.
Issue Slot: 프로세서의 적정IPC와 어떤 명령어들을 내보낼 것인가Data/Control Hazard:Hazard를 어떻게 제어할 것인가
Static Multiple Issue - VLIW(Very Long Instruction Word)
Static Multiple Issue 프로세서의 핵심은 하드웨어가 하던 명령어 종속성 판단을 컴파일러가 대신 처리하는 것입니다. 컴파일러는 실행 시점에 충돌이 없는 명령어들을 미리 골라 하나의 묶음으로 만드는데, 이를 Issue Packet이라고 부릅니다.
VLIW(Very Long Instruction Word)는 이러한 방식을 극대화한 구조입니다. 하드웨어에서 복잡한 스케줄링 회로를 제거해 전력 효율과 칩 면적을 최적화할 수 있다는 강력한 장점이 있습니다.
하지만 이론적인 최대 성능을 내기 위해서는 컴파일러가 빈 Issue slot 없이 패킷을 꽉 채워야 하므로, 실질 IPC(클럭당 명령어 처리 수)가 전적으로 컴파일러의 역량에 의존하게 됩니다. VLIW구조는 컴파일러가 올바르게 스케줄링 하지 않으면 슬롯에 nop이 채워지며 낭비를 야기합니다. 이러한 구조적 경직성과 하드웨어 세대 간의 호환성 문제로 인해, VLIW는 범용 컴퓨터보다는 특정 계산 특화된 프로세서에 주로 사용됩니다.
Dynamic Multiple Issue - Superscalar
Superscalar는 Issue Packed하지 않고 명령어를 순차적으로 내보내며, 컴파일러의 스케줄 여부와 관계 없이 하드웨어에 의해 올바르게 실행되도록 보장받습니다. 이러한 특징으로 인해 VLIW와 다르게 다른 프로세서에서 실행할 때 재컴파일이 필요 없다는 장점이 있습니다.
많은 superscalar 프로세서는 Multiple Issue를 결정하는 기본 틀을 확장하여 Dynamic Pipeline scheduling을 구성합니다. Dynamic Pipeline scheduling은 매 클럭 사이클마다 Hazard로 인한 지연을 최소화할 수 있는 명령어들을 실시간으로 선택하며, 그 과정에서 지연을 피하기 위해 명령어들을 재정렬하기도 합니다.
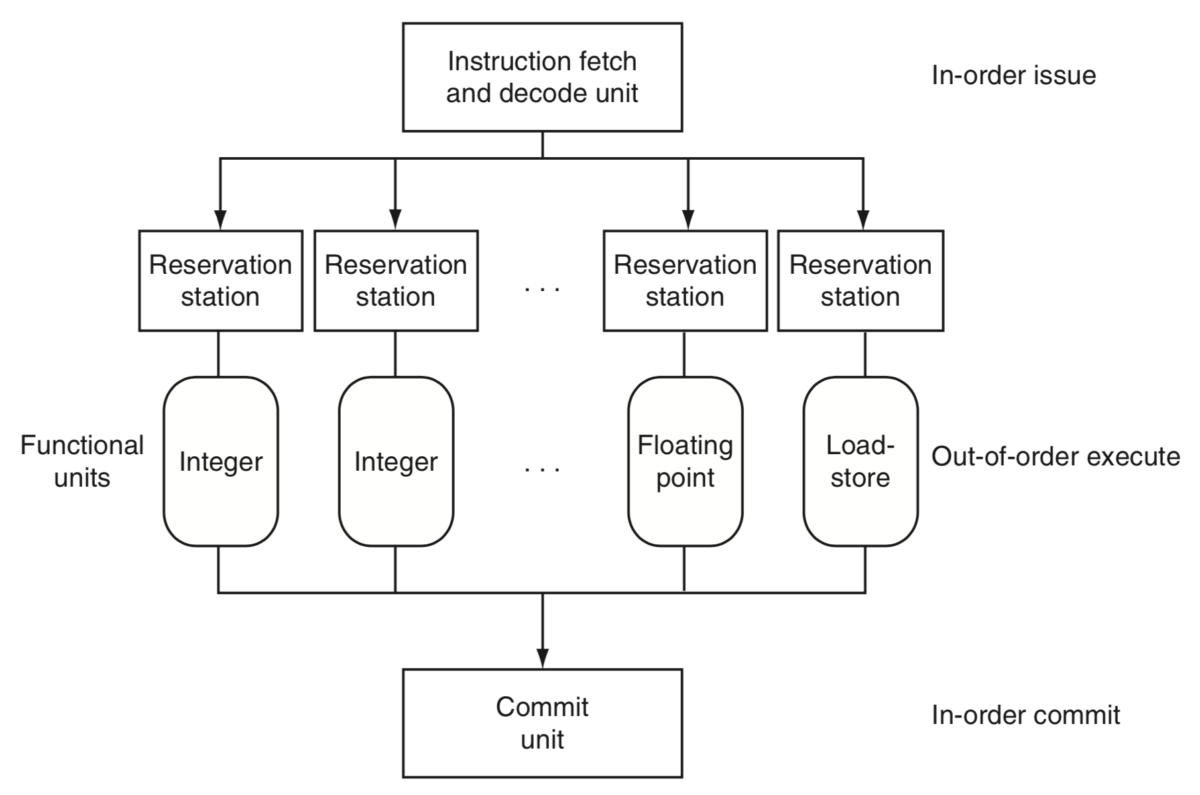 이러한 프로세서의 파이프라인은
Instruction Fetch and Decode Unit, Multiple Functional Units, 그리고 Commit Unit 세 가지 주요 부분으로 구성됩니다.
해독된 명령어는 Reservation Station(RS) 버퍼에 저장되며, 이때 데이터는 Opcode, Operand의 값(V field) 또는 태그(Q field), 그리고 목적지 정보(rd) 등으로 구성됩니다. 이 과정에서 실제 레지스터 번호 대신 RS의 태그를 사용하여, 실제 데이터와 상관없이 레지스터 이름이 겹쳐 발생하는 가짜 종속성(WAR, WAW)을 제거합니다.
Functional Unit에서 비순차적으로 계산이 완료되면, 결과값은 ROB(Reorder Buffer)에 임시 저장됩니다. 이후 ROB는 정적 스케줄링의 Forwarding과 유사하게, 해당 결과를 기다리는 다른 명령어들에 데이터를 즉시 제공함과 동시에 최종적으로 결과를 순차적으로 Commit합니다.
RS를 통한 Operand 버퍼링과 ROB를 통한 결과값 임시 저장은 가짜 종속성을 해결하여 비순차실행을 가능케 하는 Register Renaming의 대표적 구현 방식입니다. 컴파일러의 Loop Unrolling 역시 소프트웨어 단에서 이름을 분산시켜 종속성을 끊어내는 점에서 Register Renaming에 속하게 됩니다.
RAW의 경우 데이터가 필요한 진종속성이므로 레지스터 재명명으로 해결 불가능하고
Data Fowarding이나Stall로 해결해야 합니다.
Memory Hierarchy
메모리 계층 구조는 제한된 비용 내에서, 사용자에게 가장 빠른 메모리의 접근 속도와 충분한 용량을 동시에 제공하는 것을 목표로 합니다.
그러한 최적화를 위한 모든 기술에는 지역성의 원칙이 적용됩니다.
- 시간적 지역성(Temporal Locality) : 한번 참조된 항목은 곧바로 다시 참조되는 경향
- 공간적 지역성(Spatial Locality) : 어떤 항목이 참조되면 그 근처에 있는 다른 항목들이 곧바로 참조될 가능성이 높다
프로그램에서의 지역성은 단순하고도 자연스러운 프로그램 구조에서 나오는데요, 순환문과 순차접근에서 이와 같은 특성을 볼 수 있습니다. 이러한 특성들을 잘 살려 성능을 최적화 하기 위해 현대 메모리 시스템은 Hierarchy(계층구조)를 사용합니다.
메모리 계층구조는 여러 계층으로 구성되지만, 데이터는 인접한 두 계층 사이에서만 한 번에 복사됩니다. 이 두 계층 간 정보 전송의 최소 단위를 Block/Line이라고 부릅니다. 그리고 프로세서가 요구한 데이터가 상위 계층의 어떤 블록에 있을 때 이를 Hit 이라고 부릅니다. 그리고 상위 계층에서 찾을 수 없다면 Miss라고 부르죠. 위 표현들은 자주 사용되니 반드시 알고있어야 합니다.
Cache Architecture
SRAM
하드웨어의 물리적 구현 방식에 대해서 꼭 알아야 하는 것은 아니지만, 알아두면 참 좋습니다. 캐시 아키텍처의 대부분을 담당하는 SRAM의 Memory chip 구조는 아래와 같습니다.
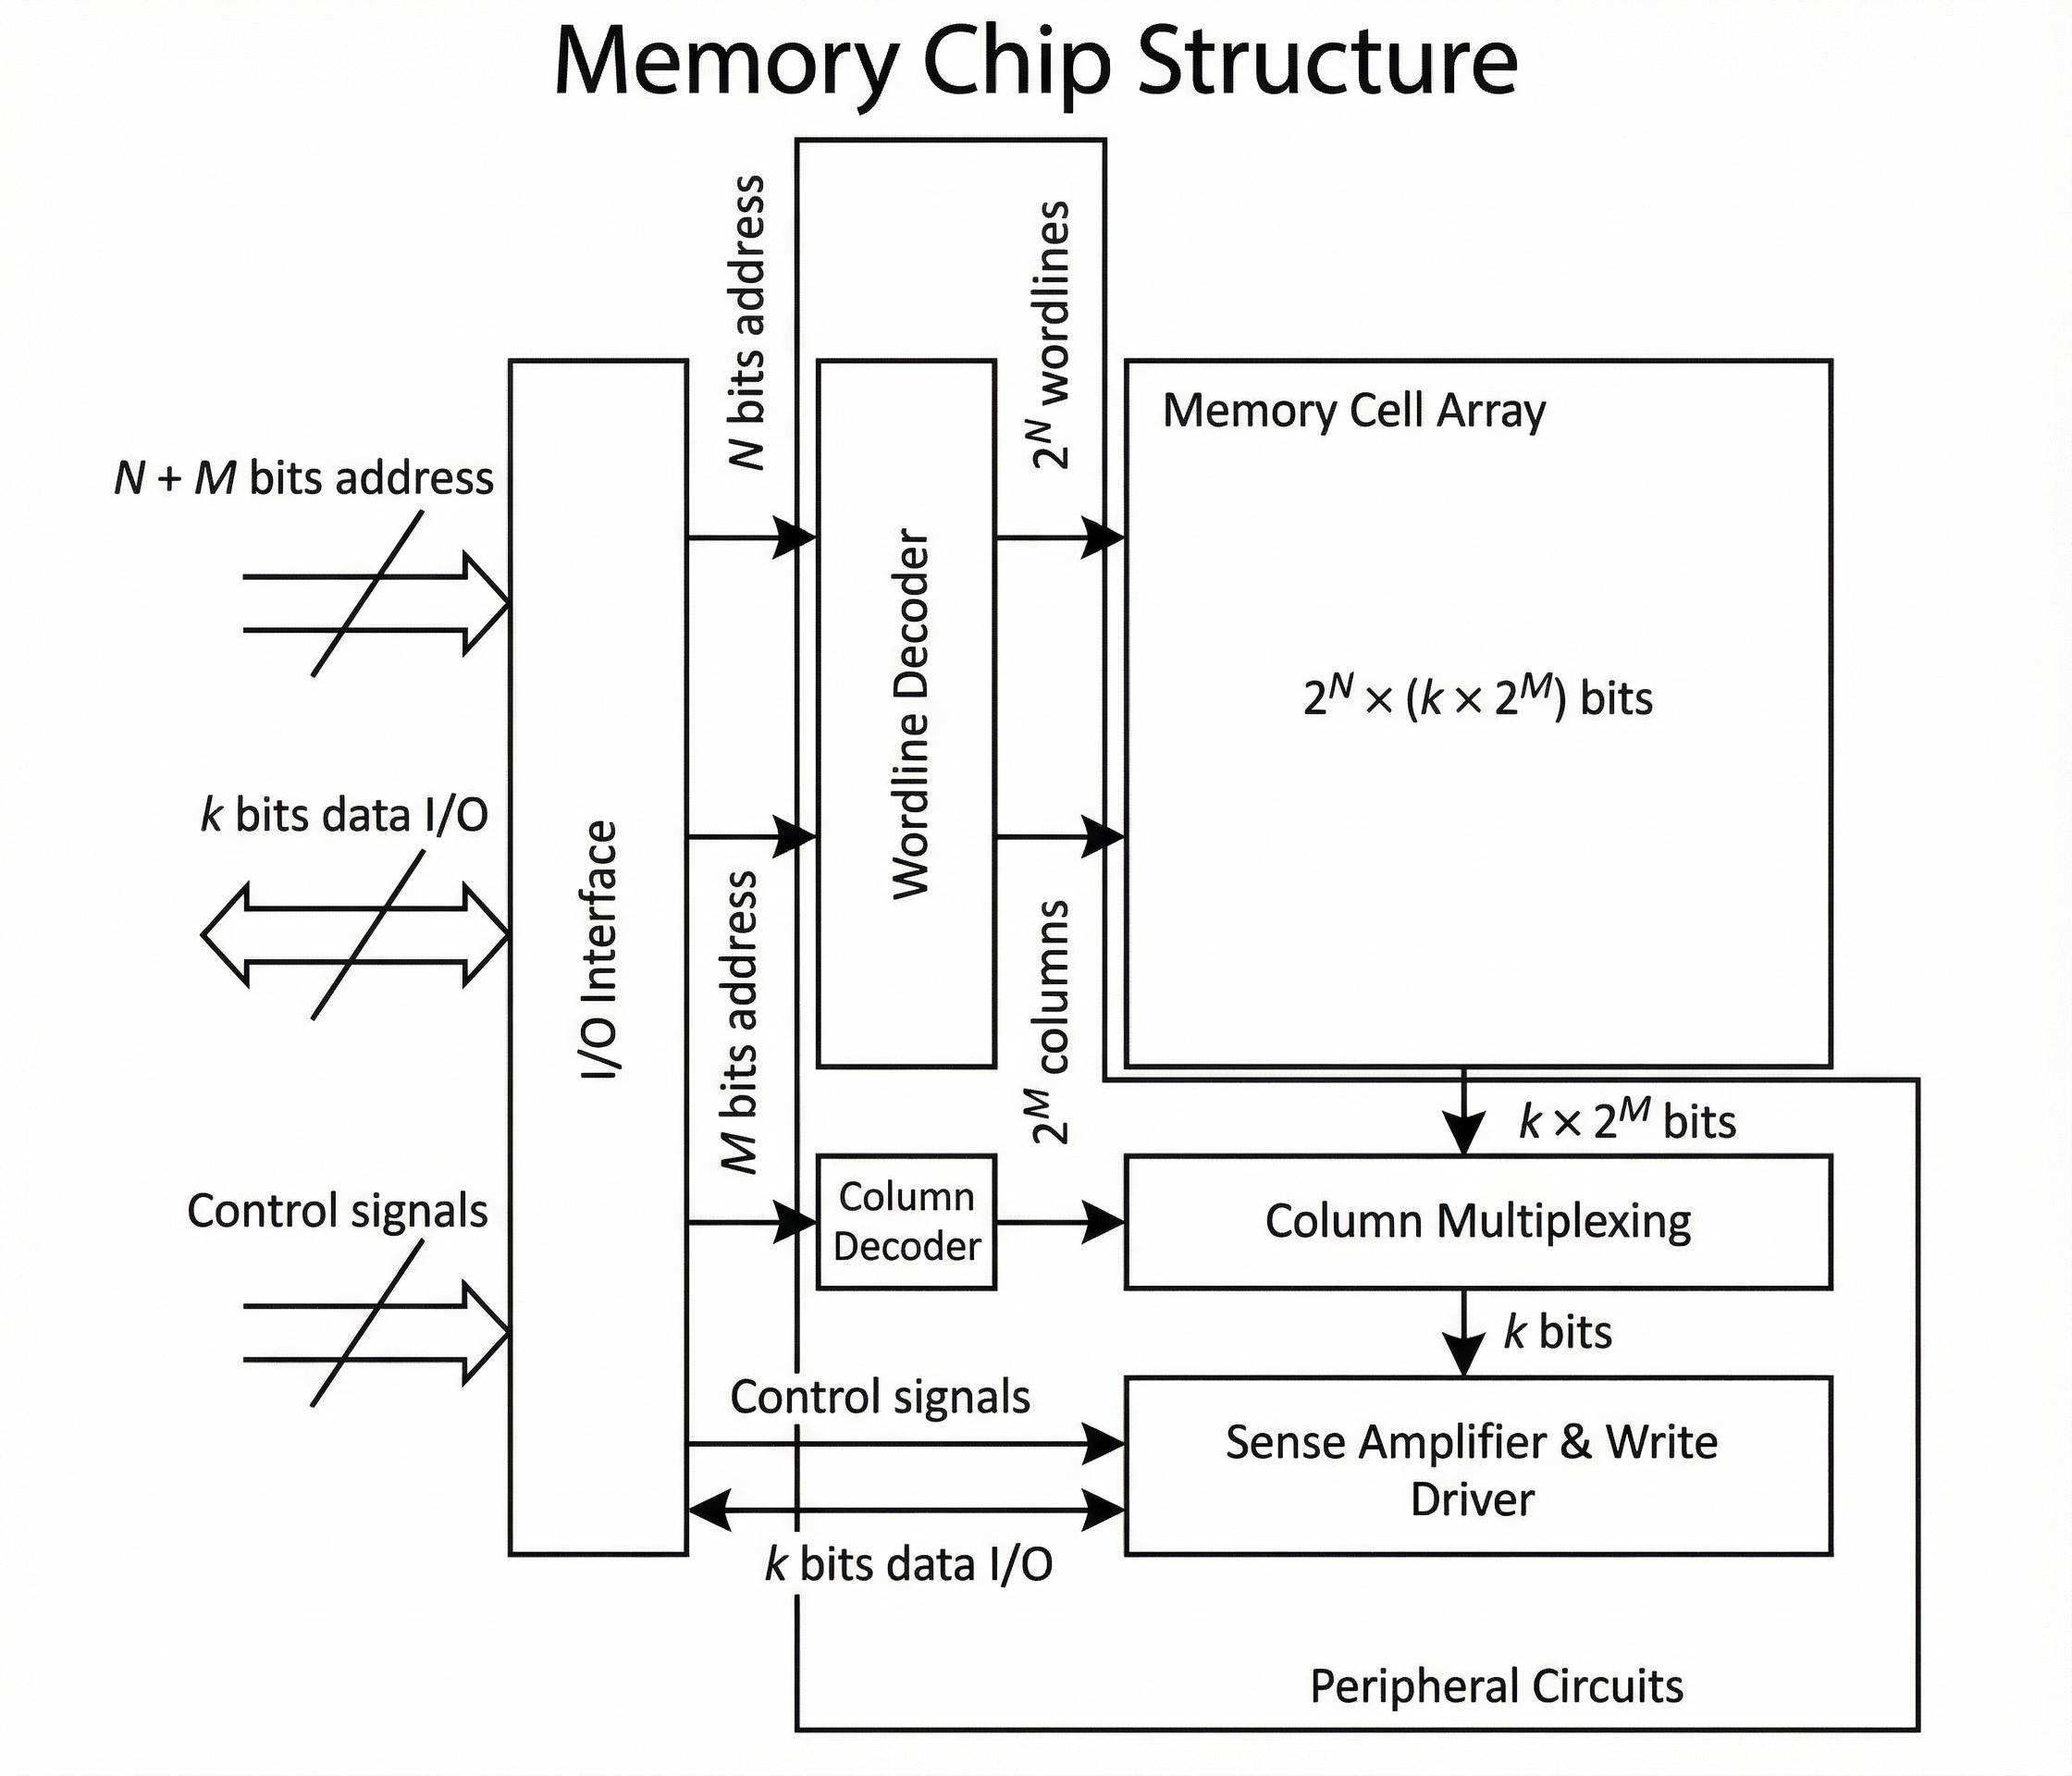 위 그림에서와 같이, RAM(Random Acess Memory)은 WL과 BL을 통해 원하는 주소값에 해당하는 Cell에 접근할 수 있습니다.
Word Line(WL)과 Bit Line(BL)이 교차 인가되는 Selected Cell에서 저장하는 Bit 크기 에 따라 SLC(Single Level Cell), MLC(Multie Level Cell)로 구분할 수 있는데, 본 포스팅에서는 SRAM이 SLC라고 가정하겠습니다.
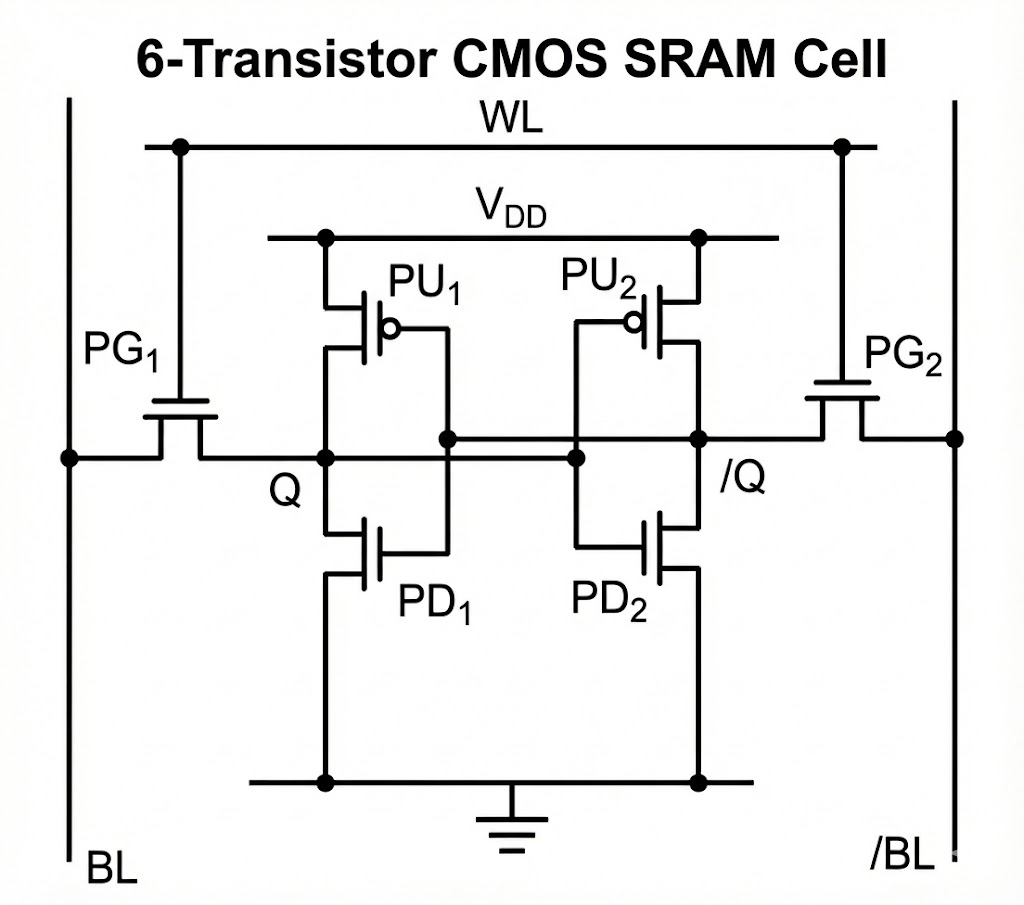
먼저 SRAM에 대해 쉽게 이해해보자면 INV 두개가 맞물린 구조입니다. Q라는 노드에 0이 저장되어있으면 INV를 통해 /Q의 값은 1로 계속해서 유지됩니다. 따라서 Q와 /Q의 순환에 의해 데이터가 바뀌지 않고 안정적으로 유지되죠. 전력이 공급되는 한 신호의 입력 논리가 유지되는 성질로 인해 전하 누출로 인한 refresh가 필요하지 않기 때문에 Static RAM이라고 불립니다.
Basic of Cash - Direct Mapped
Cache는 Byte 보다 큰 chunk인 block 단위로 접근합니다. 실제로 Cache Block은 4~8 word로 구성되며 프로세서도 한번에 4~8 word를 필요로 하지만, 본 목차에서는 프로세서가 한 순간 필요로 하는 데이터는 1 word이고, block 또한 1 word로 이루어진 아주 단순한 캐시로 가정하고 설명을 진행합니다.
캐시 시나리오에서는 아래 두가지 의문이 필요합니다.
- 데이터가 캐시내에 있는지 어떻게 알 수 있는가?
- 알 수 있다면 어떻게 찾을 수 있는가?
만약 각 word가 캐시 내의 딱 한 장소에만 있을 수 있다면 word가 캐시 내에 있는지 없는지를 바로 알 수 있습니다. 각 메모리 워드에 캐시 내의 위치를 할당하는 가장 간단한 방법은 그 워드의 메모리 주소를 이용하는 것으로, 이러한 캐시 구조를 메모리 위치가 캐시 내의 딱 한 장소로 Mapped되기 때문에 Direct Mapped 이라고 부릅니다.
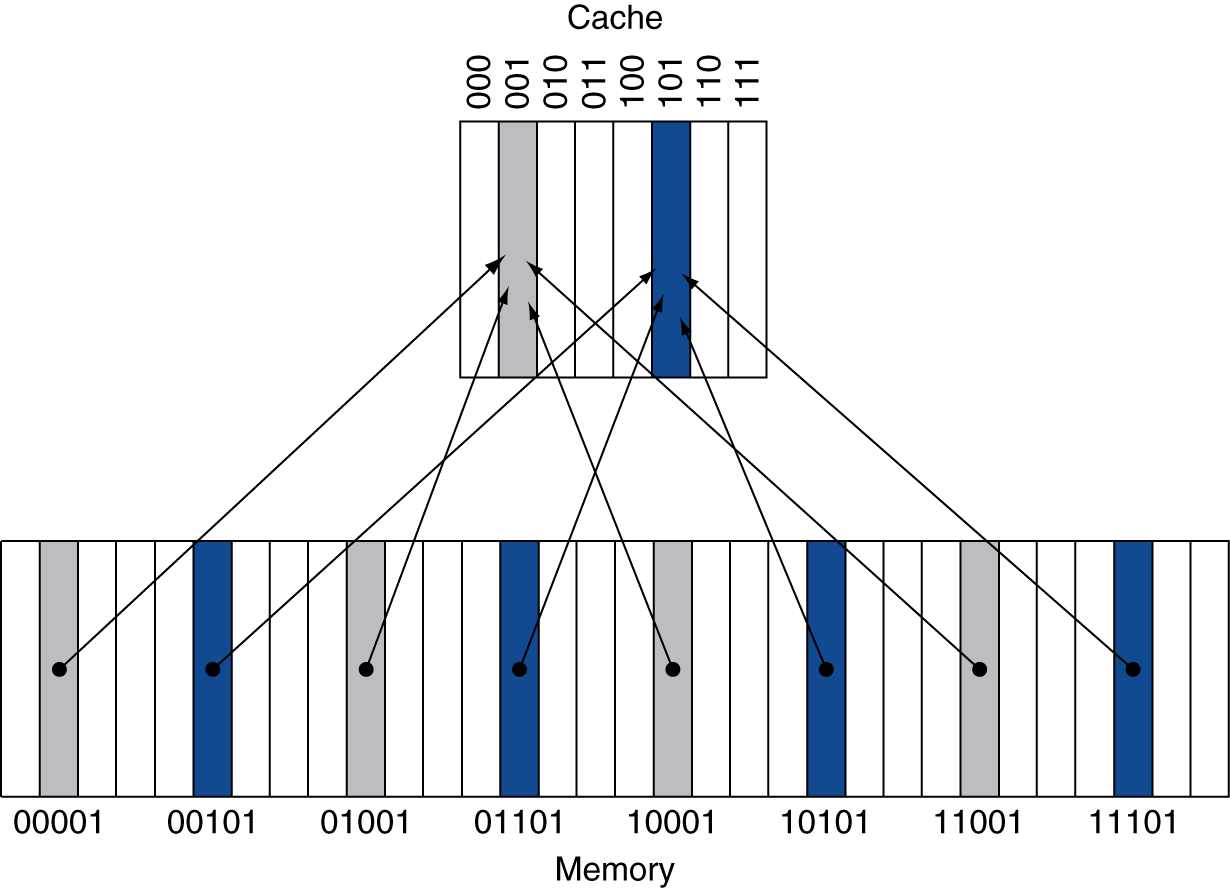
그리고 거의 모든 Direct Mapped Cache는 아래의 Mapped 방식으로 Cache Block을 찾습니다.
이러한 방식으로 매핑할 경우 서로 다른 메모리 주소들이 하나의 Cache Index를 공유하게 되어, 특정 시점에 캐시에 들어있는 주소가 내가 찾는 주소인지 확인할 길이 없습니다. 따라서 tag field에 MOD 연산으로 생략된 상위 비트를 기록하여 주소를 식별합니다.
컴퓨터 부팅 직후나 SRAM 초기화 시점에는 캐시 내부에 의미 없는 쓰레기 값이 저장되어 있습니다. 이때 valid bit가 없다면, 초기화 직후 캐시 접근 시 쓰레기 값을 유효한 데이터로 오인하는 False Hit이 발생하거나, 잘못된 태그 비교로 인해 불필요한 메모리 접근이 발생하게 됩니다. 따라서 valid bit를 통해 해당 라인의 데이터가 실제로 유효한지 확인하는 과정이 반드시 필요합니다.
특정 패턴의 주소(예: 하위 비트가 항상 001인 주소)만 반복해서 사용한다면 캐시의 다른 공간(000, 010 등)이 비게 되는 것은 Direct Mapped의 Conflict Miss 문제이므로 어쩔 수 없습니다.
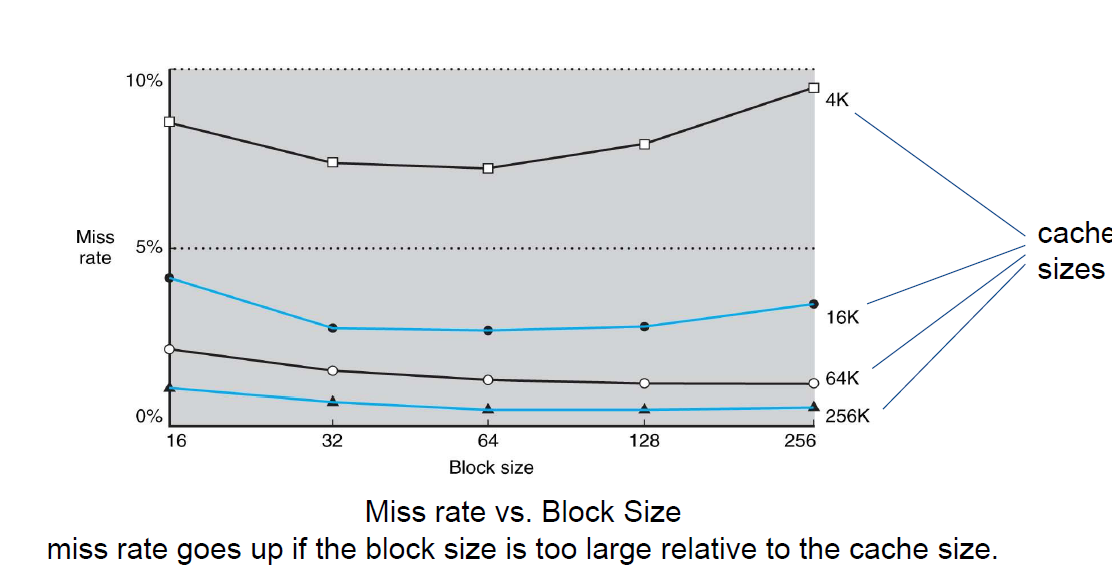
블록이 크면 공간적 지역성을 더 잘 활용해서 실패율이 낮아집니다. 위 그림에서 보인 것처럼 Block Size를 늘리면 대개 Miss rate이 줄어들죠. 하지만 Block Size가 너무 커서 블록 하나가 캐시의 상당 부분을 차지하게 되면 캐시 내의 블록 개수가 너무 적어 블록에 대한 경쟁이 심해지기 때문에 실패율이 오히려 커질 수 있습니다. 그런데 이보다 더 심각한 문제는 Miss Penalty의 증가입니다.
\[\text{Miss Penalty} = \text{Acess Latency} + \text{Tranfer Time}\]Miss Penayty는 메모리 계층구조의 다음 하위 계층에서 블록을 가져와서 캐시에 적재하는 데 걸리는 시간에 의해 결정됩니다. 그런데 메모리 시스템이 바뀌지 않는 한 블록 크기가 늘어나면 늘어날수록 Transfer Time에 따라서 Miss Rate이 증가합니다. 결과적으로 블록이 너무 커지면 Miss Penalty의 증가가 Miss rate reduction을 압도하게 되고 캐시 성능이 감소하는 것이죠.
물론 큰 블록을 보다 효율적으로 전송할 수 있게 메모리를 설계한다면 블록의 크기를 크게 할 수 있고 캐시의 성능 또한 더 개선할 수 있습니다.
Optimizing Cache Performance
지금까지는 메모리 블록을 캐시에 넣을 때 각 블록이 캐시의 딱 한 곳에만 들어갈 수 있는 단순한 Direct Mapped 방법을 사용했습니다. 하지만 실제로는 TLB 블록을 배치하는 다양한 방식이 존재하는데, 그 중 중요한 방식이 Set Associative(집합 연관)방식입니다.
Set Associative
사실 모든 블록 배치 방식은
Associativity구조의 변형입니다.Direct Mapped는1-way Associative이고,Fully Associative는N(cash size)-way Associative방식이니까요.
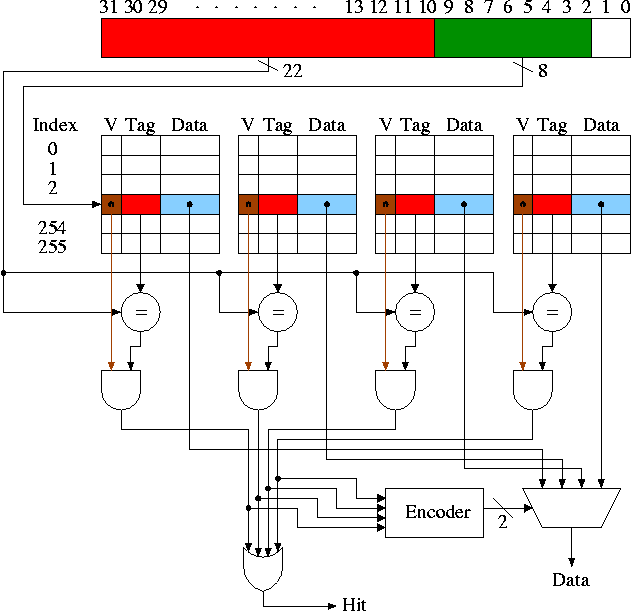
위 방식은 가장 기본적인 형태로 구현한 4-way set associative입니다. 4개의 원소 중 하나를 선택해야하기 때문에 4:1 Mux와 4개의 comparator가 필요합니다. 결국 아키텍쳐 설계자는 추가로 필요한 Comparator의 비용과 집합의 원소들을 비교/선택하는 데 걸리는 시간 지연을 고려하여 최선의 선택을 내려야합니다.
그리고 Set Associative방식에서는 집합에서 교체할 블록을 선택하는 과정에서 어떤 블록을 선택할 것인지 교칙이 필요합니다.이 중 가장 널리 사용되는건 LRU(Least Recently Used)방식으로 가장 오랫동안 사용되지 않는 블록을 교체하는 방식이죠.
캐시의 연관성(Associativity)이 높아질수록 엄격한
LRU(Least Recently Used)알고리즘을 하드웨어로 구현하는 데 따르는 비용과 복잡성이 급격히 증가합니다. 이러한 제약을 극복하기 위해 구현이 상대적으로 간편한randomized marking algorithm이 대안으로 사용되기도 합니다.이 알고리즘은 캐시 크기가 충분히 커질 경우 캐시 실패율이
LRU와 근사한 수준으로 수렴하면서도, 하드웨어 구현 비용은 훨씬 저렴하다는 장점이 있습니다. 다만 Virtual Memory와 같이 Page Fault의 비용이 극심하여 아주 작은 실패율 감소조차 시스템 전체 성능에 결정적인 영향을 미치는 영역에서는 타협 없이 LRU 또는 그에 준하는 정밀한 알고리즘을 고수하는 경향을 보입니다.
Blocking
Blocking Algorithm은 Matrix를 행과 열 단위로 처리하지 않고 subMatrix 또는 Block단위로 처리합니다. 캐시에 적재된 데이터가 교체되기 전에 최대한 뽕뽑고 버리자, 즉 시간적 지역성(Temporal Locality)를 향상시키는게 목표죠.
간단한 행열에서의 내적 구현을 한번 보겠습니다.
위 방식은 naive한 DGEMM 구현입니다. 이와 같은 방식으로 진행하면 캐시의 시간적 지역성에서 큰 이점을 누리지 못합니다. 최악의 경우 $N^3$연산에서 $2N^3 + N^2$메모리 워드 접근이 발생합니다.
아래는 위에서 구현한 기능을 dgemm에 inline하고, blocking을 추가하여 시간적 지역성을 챙기려고 노력한 DGEMM 구현입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
#define BLOCKSIZE 3

/*
 * do_block: Naive DGEMM Simulation 기능적으로 완전히 동일
*/
inline void do_block(int n, int si, int sj, int sk, double* A, double* B, double* C)
{
    for (int i = si; i < si + BLOCKSIZE; ++i)
        for (int j = sj; j < sj + BLOCKSIZE; ++j)
            double cij = C[i + j * n];
            for (int k = sk; k < sk + BLOCKSIZE; k++){
                // FMA (Fused Multiply-Add) 연산 수행
                cij += A[i + k * n] * B[k + j * n];
            } C[i + j * n] = cij;
}

/**
 * dgemm: 전체 행렬을 BLOCKSIZE 단위로 쪼개어 do_block 호출
*/
void dgemm(int n, double* A, double* B, double* C)
{
    for (int sj = 0; sj < n; sj += BLOCKSIZE)
        for (int si = 0; si < n; si += BLOCKSIZE)
            for (int sk = 0; sk < n; sk += BLOCKSIZE)
                // 작은 타일 단위로 연산을 위임하여 캐시 적중률(Cache Hit)을 극대화
                do_block(n, si, sj, sk, A, B, C);
}
B 블록과 C블록에서 Cach Hit의 차이가 확연히 보이죠? 이러한 Blocing(same asTiling)기법을 사용하면 지역성을 높여 컴퓨팅 성능을 향상시킬 수 있습니다.
위 코드를 gcc Compiler를 통해 최적화 옵션을 적용하여 컴파일하면 Inline이 적용되며 do_block함수의 오버헤드가 제거됩니다. 그리고 Blocing을 통해 메모리 워드 수도$2N^3/BLOCKSIZE + N^2$로 감소하는 효과를 보여줍니다.
A는 공간적 지역성에서 이점을 취하고 B는 시간적 지역성에서 이점을 취하므로, Blocking은 공간과 시간 지역성을 모두 이용하는 최적화 방식입니다. PC와 Matrix Size에 따라 달라지긴 하지만 Blociking시 2배에서 10배 이상까지의 성능 개선을 시킬 수 있다고 합니다.
블로킹의 목적은 캐시 실패를 줄이는 것이지만 레지스터 할당을 돕는데 사용할 수도 있습니다. 블록이 레지스터에 들어갈 수 있을 만큼 BlockSize를 작게 하면 프로그램의
Load/Store횟수를 줄일 수 있어 성능 향상을 만들어낼 수 있습니다.
System Virtual Machinie
Virtual Machine이 Memory Hierarchy에 Mapping되지는 않기에 Virtual Machine를 어떤 카테고리로 분류해야할까 많은 고민을 했습니다. 그랬지만 마땅히 좋은 위치를 찾지 못해 Computer Organization and Design RISC-V 의 분류 카테고리를 그대로 따랐습니다. 아무래도 Virtual Machine의 핵심 중 한가지가 Address Relocation이기에 이러한 분류는 꽤나 괜찮은 것 같습니다.
virtual machine은 개발된지는 꽤나 오래됐습니다(1960년도). 1990년대만 하더라도 일반 PC시장에서는 거의 사용되지 않았지만 현대에 들어서며 프로세서 속도의 획기적인 발전으로 VM이 오버헤드를 더 감당할 수 있게 되고, 격리와 보안에 대한 중요도가 증가하며 인기를 얻고 있습니다.
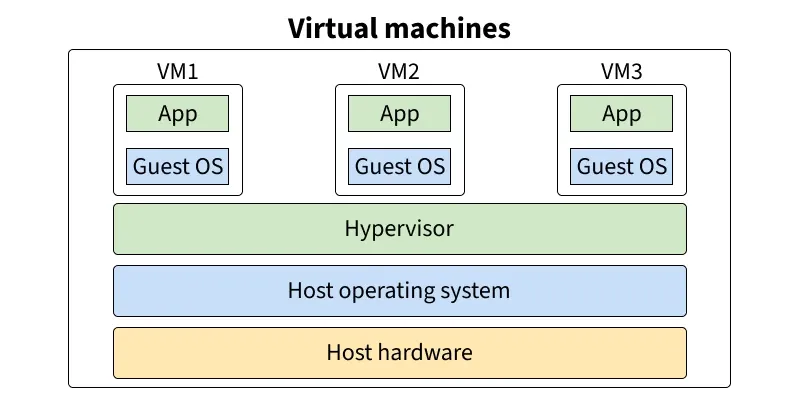
VM은 사실 꽤나 넓은 영역을 지니고있습니다.Java VM같이 표준 소프트웨어 인터페이스를 제공하는 모든 에뮬레이션 또한 VM으로 취급되는데요, 블로그에서는 ISA수준에서 완전한 시스템 계층 환경을 제공하는 System Virtual Machine을 다루겠습니다.
System VM은 사용자들에게 전체 컴퓨터를 혼자 쓰고 있다는 환상을 제공합니다. VM을 제공하는 소프트웨어를 VMM(Virtual Machine Monitor) 혹은 Hypervisor라고 부르는데 본 포스팅에서는 VMM이라고 부르겠습니다. VMM은 Virtual Resource를 어떻게 Physical Resource로 사상할 것인지를 결정합니다. 이는 컴퓨팅 자원을 어떻게 분배할 것인지를 의미하죠. 여기서 Physical Resource라고 하면 time-shared 혹은 partitioned로 공유되며 소프트웨어로 에뮬레이션 되기도 합니다.
요즘은 가상화 기술이 많이 보편화되어 Virtual Box, EC2 와 같은 VM을 다들 많이 접해봤을겁니다. VM을 사용하면 완벽한 소프트웨어 스택을 실행할 수 있는 추상화를 제공받을 수 있고, 하드웨어와 무관하게 실행 환경을 어디든 이식할 수 있다는 장점으로 인해 VM을 사용하는 것 같습니다.
앞서 살펴본 [RISC-V Privilege Levels] 의 핵심은 가상화 환경에서도 그대로 적용됩니다. VMM은 시스템 전체를 통제해야 하므로, 일반적인 Guest OS나 애플리케이션보다 반드시 높은 권한을 가져야 합니다.
따라서 시스템은 최소한 2개 이상의 프로세스 모드(Supervisor Mode, User Mode)를 지원해야 하며, VMM은 이 중 가장 높은 권한인 Supervisor(또는 그 이상의 확장 모드)에서 동작합니다. 반면, Guest VM 내에서 실행되는 OS와 Application들은 VMM보다 낮은 권한 계층에서 실행되며, 자원을 직접 제어하려는Privileged Instruction를 내릴 경우 Trap이 발생하여 VMM에 의해 통제됩니다.
RISC-V는 Virtualizable하다. 이는 VM을 고려한 ISA 설계를 통한 결과이며, 이로 인해 RISC-V는 Trap에 걸릴 법 한 명령어를 모두 찾아내고, 이 명령어들이 Guest OS에 의해 실행되게끔 하는 과정에서 낮은 복잡성을 가지기 때문에 VMM이 명령어를 처리할 때 발생하는 오버헤드가 다른 OS(x86-64, ARMv7, MIPS 등)에 비해 낮습니다.
System Virtual Machine과 이후에 다룰 Virtual Memory는 추상화라는 개념을 공유한다는 점에서 비슷해 보이지만 전혀 관계 없는 개념입니다. 두 개념을 혼동하거나 비슷한 거라고 착각하면 안됩니다.
Virtual Memory
Virtual Memory는 Storage 데이터를 RAM에서 Cash 로서 동작할 수 있도록 하는 기술을 의미합니다.
Virtual Memory의 탄생 과정을 알면 참 또 재밌는데요, Virtual Machine과는 다르게 일반 사용자가 추상화 컨너편을 바라볼 기회가 거의 없다시피 하기 때문에 책에서 제공하는 Virtual Memory의 배경 설명이 저에게는 큰 도움이 되었습니다.
근데 정말 초초초초창기 Virtual Memory는 시분할 시스템의 일부로 다수의 프로그램이 컴퓨터를 공유할 수 있게 하기 위해서 개발되었다고 합니다. 근데 제가 시분할 시스템에 대한 이해가 전혀 없기에 패스하겠습니다.
역사적으로 Virtual Memory를 사용하게 된 주요 동기는 두 가지 라고 합니다. 첫째는 여러 프로그램들이 효과적이고 안전하게 메모리를 공유할 수 있게 하기 위함입니다. 클라우트 컴퓨팅을 위한 여러 가상 머신의 메모리 요구가 이런 경우이죠. 둘째는 작고 제한된 크기의 메인 메모리에서 프로그래밍하는 제약을 제거하기 위함입니다. 이 기법이 탄생한 지 50년이 지난 지금은 첫 번째 이유로 널리 사용되고 있다고 하네요.
아무튼 차차하고, 다수의 VM이 같은 메모리를 사용할 수 있게 하려면, 모든 각기 다른 VM에서 작동하는 프로그램이 반드시 자신에게 할당된 메인 메모리 부분만 읽고 쓸 수 있게 하여 각 VM을 다른 VM으로부터 보호할 수 있어야 합니다.
프로그램을 컴파일할 때는 VM이 다른 어떤 VM과 메모리를 공유할지 알 수 없습니다. 메모리를 공유하는 VM들은 로직이나 동작은 일정하지만 VMM이 개입하면서 실제 데이터가 담기는 물리적 위치(Physical Memory)는 동적으로 변화합니다. 이러한 동적 상호작용 과정이 있어야 서로 다른 VM에서 실행되는 프로그램의 Physical Address를 다른 VM이 간섭하지 못하게 막아줍니다.
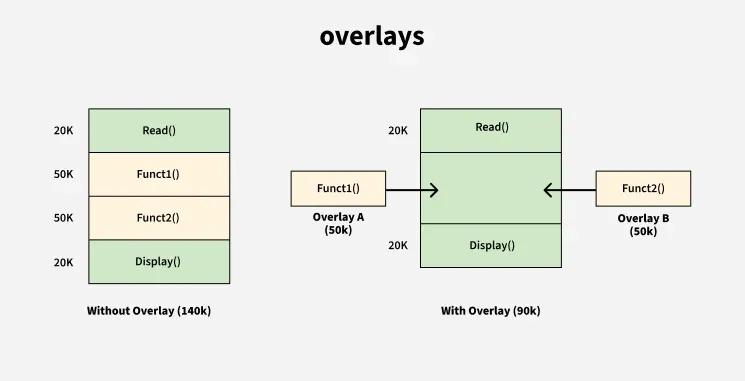
그리고 사용자 프로그램이 물리 메모리보다 커질 수 있도록 지원하기 위함도 다뤄야합니다. 과거에는 프로그램 크기가 메인 메모리를 초과하면 오버레이(Overlay)라는 방식을 통해 할당 메모리를 조절하는 작업이 전적으로 프로그래머의 몫이었습니다. 프로그래머는 프로그램을 작은 모듈 단위로 쪼개고, 동시에 실행될 필요가 없는 상호 배타적인 모듈을 직접 찾아내야 했습니다. 지금은 그렇지 않지만 말이죠~
Page Table and TLB
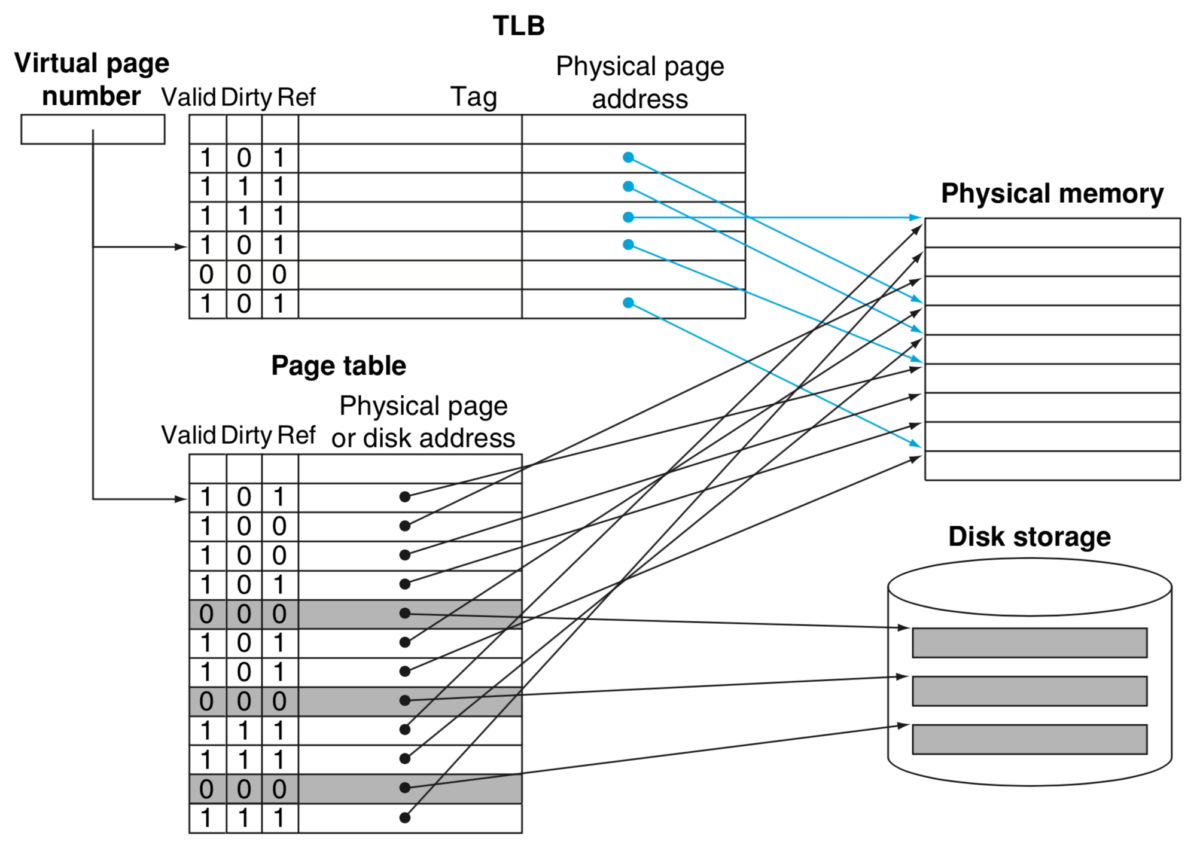
Virutal Memory에 대한 시각화입니다. 모든 프로세스들이 Virtual Address를 사용하기 때문에 프로세스들은 자신만의 Page Table을 가지고 있습니다. 그렇기에 운영체제가 서로 다른 프로세스들간의 Virtual Address 공간들이 충돌하지 않도록 Physical Memory를 할당하고 Page Table을 갱신해주죠.
Page Fault로 인해 운영체제가 제어권을 갖게 되면 계층은 Storage(or Flash Memory)내에 존재하는 해당 프로세스의 Swap Space에서 데이터를 가져오게 됩니다. 그리고 Page Table의 공간이 모자를 경우에도 이전에 다뤘던 (유사)LRU방식을 사용해 엔트리를 교체하는데 이 때에도 Swap Space에 저장됩니다.
디스크의 경우 전송시간이 접근시간보다 짧기 때문에 쓰기에서는 Write Back 전략을 취하며, dirty bit가 사용됩니다. 그리고 TLB가 없으면 메모리 접근은 2번에 거쳐 Sequantial하게 진행됩니다. TLB는 메모리 접근을 Parallel하게 가져갈 수 있도록 도와주죠.
TLB(Translation Lookaside Buffer)는 RAM에 할당되어 운영체제가 관리하는 데이터 구조가 아니라, CPU 패키지 내부 MMU(Memory Management Unit)에 통합된 하드웨어 컴포넌트입니다. 이러한 이유로 엔트리를 많이 갖지 못해 TLB Miss가 Page Fault보다 훨씬 빈번하게 발생합니다.
TLB의 보편적인 값은 아래와 같습니다.
- TLB Size: 16 ~ 512 엔트리
- Block Size: 1 ~ 2 Page Table 엔트리
- Hit Time: 0.5 ~ 1 Clock Cycle
- Miss Penalty: 10 ~ 100 Clock Cycle
- Miss Rate: 0.01 ~ 1%
TLB는 캐시 메커니즘을 따르기에 다양한 Set Associative를 적용할 수 있으나, 일반 캐시 대비 용량이 압도적으로 작다는 구조적 차이가 있습니다. 또한, Fully Associative를 도입하면 주소 검색 속도는 향상되지만, LRU와 같은 복잡한 교체 알고리즘을 하드웨어로 구현하는 데 막대한 리소스와 비용이 소모된다는 Trade off가 존재합니다.
완벽한
LRU구현을 위해서는 메모리를 참조할 때마다 자료구조를 갱신해야하기 때문에 비용이 많이 듭니다. 그래서 RISC-V 컴퓨터의 운영체제는 일정 주기로reference bit를 0으로 만들고 후에 참조된 페이지만 다시 1로 만드는 방식을 사용하여LRU를 구현합니다.reference bit가 제공되지 않는 Architecture의 운영체제는 다른 방식으로 해당 기능을 구현합니다.
약간의 TMI를 붙이자면,
Fault는 하드웨어만으로 극복이 불가해 운영체제에게 제어권을 넘기는 Exception에 해당하므로RISC-V에서는TLB Miss라고 명칭해야합니다. 그러한 의미에서MIPS는Software managed TLB이므로TLB Fault라고 명칭하면 아주 정확한 것이지요.
그리고 재밌게도 Cache에서 Tag와 Index를 Virtual Address에서 가져오냐, Physical Address에서 가져오냐에 따라 PIPT, VIPT(VIVT, PIVT는 생략)으로 나눌 수 있으며, 구분에 따라 다양한 특성과 문제가 발생합니다.
Cache Addressing Schemes: PIPT vs. VIPT
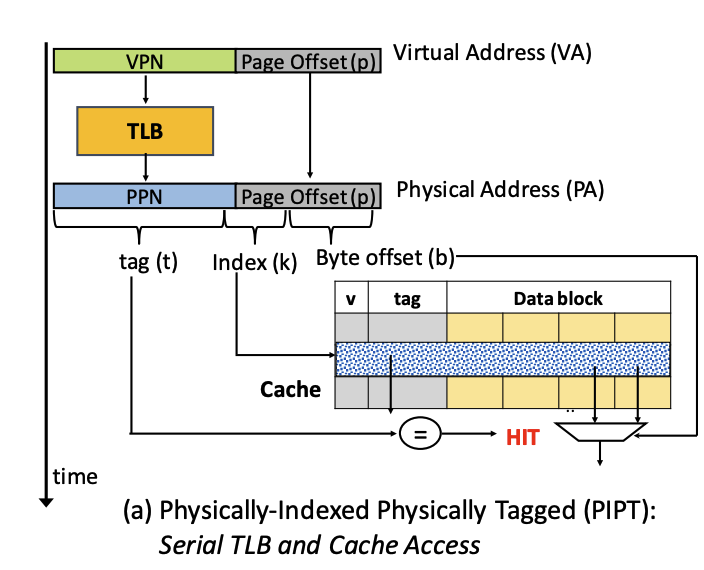
우선 정석적인 방식 PIPT(Physically Indexed, Physically Tagged)입니다. 이 방식은 아무래도 TLB 조회 + Cache Index 조회가 직렬적으로(Serial) 수행되어야하므로 다른 방식에 비해 상대적으로 느립니다. 그렇지만 이후에 설명할 VIPT 에서 발생하는 aliasing, homonym 문제가 발생하지 않는다는 장점이 있어 속도보다 용량과 정확성이 중요한 하위레벨 캐시에서 많이 사용됩니다. 실제 루나레이크에서는 L0/L1캐시에서 VIPT가, L2/L3 캐시에서는 PIPT가 사용되었습니다.
추가적인 구성을 통한 문제 해결은 항상 가능한 일이기에, 위에서 말하는 장점과 단점은 기본형에 국한된 설명임을 알아주세요
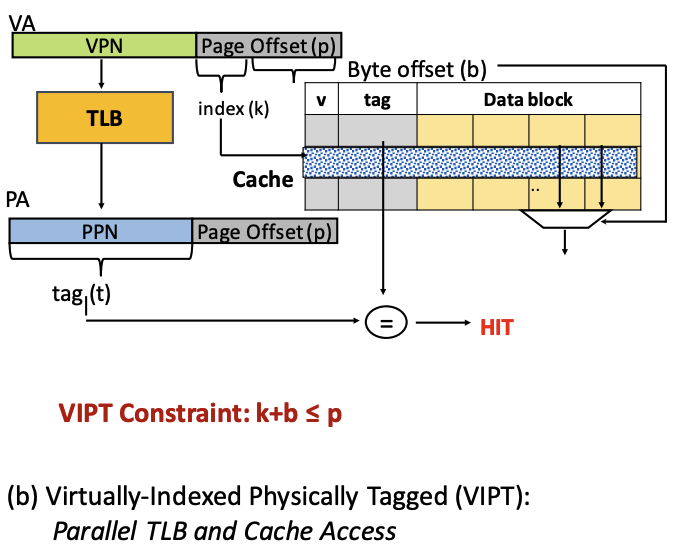
경우에 따라 최적화를 위해서는 가상 주소의 일부(k)를 이용해 TLB에서의 Tag조회 + 캐시 인덱스 조회가 동시에(Parallel) 이루어지는 VIPT (Virtually Indexed, Physically Tagged)방식을 사용할 수도 있습니다. 그렇지만 Homonym 문제가 발생할 수 있습니다. 아래에서 이 문제를 한번 다뤄보죠
Homonym 문제는 서로 다른 두 프로세스(Process A, B)가 각자의 가상 주소(Virtual Address) 공간에서 동일한 주소 값을 사용하지만, 실제로는 서로 다른 물리 주소(Physical Address)를 가리킬 때 발생합니다.
“이게 어떻게 말이 되느냐, 애초에 설계를 개떡같이 한거 아니냐”라고 반문할 수 있습니다. 그렇지만 사실 이것이 가상 메모리의 본질입니다. 모든 프로세스는 자신이 시스템 메모리를 독점하고 있다는 착각 속에서 독립된 주소 체계를 가져야 하기 때문입니다. 현대 아키텍처는 가상 메모리가 주는 이 거대한 이점을 포기하지 않았고, 그 반작용으로 나타나는 Homonym 현상을 하드웨어적으로 관리하는 방향을 선택했습니다.
과거에는 Context Switching이 발생할 때마다 캐시나 TLB를 Flush해버리는 방식을 통해 Homonym 문제를 원천 차단했습니다. 하지만 이는 심각한 성능 저하를 야기했기에, 현대 프로세서는 태그(Tag) 필드에 가상 주소뿐만 아니라 “이 데이터가 어느 프로세스의 것인가”를 증명하는 프로세스 고유 식별자(ASID)를 함께 저장합니다.
이러한 식별자 덕분에 이제 CPU는 Context Switching 후에도 캐시를 비우지 않고, “VA는 같아도 식별자가 다른 데이터를 정확히 구분해내며 고성능을 유지할 수 있게 되었습니다.
다루지 않은 Aliasing 이라는 잠재적 위험이 있습니다. 이 현상은 서로 다른 Virtual Address들이 동일한Physical Address를 매핑할 때 발생합니다. 이로 인해 특정 가상 주소에서 수행한 쓰기 작업의 결과가, 다른 가상 주소에는 즉각 반영되지 않는 Inconsistency 문제를 야기합니다. 이는 시스템의 무결성을 파괴하는 심각함 문제입니다.
그렇지만 Aliasing은 설계 단계에서 VIPT 제약 조건($k+b \le p$)을 준수하거나 Way(Associativity)를 대폭 늘려 인덱스 비트($k$)가 $p$의 울타리를 넘지 않게 조절하는 방법이 존재해 다루지 않았습니다. 그렇지만 Aliasing를 놓치거나 성능을 위해 인덱스($k$) 비트를 과도하게(over $p$) 늘리는 순간 언제든 발생할 수 있는 잠재적 위협입니다.
X86-64에서는 프로세스 고유 식별자 비트를
PCID(Process Context Identifiers)라고 합니다.
Mechanisms for Virtual Memory Protection
위에서 다룬 Homonym에 대한 해결방법이 Mechanisms for Virtual Memory Protection의 아주 중요한 예시입니다.
운영체제의 예외 처리기 실행이 시작될 때부터 운영체제가 프로세서의 모든 상태를 저장하는 시간 사이에는 운영체제가 매우 취약한 상태입니다. 예외를 활성화하거나 비활성화하는 기능을 제공함으로써 이 문제를 해결할 수 있습니다.
가상 메모리는 물리 메모리보다 큰 공간을 활용할 수 있게 해주지만, 프로세스가 실제 메모리 용량보다 과도하게 가상 메모리에 접근하면 디스크 I/O 비용으로 인해 성능이 급격히 저하되는 Thrashing현상이 발생합니다. Thrashing은 발생 시 손실이 매우 크기 때문에 메모리를 늘리는 것이 일반적인 해결책입니다. 하지만 컴퓨터 전공자라면 알고리즘과 자료구조를 재검토하여 Locality를 개선함으로써 Working Set 규모를 줄이는 시도해볼 수 있습니다.
실제로 Thrashing보다 빈번하게 발생하는 성능 병목은 TLB Miss입니다. TLB는 보통 32~64개 정도의 엔트리만 처리할 수 있어, 프로세서가 즉각 접근 가능한 범위가 $64 \times 4 \, \text{KiB} = 0.25 \, \text{MiB}$ 수준에 불과하기 때문입니다. 그렇기에 Radix Sort와 같이 광범위한 메모리 접근이 일어나는 경우 높은 TLB Miss를 보입니다. 이를 완화하기 위해 RISC-V와 같은 현대 하드웨어는 기본적으로 $4 \, \text{KiB}$ 외에도 $2 \text{MiB}$나 $1 \text{GiB}$의 Multiple Page를 지원합니다. 큰 페이지를 사용하면 TLB Miss 없이 직접 접근 가능한 메모리 영역이 비약적으로 넓어지기 때문입니다.
그러나 운영체제 차원에서 큰 페이지 사용을 허용하는 것은 또 다른 문제입니다. 수백 개의 프로세스가 돌아가는 서버 환경에서 큰 페이지는 Memory Fragmentation을 심화시킬 수 있어 OS 설계자들이 아주 싫어하기 때문입니다. 그렇기에 결국 소프트웨어 수준에서 알고리즘과 자료구조를 최적화하여 Working Set을 최소화하는 것이 가장 현실적이고 효과적인 전략이 될 수 있을 것 같습니다.
Parallel Processor
병렬 처리의 도전적인 과제는 하드웨어가 아닙니다. 문제는 멀티프로세서에서 더 빨리 수행하도록 재작성된 응용 프로그램들의 수가 너무 적다는 것입니다. 멀티프로세서를 사용하여 1개의 태스크를 더 빨리 수행하는 소프트웨어를 작성하는 것이 너무 어렵기 때문이죠.
The Scaling Limit of Parallel Systems: Amdahl’s Law
이번 챕터에서는 Computer Organization and Design에서 제공하는 예제를 그대로 사용합니다. 해당 예제를 통해 Parallel System에서 겪는 Speed-up challenge에 대해 알아보겠습니다.
Speed-up Challenge: Bigger Problem
Bigger Problem을 쉽게 이해하려면 strong scaling과 weak scaling에 대해 알아야 하는데요. strong scaling은 문제의 크기를 고정시킨 상태에서 얻어지는 속도 개선입니다. 문제의 크기 M이 메인 메모리 내의 working set과 같고 프로세서는 P개가 있다고 가정할 때, strong wcaling의 프로세서당 메모리는 대략 M/P이 되죠.
그러면 예제를 통해 수치적으로 나타내보죠. 아래 문제를 풀어보고 이후의 글을 읽으면 더 도움이 됩니다.
예제 1: 100개의 프로세서를 가지고 90배의 속도 개선을 얻기로 원하는 누군가가 있다고 합시다. 원 프로그램에서 최대 몇 %까지는 순차적으로 실행되도 좋을까요?
우선 1장에서 다룬 Amdahl의 법칙이 사용되니 한번 짚고 갑시다. 이 법칙은 쉽지만 굉장히 중요하니 꼭 알아두시기 바랍니다.
이 Amdahl의 법칙을 $\text{Overall Speedup}$와 $\text{Execution time before enhancement}$ 의 관계식으로 다시 작성하면 아래와 같이 표현할 수 있습니다.
$\text{Execution time before enhancement} = 1$이라고 가정하고, 식을 다시 정리하면 개선될 부분의 시간이 $\text{Execution time before enhancement}$에 대한 비율로 바뀝니다. 거기에 기대하는 $\text{Overall Speedup} = 90$ 을 식에 대입하고 $\text{Amount of Improvement} = 100$을 대입하면 아래와 같이 나타나죠.
\[90 = \frac{1}{(1 - \text{ExT affected by enhancement}) + \frac{\text{ExT affected by enhancement}}{100}}\] \[\therefore \text{ExT affected by enhancement} \approx 0.999\]결국 100개의 프로세서를 이용하여 90배의 속도 개선을 얻기 위해서는 전체 프로그램에서 순차적인 부분의 비율이 0.1% 이하가 되어야 합니다. 즉 병렬화가 가능한 부분이 99.9% 이상이여야 가능한 수치인거죠.
애초에 성능 개선 폭을 너무 높게 잡은건 맞으나, 이는 병렬처리를 통한 성능 개선이 타이트하게 기존 프로그램을 손봐야 가능함을 보여줍니다.
weak scaling은 프로세서의 수에 비례하여 문제 크기를 증가시키는 경우의 속도 개선입니다. 문제의 크기 M이 메인 메모리 내에working set과 같고 프로세서는P개가 있다고 가정할 때,weak scaling의 경우 프로세서당 메모리는 대략M이 됩니다.
예제 2: 어떤 프로그램이 10개의 스칼라 변수의 합을 구하고 10 × 10 2차원 행렬의 합을 구하는 덧셈을 수행한다고 가정하자. 10개의 프로세서를 사용하는 경우에 비해서 40개의 프로세서를 사용할 경우 얼마의 속도 개선을 얻을 수 있을까? 또 행렬의 크기를 20 × 20으로 늘렸을 때의 속도 개선을 구하시오.
덧셈 연산을 수행하는 시간을 t라고 하고 성능이 t의 함수라고 가정합시다. 이때 스칼라 변수 10개의 덧셈은 병렬 프로세서를 사용해도 좋아지지 않지만, 100번의 덧셈은 병렬 프로세서를 사용하면 좋아질 수 있습니다.
위에서와 같이 10개의 프로세서 대비 40개의 프로세서를 사용하면 1.6배의 속도 개선을 얻을 수 있습니다.
\[\begin{aligned} \text{Execution time with enhancement (10 Processor)} &= \frac{400t}{10} + 10t = 50t \\ \text{Execution time with enhancement (40 Processor)} &= \frac{400t}{40} + 10t = 20t \\ \\ \implies \text{Speedup} = \frac{50t}{20t} &= \mathbf{2.5 \text{배 속도 개선}} \end{aligned}\]행렬의 크기가 20 × 20으로 증가하면 2.5배 속도가 향상되는 것도 볼 수 있습니다. 이 예제를 통해 알 있는 바는 문제의 크기를 증가시키면서 속도를 뽑는 것(weak scaling)이 문제의 크기를 고정시킨 상태에서 속도를 뽑는 것(strong scaling)보다 쉽다는 것입니다.
이론적으로는 문제 크기를 키우면 $sequential$의 비중이 줄어듭니다. 그래서 프로세서를 많이 투입한 만큼 속도가 쭉쭉 올라가는 것처럼 보이죠. 그렇지만 memory hierarchy가 너무 커져서 멀티코어 마이크로프로세서의 마지막 단계 캐시에 다 들어가지 않으면, strong scaling을 사용하는 경우보다 성능이 나빠질 수 있는 것을 명심해야합니다.
Bigger Problem을 다루며 우리는 모든 프로세서에 동일한 부하가 가해진다고 가정했습니다. 그렇지만 실제로는 그렇지 않죠. 코어마다 그리고 In-cheap Accelerator가 일반적이게 된 지금, 프로세서마다의 부하는 굉장히 차이가 많이 납니다. 그렇기에 프로세서마다 얼마나 부하가 다른지에 따른 성능 개선 예제도 살펴봅니다.
Speed-up Challenge: Balancing Load
앞의 예제에서 40개의 프로세서를 사용하여 속도 개선을 얻기 위해서 우리는 부하(Load)가 완전히 균형을 이룬(nice Balance) 것으로 가정했습니다. 즉 각 프로세서가 2.5%씩 부하를 나누어가졌다고 생각한거죠. 이제 아닌 경우를 다루어볼겁니다.
예제 3: 한 프로세서의 부하가 2배로 증가하는 경우(5%)와 5배로 증가하는 경우(12.5%)의 속도 개선을 계산하시오. 그리고 나머지 프로세서가 얼마나 잘 활용되고 있는지 서술하시오
한 프로세서가 병렬로 수행될 부분의 $5\%$를 담당하면 $\text{5\%} \times \text{400}$ 즉 20개의 덧셈을 수행하고 나머지 39개의 프로세서가 380개의 덧셈을 나누어 수행하게 됩니다. 그러나 이 연산들은 모두 동시에 수행되므로 가장 늦은 프로세서의 수행시간으로 최종 실행시간이 결정되게 됩니다.
\(\text{Execution time with Enhancement} = \max(\frac{380t}{39}, \frac{20t}{1}) + 10t = 30t\) 성능 개선의 폭이 20.5에서 410t/30t = 14로 감소했습니다. 한 프로세서가 20t동안 쉬지 않고 일을 수행하는 동안 나머지 39개의 프로세서는 380t/39 = 9.7t 시간동안 일하고 나머지 반 이상의 시간을 가만히 있었기 때문이죠.
해당 프로세서의 부하를 더 걸어줄수록 속도 개선을 더 떨어집니다. 당연한겨죠. 이러한 부분이 병렬 하드웨어상 속도 개선을 함에 있어 어려운 지점으로 작용한다는 것을 꼭 알고가야합니다.
최근 아키텍처 분야를 연구하다 현직에서 LLM Optimization을 담당하고 계신 선배님을 만나뵐 기회가 있었습니다. 글을 적다보니 갑자기 선배님이 해주신 “생각보다 많은 이들이 가장 기본적인 원칙을 간과한다. 내가 지금 기본 원칙을 제대로 적용했는지 끊임없이 스스로에게 물어야 한다”라는 조언이 문뜩 떠오르네요. 암달의 법칙을 모르는 사람은 없겠지만, 실제 시스템에서 해당 원칙을 놓친 채 일을 수행하거나 진행되는 연구나 실험은 결국 막대한 시간과 비용을 낭비하기 때문이죠..
Hardware Parallelism
1960년대 병렬 하드웨어를 분류하는 방법이 하나 제안되었는데, 이것이 오늘날에도 여전히 사용되고 있다고 합니다. 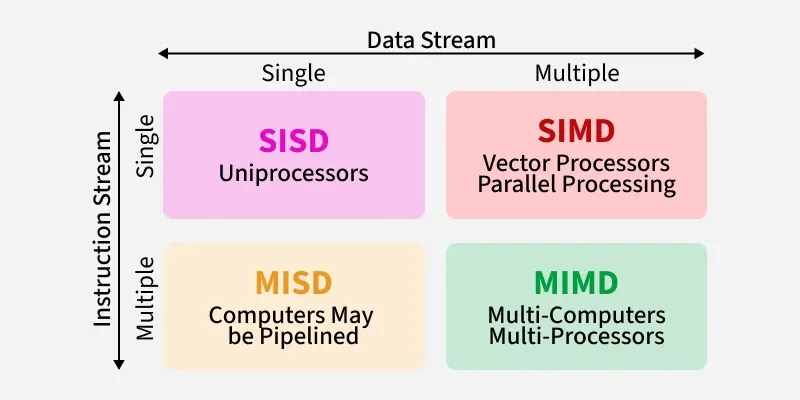
이 분류법은 Instruction Stream의 개수와 Data Stream개수에 기반합니다. 눈여겨 봐야 할 것은 Multieple Data Stream입니다. 이 두가지가 처음에는 뭐가 다른건지 이해하기 어려운데요? SIMD는 x86의 SSE instruction를, MIMD로는 Intel Core i7를 생각하시면 대충 어떤 느낌인지 감이 잡히실겁니다.
SIMD 컴퓨터는 단일 명령어로 여러 데이터 스트림을 동시에 처리하는 Data-level Parallelism에 최적화되어 있습니다. 예를 들어, 하나의 SIMD 명령어는 64개의 데이터를 64개의 ALU로 보내 한 클럭 사이클에 동시에 처리하는게 가능하죠.
SIMD는 Data-level Parallelisim을 지니는 배열을 처리할 때에 가장 효율적입니다. 그렇기에 for문을 처리하는데 있어 굉장히 효율적이죠. 그렇지만 case, switch문을 처리함에 있어서는 단점을 보입니다. 각 실행 유닛이 자신이 가진 데이터가 무엇인가에 따라 다른 동작을 수행해야 하기 때문이죠. 부적합한 데이터를 가진 실행 유닛들은 동작을 억제시키기 때문에 적합한 데이터를 가진 유닛들만 동작하도록 제어해야하는데, 그러는 과정에서 성능이 급격히 떨어집니다.
여기서 SIMDInstruction을 지원하는 프로세서를 여러개 사용하면 MIMD가 됩니다. 그러나 MIMD로 되는 순간 신경써야할게 더더 많아지는데요 MIMD환경에서는 단순히 계산 속도만 빨라지는 게 아니라 하드웨어 자원을 나눠 쓰는 과정에서 복잡한 숙제가 생깁니다. 이 부분은 책에서도 거의 다루지 않고 저도 아직 잘 모르기때문에 포스팅에서 다루지 않겠습니다.