Spectral Graph Theory
Bridging Continuous and Discrete
Reference
위 자료들을 참고했습니다. 좋은 자료를 제공해주셔서 감사합니다.
이산적인 대상을 연속적인 도구로 풀어내기 위해 중요한 도구들을 정리한 포스팅입니다.
처음 나오는 용어의 경우 직역을 포함해서 서술합니다. 그러나 용어는 기본적으로 영문을 사용합니다.
Spectral Analysis of Moore Graphs
그래프의 지름(diameter) $D$는 그래프의 어떤 노드에서 다른 어떤 노드로든 이동할 수 있음을 보장하기 위해 필요한 최소 이동 거리입니다. 아래와 같이 정리할 수 있습니다.
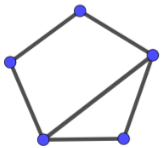
\[D = \underset{i,j \in V}{\max} \ \text{"length of shortest path between } i \text{ and } j\text{"}\]모든 노드의 차수(degree)가 $d$일 때 그 그래프를 $d\text{-regular}$하다고 합니다. 여기서 degree란 각 노드에 연결된 간선의 개수를 의미합니다. 아래 그래프는 diameter가 2이지만, 어떤 노드는 degree가 2이고 어떤 노드는 degree가 3이므로 $d\text{-regular}$가 아닙니다.
이 글에서는 $diameter=2$인 $d\text{-regular}$ 그래프 중 노드 수가 최대한 많은 그래프를 다룹니다. 임의의 $d\text{-regular}$ 그래프를 노드 $i$에서 시작해 트리 형태로 층별로 펼쳐 그리면 아래와 같은 형태가 됩니다.
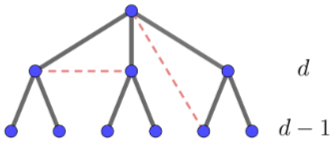
각 노드의 degree는 $d$로 고정되어 있으므로($d\text{-regular}$ 그래프를 특정 노드를 기준으로 트리 형태로 펼친 것이니까요), 첫 번째 층의 노드들끼리 연결되면(그림의 빨간 점선) 그 간선만큼 새로운 노드로 뻗어나갈 수 없어 전체 노드 수가 줄어듭니다. 따라서 노드 수를 최대화하려면 같은 층의 노드 사이에는 연결이 없어야 합니다. 같은 이유로 이런 그래프에는 삼각형이나 사각형이 존재할 수 없습니다. 이 조건에서 그래프는 $n = 1 + d + d(d-1) = d^2 + 1$개의 노드를 갖습니다. 이렇게 노드 수의 상한을 달성하는 그래프를 Moore graph라고 부릅니다.
그래프 $G$의 인접 행렬(adjacency matrix)을 $A = (a_{ij})$라고 하면 $a_{ij}$는 아래와 같이 정의할 수 있습니다.
\[a_{ij} = \begin{cases} 1 & \text{if } (i,j) \in E \\ 0 & \text{otherwise.} \end{cases}\]만약 $B = A^2$라면 어떻게 될까요?
\[b_{ij} = \sum_{k} a_{ik} a_{kj} = \text{ number of walks of 2 steps in graph } G \text{ from } i \text{ to } j.\]그래프가 $d\text{-regular}$이므로 $b_{ii} = d$입니다. 노드 $i$에서 $1 \text{ step}$에 도달할 수 있는 정점이 $d$개이고, 각각에서 곧바로 되돌아오면 $2 \text{ step}$이 되기 때문입니다. 또한 노드 $i$에서 시작하면 그래프의 다른 모든 정점에 정확히 $\text{1 or 2 or 3 step}$ 중 하나의 방법으로만(exclusive or) 도달한다는 것도 확인할 수 있습니다. 따라서 다음이 성립합니다.
\[I + A + A^2 - dI = J\]여기서 $I$는 Identity matrix, $J$는 all-ones matrix입니다.
이 챕터의 핵심이라고 생각되는 내용인데요, “지름 2인 $d\text{-regular}$ 그래프”라는 조합적 조건을 행렬 방정식으로 표현하면서 이산적인 그래프를 연속적인 방식으로 다룰 수 있게되었습니다. 성분별로 읽으면, $i \ne j$일 때 $a_{ij} + b_{ij} = 1$, 즉 서로 다른 두 노드는 거리 1이거나 거리 2 중 정확히 하나라는 뜻입니다.
이제 symmetric matrix $A \in \mathbb{R}^{n \times n}$를 해석하기 위해 아래의 선형대수학 정의를 사용합니다.
- symmetric matrix의 모든 고유값은 실수(R)입니다.
- 고유값 $\lambda_1, \dots, \lambda_n$(이를 spectrum이라 부릅니다)과 고유벡터 $x_1, \dots, x_n$가 존재하여, $i \ne j$이면 $\langle x_i, x_j \rangle = x_i^T x_j = 0$입니다.
- 대각합(trace)에 대해 $tr(A) = \sum_{i=1}^{n} a_{ii} = \sum_{i=1}^{n} \lambda_i$입니다.
존재성 (Existence)
지금까지 지름 2인 $d\text{-regular}$ 그래프의 구조를 따져봤습니다. 그런데 이런 그래프가 실제로 존재할까요? 저도 잘 모르는데 일단 강의 내용을 따라가봅니다.
먼저 $e = (1, \dots, 1)^T$를 모든 성분이 1인 벡터라 하면, 그래프가 $d\text{-regular}$이므로 행렬의 대각화 법칙에 따라$Ae = de$입니다. 즉 $e$는 $A$의 고유벡터이고 $d$는 그에 대응하는 고유값입니다. 또한
\[A^2 e = A(Ae) = A(de) = d(Ae) = d^2 e\]이므로,
\[\begin{aligned} (I + A + A^2 - dI)e &= Je \\ e + de + d^2 e - de &= ne \end{aligned}\]따라서 $n = d^2 + 1$가 됩니다.
이제 $e$와 직교하는 $A$의 다른 고유벡터 $v$를 생각해봅시다. $v^T e = 0$이므로 $Jv = 0$입니다. 어떤 고유값 $\lambda$에 대해 $Av = \lambda v$이고, $A^2 v = A(Av) = A(\lambda v) = \lambda^2 v$입니다. 따라서
\[\begin{aligned} (I + A + A^2 - dI)v &= Jv \\ v + \lambda v + \lambda^2 v - dv &= 0 \\ \implies 1 + \lambda + \lambda^2 - d &= 0 \end{aligned}\]그러므로 $e$에 대응하지 않는 모든 고유값은
\[\lambda = \frac{-1 \pm \sqrt{4d-3}}{2}\]입니다.
이제 Moore graph의 Adjacency Matrix A는 self-loop가 없으므로 $tr(A)=\sum_{i=1}^{n} \lambda_{i} = 0$ 이라는 성질을 활용합니다.
성질을 활용하면 $\sqrt{4d-3}$가 무리수인 경우와 유리수인 경우 두가지로 나눠서 바라볼 수 있게됩니다.
Case 1. $\sqrt{4d-3}$이 무리수인 경우
trace의 합이 0이 되려면(=무리수 부분이 소거되려면) 두 고유값 $\frac{-1+\sqrt{4d-3}}{2}$와 $\frac{-1-\sqrt{4d-3}}{2}$의 중복도(multiplicity)가 각각 $\frac{n-1}{2}$로 같아야 합니다. 이를 대입하면
\[\begin{aligned} tr(A) = 0 &= d + \frac{n-1}{2}\left( \frac{-1+\sqrt{4d-3}}{2} + \frac{-1-\sqrt{4d-3}}{2} \right) \\ &= d - \frac{n-1}{2} = d - \frac{d^2}{2} \\ &\implies d = 0 \text{ 또는 } d = 2 \end{aligned}\]가능한 그래프는 다음뿐입니다.
$d = 0$ : Moore bound ($n=d^2+1$)에 대입하면 $n=1$이 됩니다. 즉 정점이 하나뿐이고 간선은 없는 그래프입니다. 이 그래프는 서로 다른 두 정점이 존재하지 않으므로 찾고 있는 지름이 2인 그래프에는 해당하지 않습니다.
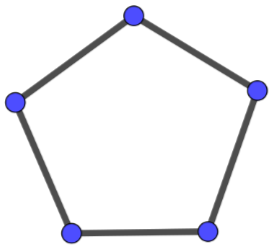
$d = 2$: ($n=d^2+1=5$)이므로 정점이 $5$개입니다. 또한 모든 정점의 $degree$가 $2$여야 하므로, 연결 그래프라면 다섯 정점이 하나의 고리를 이루는 5-cycle 이 됩니다. C_5에서는 서로 이웃한 정점까지의 거리는 1이고, 이웃하지 않은 정점까지도 최대 2번의 이동이면 도달할 수 있으므로 $diameter$가 2입니다. 따라서 $d=2$인 경우에는 Moore graph가 존재합니다.
Case 2. $\sqrt{4d-3}$이 유리수인 경우
$s^2 = 4d - 3$이라 하고, 고유값 $\frac{-1+s}{2}$의 중복도를 $m$이라 합시다. 그러면
\[\begin{aligned} tr(A) &= d + m\left( \frac{-1+s}{2} \right) + (n-1-m)\left( \frac{-1-s}{2} \right) \\ &= 0 \end{aligned}\]$d = \frac{1}{4}(s^2 + 3)$이라는 사실을 이용하면 $n - 1 = d^2 = \frac{1}{16}(s^4 + 6s^2 + 9)$를 얻습니다. 계속하면
\[0 = \frac{1}{4}(s^2+3) + m\left( \frac{-1+s}{2} \right) + \left( \frac{1}{16}(s^4 + 6s^2 + 9) - m \right)\left( \frac{-1-s}{2} \right)\]식을 정리하면 다음을 얻습니다.
\[-s^5 - s^4 - 6s^3 + 2s^2 + (32m - 9)s + 15 = 0\]유리근 정리(rational root theorem)에 의해 이 다항식의 정수해 $s$는 15의 약수여야 합니다. 따라서 가능한 근을 전부 나열할 수 있습니다.
여기가 핵심 뽀인뜨입니다. 고유값 자체는 연속적인 값이지만, 중복도 $m$은 “그 고유값이 몇 개냐”이므로 반드시 음이 아닌 정수여야 합니다. 이 정수 조건이 연속적인 계산에 이산적인 제약을 걸어서 가능한 $s$를 유한집합으로 제한합니다.
가능한 경우는 다음과 같습니다.
(a) $s = 1, d = 1, n = 2$:
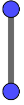
2개 노드의 1-regular 그래프는 간선 하나짜리 그래프인데, 지름이 2가 아닙니다.
(b) $s = 3, d = 3, n = 10$:
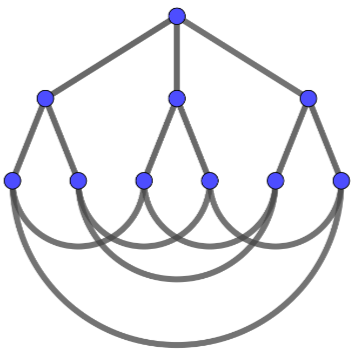
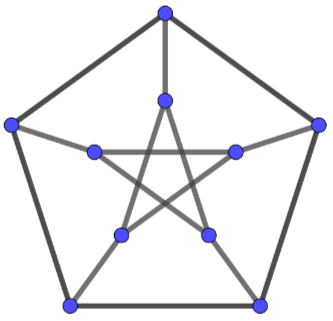
이 경우에 나오는 그래프가 바로 Petersen graph입니다. 같은 그래프라도 그리는 방식은 여러 가지인데, 앞에서처럼 한 정점을 기준으로 층별로 펼쳐 그릴 수도 있고, 흔히 볼 수 있는 별 모양의 형태로도 표현할 수 있습니다.
Petersen graph는 그래프 이론에서 꽤 자주 등장하는 유명한 그래프입니다. 정점마다 정확히 3개의 간선이 연결된 3-regular(cubic) graph이면서, 어떤 간선을 하나 제거해도 그래프가 끊어지지 않는 bridgeless graph입니다.
특히 간선을 세 가지 색으로 칠하되 한 정점에서 만나는 세 간선의 색이 모두 다르게 하려는 3-edge-coloring이 불가능하다는 성질로 잘 알려져 있습니다. 또한 Hamiltonian cycle도 존재하지 않습니다.
찾아보니 이처럼 Petersen graph는 겉보기에는 단순해 보이지만 여러 성질에서 예상과 어긋나는 모습을 보여준다고 합니다. 그래서 그래프 이론에서 어떤 명제가 항상 성립할 것이라고 생각했을 때, 반례를 찾는 과정에서 자주 등장하는 대표적인 그래프 중 하나라고 하네요.
(c) $s = 5, d = 7, n = 50$:
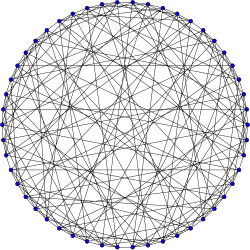
이 경우에는 실제로 조건을 만족하는 그래프가 존재하며, 이를 Hoffman-Singleton graph라고 부릅니다. 이름 그대로 Alan Hoffman과 Robert Singleton이 Moore graph를 분류하는 과정에서 1960년에 발견한 그래프입니다.
Hoffman-Singleton graph는 정점이 50개이고, 모든 정점의 degree가 7인 7-regular graph입니다. 간선은 총 175개이며 diameter는 2입니다. 즉 정점이 50개나 되지만, 아무 두 정점을 골라도 최대 두 번의 이동만으로 도달할 수 있습니다. 또한 삼각형이나 사각형이 없어서 girth는 5입니다.
앞에서 구한 Moore bound에 $d=7$을 대입해보면
\[n = d^2 + 1 = 7^2 + 1 = 50\]이 나오는데, Hoffman-Singleton graph는 실제로 정확히 50개의 정점을 가지므로 이 상한을 달성합니다. 따라서 단순히 조건을 만족하는 7-regular graph가 아니라, $d=7$, $\mathrm{diameter}=2$인 Moore graph 그 자체입니다.
조금 더 흥미로운 점은 이런 조건을 만족하는 그래프가 여러 개 존재하는 것이 아니라, 동형(isomorphism)을 제외하면 Hoffman-Singleton graph가 유일하다는 것입니다. 즉 정점의 이름이나 그림을 그리는 방식만 바꾼 것을 같은 그래프로 본다면, $d=7$인 경우의 Moore graph는 사실상 유일합니다.
스펙트럼도 앞에서 계산한 식과 정확히 맞아떨어집니다. $d=7$이면
\[\frac{-1\pm\sqrt{4d-3}}{2} = \frac{-1\pm5}{2}\]이므로 나머지 고유값은 $2$와 $-3$이 됩니다.
실제 Hoffman-Singleton graph의 spectrum은
\[7^1,\qquad 2^{28},\qquad (-3)^{21}\]입니다. 즉 앞에서 trace와 고유값을 이용해 얻어낸 조건이 단순히 필요조건으로 끝나는 것이 아니라, 실제로 존재하는 그래프에서도 그대로 나타나는 것을 확인할 수 있습니다.
(d) $s = 15, d = 57, n = 3250$:
이 경우는 조금 특별합니다. 앞의 $d=2,3,7$인 경우와 달리, $d=57$인 Moore graph가 실제로 존재하는지 아직까지 밝혀지지 않았습니다.
만약 존재한다면 정점의 수는 Moore bound에 의해
\[n=d^2+1=57^2+1=3250\]이 되어야 하고, 모든 정점의 degree가 57이면서 diameter가 2인 그래프여야 합니다. 하지만 지금까지 이런 그래프를 실제로 구성한 사람은 없고(제가 아는바에 따르면..), 반대로 이런 그래프가 존재할 수 없다는 증명도 나오지 않았습니다. 따라서 $d=57$인 경우는 여전히 미해결 문제로 남아 있는 것으로 보여집니다.
정리하면 diameter가 2인 Moore graph가 존재할 수 있는 degree는
\[d \in {2,3,7,57}\]로 제한됩니다. 이 결과가 바로 Hoffman-Singleton theorem입니다.
여기서 재미있는 점은 처음 시작한 문제가 굉장히 이산적이였다는 것입니다. 분명 시작은 “모든 정점의 degree가 $d$이고, 아무 두 정점 사이의 거리가 최대 2일 때 정점을 최대 몇 개까지 넣을 수 있을까?”라는 그래프의 연결 구조에 대한 질문이였습니다.
그런데 이를 adjacency matrix로 옮기고, 고유값과 trace를 이용해 분석하자 가능한 $d$의 값이 단 네 개로 좁혀졌습니다. 즉 그래프라는 이산적인 대상을 행렬과 고유값이라는 연속적인 도구로 분석한 셈입니다.
이산과 연속의 경계와 관계에 대해 느낄 수 있었던 참 좋은 경험이였고 즐거웠습니다.
Huang’s Theorem
이번 주제 또한 이전 주제와 비슷하게 Matrix Eigenvalue에 관한 정리 하나가 그래프 이론의 문제를 어떻게 해결하는지 보여줍니다.
먼저 Eigenvalue Interlacing Theorem을 소개하고, 그 정리를 그래프의 Clique Number, Chromatic Number에 적용한 뒤, 2019년에 증명된 Sensetivity Conjecture까지 연결합니다. 즉, 그래프를 행렬로 바꾸면 선형대수 도구로 그래프의 성질을 알아낼 수 있음을 보여주는 내용입니다.
Eigenvalue Interlacing Theorem
Symmetric Matrix A에서 몇 개의 행과 그에 대응하는 열을 지워서 더 작은 principal submatrix B를 만들었다고 하면
A의 고유값과 B의 고유값이 아무 관계 없이 변하는 것이 아니라, 서로 사이에 끼어드는(interlace) 형태의 제약을 받습니다. $A$의 고유값을 큰 순서대로
\[\lambda_1 \ge \lambda_2 \ge \cdots \ge \lambda_n\]이라 하고, $m \times m$ principal submatrix $B$의 고유값을
\[\beta_1 \ge \beta_2 \ge \cdots \ge \beta_m\]이라 하면 아래와 같은 Eigenvalue Interlacing Theorem가 정의됩니다.
\[\lambda_k \ge \beta_k \ge \lambda_{k+n-m}, \qquad k=1,\dots,m.\]특히 행과 열을 하나씩만 지워 $m=n-1$인 경우에는
\[\lambda_1 \ge \beta_1 \ge \lambda_2 \ge \beta_2 \ge \cdots \ge \beta_{n-1} \ge \lambda_n\]이 됩니다. Principal Submatrix $B$의 고유값들이 원래 행렬 $A$의 고유값 사이에 하나씩 끼어드는 모습인거죠.
principal submatrix가 단순히 행렬을 작게 만든 것에 그치지 않는 이유가 바로 여기에 있습니다. 그래프의 adjacency matrix에서 특정 정점을 제거하면 그 정점에 해당하는 행과 열을 동시에 제거하게 되므로, 새로운 그래프의 adjacency matrix는 원래 adjacency matrix의 principal submatrix가 됩니다. 이를 이용해 그래프에서 정점을 삭제하는 이산적인 연산을 고유값 사이의 부등식으로 만들어낼 수 있습니다.
Clique Number and Chromatic Number
이제 이 정리를 그래프의 Clique Number와 Chromatic Number에 적용해봅니다.
그래프 $G$의 clique number $\omega(G)$는 모든 정점 쌍이 서로 연결되어 있는 가장 큰 정점 집합의 크기입니다. 즉,
\[\omega(G)=\max\{|S|:S\subseteq V,\ (i,j)\in E\ \forall i,j\in S,\ i\ne j\}.\]인거죠. 그리고 chromatic number $\chi(G)$는 인접한 두 정점이 같은 색을 갖지 않도록 모든 정점을 색칠하기 위해 필요한 최소 색의 개수입니다.
maximum clique 안에서는 모든 정점이 서로 연결되어 있기 때문에 같은 색을 공유할 수 있는 두 정점이 없습니다. 따라서 아래 부등식이 항상 성립합니다.
\[\chi(G) \ge \omega(G)\]이제 $n$개의 모든 정점이 서로 연결된 complete graph $K_n$을 생각해봅시다. 이 그래프에서는
\[\omega(K_n)=\chi(K_n)=n\]이고 adjacency matrix는
\[A=J-I\]입니다. 여기서 $J$는 모든 원소가 1인 all-ones matrix입니다. $e=(1,\dots,1)^T$라고 하면
\[Ae=(J-I)e=ne-e=(n-1)e\]이므로 $e$는 eigenvalue $n-1$에 대응하는 eigenvector입니다. 이번에는 $e$와 직교하는 벡터 $v$를 생각해봅시다. $v^Te=0$이면 $J=ee^T$이므로
\[Jv=e(e^Tv)=0\]이고,
\[Av=(J-I)v=-v\]가 됩니다. 따라서 $e$에 수직인 모든 방향은 eigenvalue $-1$을 가지며, 그 공간의 dimension이 $n-1$이므로 $-1$의 multiplicity 역시 $n-1$입니다.
즉 $K_n$의 spectrum은
\[(n-1)^1,\qquad (-1)^{n-1}\]입니다.
이제 일반적인 그래프 $G$로 돌아옵니다. $G$에서 가장 큰 clique의 크기를 $m=\omega(G)$라고 하고, 그 clique의 정점들에 대응하는 adjacency matrix의 principal submatrix를 $B$라고 합시다.
clique 안에서는 모든 정점이 서로 연결되어 있으므로
\[B=J_m-I_m\]이고, 방금 계산한 complete graph의 결과에 의해 $B$의 가장 큰 eigenvalue는
\[\beta_1=m-1=\omega(G)-1\]입니다.
Eigenvalue Interlacing Theorem에 의해
\[\lambda_1\ge\beta_1\]이므로
\[\boxed{\lambda_1\ge\omega(G)-1}\]을 얻습니다.
여기서 상당히 재미있는 부분은 “가장 큰 clique를 찾아라”라는 조합적인 문제를 직접 풀지 않았다는 점입니다. maximum clique의 정점들만 남기면 complete graph가 된다는 사실과 principal submatrix의 eigenvalue가 원래 행렬의 eigenvalue 사이에 끼어든다는 사실만으로, clique number에 대한 bound를 증명할 수 있습니다.
Wilf’s Theorem
앞의 결과보다 더 강한 형태로 chromatic number 자체를 largest eigenvalue와 연결할 수 있습니다. 그러한 연결을 도와주는 Wilf’s Theorem은 다음과 같습니다.
\[\boxed{\chi(G)\le \lfloor\lambda_1\rfloor+1}\]여기서 $\lambda_1$은 그래프 $G$의 adjacency matrix에서 가장 큰 eigenvalue입니다.
이 정리를 증명하기 전에 degree와 eigenvalue 사이의 관계를 먼저 정리합니다. 정점 $i$의 degree를 $d_G(i)$라 하고,
\[\Delta(G)=\max_{i\in V}d_G(i)\]를 maximum degree,
\[d_{ave}=\frac{1}{n}\sum_{i\in V}d_G(i)\]를 average degree라고 합시다. 그러면
\[\boxed{d_{ave}\le\lambda_1\le\Delta(G)}\]가 성립합니다.
먼저 직관적인 결과 하나를 보면,
\[\chi(G)\le\Delta(G)+1\]입니다. 정점을 하나씩 greedy하게 색칠한다고 생각하면 현재 색칠하려는 정점에는 이미 색칠된 이웃이 최대 $\Delta$개밖에 없습니다. 최악의 경우 그 이웃들이 모두 서로 다른 $\Delta$개의 색을 사용하고 있더라도 $\Delta+1$번째 색은 남아 있으므로 색칠이 막힐 수 없습니다.
그런데 $\lambda_1\le\Delta$이므로 Wilf’s Theorem의
\[\chi(G)\le\lfloor\lambda_1\rfloor+1\]은 이 greedy bound보다 적어도 나쁘지 않은 더 강한 bound가 됩니다.
이를 증명하기 위해 Rayleigh quotient에 대한 다음 사실을 사용합니다.
\[\lambda_1=\max_{x\ne0}\frac{x^TAx}{x^Tx}.\]여기서 $x$는 eigenvector만을 의미하는 것이 아니라 $\mathbb{R}^n$의 임의의 벡터입니다. symmetric matrix $A$의 orthonormal eigenvector basis를 $v_1,\dots,v_n$이라 하면 모든 $x$는
\[x=c_1v_1+\cdots+c_nv_n\]으로 표현할 수 있고,
\[\frac{x^TAx}{x^Tx} = \frac{\lambda_1c_1^2+\cdots+\lambda_nc_n^2}{c_1^2+\cdots+c_n^2}\]가 됩니다. 즉 Rayleigh quotient는 eigenvalue들의 가중평균 형태이고, 그 값은 가장 큰 eigenvalue $\lambda_1$을 넘을 수 없습니다. $x=v_1$로 잡으면 실제로 $\lambda_1$을 달성하므로 위 식이 성립합니다.
이제 첫 번째 부등식 $\lambda_1\ge d_{ave}$를 보겠습니다.
Rayleigh quotient는 모든 $x$에 대한 maximum이므로 특정 벡터 $e=(1,\dots,1)^T$를 하나 넣은 값보다는 항상 크거나 같습니다.
\[\lambda_1 =\max_x\frac{x^TAx}{x^Tx} \ge\frac{e^TAe}{e^Te}.\]$e^Te=n$이고, adjacency matrix의 각 row의 합은 해당 정점의 degree이므로
\[Ae= \begin{pmatrix} d_G(1)\\ d_G(2)\\ \vdots\\ d_G(n) \end{pmatrix}.\]따라서
\[\begin{aligned} \frac{e^TAe}{e^Te} &=\frac{\sum_{i,j}a_{ij}}{n}\\ &=\frac{\sum_{i\in V}d_G(i)}{n}\\ &=d_{ave}. \end{aligned}\]결국
\[\boxed{\lambda_1\ge d_{ave}}\]를 얻습니다.
두 번째로 $\lambda_1\le\Delta(G)$를 보겠습니다. $\lambda_1$에 대응하는 eigenvector를 $v$라고 하면
\[Av=\lambda_1v\]입니다. $v$의 성분 중 절댓값이 가장 큰 성분을 하나 고르고, WLOG 그 성분이 $v(1)$이라고 합시다.
\[|v(1)|\ge|v(j)|\qquad\forall j.\]그러면 eigenvector equation의 첫 번째 coordinate만 보면
\[\begin{aligned} |\lambda_1v(1)| &=|(Av)(1)|\\ &=\left|\sum_{j=1}^{n}a_{1j}v(j)\right|\\ &=\left|\sum_{j:(1,j)\in E}a_{1j}v(j)\right|\\ &\le\sum_{j:(1,j)\in E}|a_{1j}||v(j)|\\ &\le |v(1)|\sum_{j:(1,j)\in E}|a_{1j}|\\ &\le |v(1)|\Delta(G). \end{aligned}\]$v(1)\ne0$이므로 양변을 $\lvert v(1)\rvert$로 나누면
\[\boxed{\lambda_1\le\Delta(G)}\]가 됩니다.
여기서 사용한 계산을 보면 adjacency matrix의 원소가 반드시 0 또는 1일 필요까지는 없습니다. edge가 없는 위치에서는 $a_{ij}=0$이고 edge가 있는 위치에서도
\[|a_{ij}|\le1\]만 만족한다면 똑같은 계산으로
\[\lambda_1\le\Delta(G)\]를 얻을 수 있습니다. 이 작은 확장이 뒤의 Huang’s Theorem에서 결정적인 역할을 합니다.
이제 Wilf’s Theorem을 induction으로 증명할 수 있습니다.
$n=2$일 때는 두 정점이 연결되어 있으면 $\lambda_1=1,\ \chi(G)=2$이고, 연결되어 있지 않으면 $\lambda_1=0,\ \chi(G)=1$이므로 정리가 성립합니다.
이제 $n-1$개의 정점을 가진 모든 그래프에서 정리가 성립한다고 가정하고, 정점이 $n$개인 그래프 $G$를 생각합니다.
앞에서
\[d_{ave}\le\lambda_1\]을 보였습니다. 평균 degree가 $\lambda_1$ 이하이므로 모든 정점의 degree가 $\lambda_1$보다 클 수는 없습니다. 따라서 어떤 정점 $v$는
\[d_G(v)\le\lambda_1\]을 만족합니다. degree는 정수이므로 사실
\[d_G(v)\le\lfloor\lambda_1\rfloor\]입니다.
이 정점 $v$ 를 제거한 그래프를 $G’$라고 하고, 그 adjacency matrix를 $B$, largest eigenvalue를 $\beta_1$이라고 합시다. $B$는 $A$에서 $v$에 대응하는 행과 열을 제거한 principal submatrix이므로 Interlacing Theorem에 의해
\[\beta_1\le\lambda_1\]입니다.
induction hypothesis를 $G’$에 적용하면
\[\chi(G')\le\lfloor\beta_1\rfloor+1 \le\lfloor\lambda_1\rfloor+1\]개의 색으로 $G’$를 색칠할 수 있습니다.
마지막으로 제거했던 $v$를 다시 넣습니다. $v$의 이웃은 최대 $\lfloor\lambda_1\rfloor$개이므로, 이미 사용 중인 $\lfloor\lambda_1\rfloor+1$개의 색 가운데 적어도 하나는 $v$의 이웃들이 사용하지 않습니다. 그 색으로 $v$를 칠하면 됩니다.
따라서
\[\boxed{\chi(G)\le\lfloor\lambda_1\rfloor+1}\]이 증명됩니다.
여기까지의 흐름을 보면 Interlacing Theorem의 용도가 조금 더 명확해집니다. 정점을 하나 제거하면 adjacency matrix는 principal submatrix가 되고, largest eigenvalue는 증가할 수 없습니다. 그래서 그래프의 크기를 하나씩 줄여나가는 induction과 spectral quantity인 $\lambda_1$을 동시에 추적할 수 있습니다.
Huang’s Theorem on Sensitivity Conjecture
이제 같은 도구를 complexity theory의 Sensitivity Conjecture로 연결합니다.
먼저 $d$차원 hypercube graph $Q_d=(V,E)$를 정의합니다. 정점은 길이 $d$의 bit string 전체이므로
\[V=\{0,1\}^d\]이고, 두 bit string이 정확히 한 자리에서만 다를 때 edge로 연결합니다.
예를 들어 $Q_3$에는
\[2^3=8\]개의 정점이 있고, 각 정점은 bit 하나만 뒤집어서 갈 수 있는 정점 3개와 연결되어 있습니다.
또한 $H=(V_H,E_H)$가 $G=(V,E)$의 induced subgraph라는 것은 $V_H\subseteq V$인 정점들을 골라놓고, 그 정점들 사이에 원래 $G$에서 존재하던 edge를 하나도 임의로 지우지 않은 그래프를 의미합니다.
\[E_H=\{(x,y):x,y\in V_H,\ (x,y)\in E\}.\]Huang’s Theorem은 다음과 같습니다.
\[\boxed{|V_H|\ge2^{d-1}+1\quad\Longrightarrow\quad\Delta(H)\ge\sqrt d}\]즉 $Q_d$의 정점을 절반보다 하나라도 더 많이 선택해서 induced subgraph를 만들면, 그 안에는 반드시 degree가 최소 $\sqrt d$인 정점이 존재합니다.
이 정리를 증명하기 위해 일반 adjacency matrix가 아니라 부호가 들어간 특별한 matrix $A_d$를 만듭니다.
\[A_1= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix},\]그리고 recursively
\[A_d= \begin{bmatrix} A_{d-1}&I\\ I&-A_{d-1} \end{bmatrix}, \qquad A_d\in\mathbb{R}^{2^d\times2^d}\]로 정의합니다.
이 matrix의 핵심 성질은
\[A_d^2=dI\]입니다.
$d=1$에서는 $A_1^2=I$이므로 성립합니다. $A_{d-1}^2=(d-1)I$라고 가정하면
\[\begin{aligned} A_d^2 &= \begin{bmatrix} A_{d-1}&I\\ I&-A_{d-1} \end{bmatrix} \begin{bmatrix} A_{d-1}&I\\ I&-A_{d-1} \end{bmatrix}\\ &= \begin{bmatrix} A_{d-1}^2+I&0\\ 0&A_{d-1}^2+I \end{bmatrix}\\ &= \begin{bmatrix} dI&0\\ 0&dI \end{bmatrix}\\ &=dI. \end{aligned}\]따라서 $A_d$의 eigenvalue를 $\lambda$라고 하면
\[\lambda^2=d\]이므로 가능한 eigenvalue는
\[\sqrt d,\qquad-\sqrt d\]뿐입니다.
또한 $A_d$의 diagonal은 모두 0이므로
\[tr(A_d)=0.\]따라서 $\sqrt d$와 $-\sqrt d$의 multiplicity가 같아야 하고, $A_d$의 dimension이 $2^d$이므로 각각
\[2^{d-1}\]개씩 존재합니다. 즉 spectrum은
\[(\sqrt d)^{2^{d-1}},\qquad(-\sqrt d)^{2^{d-1}}\]입니다.
그런데 $A_d$의 각 원소에 절댓값을 취하면 정확히 $Q_d$의 adjacency matrix가 됩니다.
\[|A_d|=A(Q_d)\]여기서 절댓값은 matrix 전체의 norm이 아니라 entrywise absolute value입니다. $A_d$는 edge가 존재하는 위치에 $1$ 또는 $-1$을 두고, edge가 없는 위치에는 0을 둔 signed adjacency matrix라고 생각할 수 있습니다.
이제 $H$가 $Q_d$의 induced subgraph라고 하고, $H$의 정점들에 대응하는 $A_d$의 principal submatrix를 $A_H$라고 합시다.
$A_H$의 nonzero pattern은 $H$의 edge와 정확히 일치하고 모든 원소는 절댓값이 1 이하이므로, 앞에서 얻은 corollary를 적용할 수 있습니다.
\[\lambda_1(A_H)\le\Delta(H).\]반면 $A_H$는 $A_d$의 $\lvert V_H\rvert \times \lvert V_H \rvert$ principal submatrix이므로 Interlacing Theorem에 의해
\[\lambda_1(A_H) \ge \lambda_{1+2^d-|V_H|}(A_d).\]Huang’s Theorem의 조건
\[|V_H|\ge2^{d-1}+1\]을 대입하면
\[1+2^d-|V_H|\le2^{d-1}.\]그런데 $A_d$의 큰 eigenvalue부터 앞의 $2^{d-1}$개는 전부 $\sqrt d$였습니다. 따라서
\[\lambda_1(A_H)\ge\sqrt d.\]두 부등식을 합치면
\[\boxed{\Delta(H)\ge\lambda_1(A_H)\ge\sqrt d}\]가 되어 Huang’s Theorem이 증명됩니다.
개인적으로는 여기서 Interlacing Theorem이 가장 명확히 보였는데, hypercube에서 정점을 일부 고르는 순간 그 작업은 matrix에서는 principal submatrix를 고르는 작업으로 바뀝니다. 원래 $A_d$의 spectrum을 미리 아주 단순한 형태로 만들어두면, 어떤 큰 induced subgraph를 고르더라도 그 principal submatrix의 largest eigenvalue가 $\sqrt d$ 아래로 내려갈 수 없고, 다시 그 eigenvalue를 maximum degree로 연결합니다.
이제 이 결과가 왜 Sensitivity Conjecture와 관계있는지를 봅니다.
boolean function
\[f:\{0,1\}^d\rightarrow\{0,1\}\]를 생각합시다. $x^i$를 $x$의 $i$번째 bit 하나만 뒤집은 벡터라고 하면 local sensitivity는
\[s(f,x)=|\{i:f(x)\ne f(x^i)\}|\]로 정의합니다. 즉 입력 $x$에서 bit 하나를 뒤집었을 때 함수의 출력이 바뀌는 coordinate가 몇 개인지를 세는 값입니다.
함수 전체의 sensitivity는 이 값을 모든 입력에 대해 최대화한 것입니다.
\[s(f)=\max_x s(f,x).\]block sensitivity는 bit 하나가 아니라 서로 겹치지 않는 여러 bit의 집합을 한 번에 뒤집는 것을 허용합니다. $x^{B_i}$를 block $B_i$에 속한 bit들을 모두 뒤집은 입력이라고 하면, local block sensitivity $bs(f,x)$는 서로 disjoint한 block $B_1,\dots,B_k$를 최대 몇 개까지 잡을 수 있는지 나타냅니다. 각 block은
\[f(x)\ne f(x^{B_i})\]를 만족해야 합니다.
그리고
\[bs(f)=\max_x bs(f,x)\]로 정의합니다. bit 하나짜리 block도 허용되므로 당연히
\[s(f)\le bs(f)\]입니다.
Sensitivity Conjecture는 모든 boolean function에 대해 sensitivity와 block sensitivity가 polynomial 관계에 있다는 주장입니다. 강의 노트의 표기로는 어떤 상수 $k>0$가 존재하여
\[bs(f)\le(s(f))^k\]가 모든 boolean function에 대해 성립하는가를 묻습니다.
Nisan과 Szegedy는 $f$를 표현하는 unique multilinear real polynomial의 degree를 $deg(f)$라고 할 때
\[bs(f)\le2deg^2(f)\]임을 보였습니다.
그리고 Gotsman과 Linial은 hypercube의 induced subgraph에 대한 maximum degree bound와 boolean function의 sensitivity bound가 서로 연결된다는 결과를 보였습니다. 강의 노트의 형태로 쓰면 monotone function $h:\mathbb{N}\rightarrow\mathbb{R}$에 대해 다음 두 명제가 서로 equivalent합니다.
$Q_d$의 induced subgraph $H$와 그 여집합 쪽 정점들로 만든 induced subgraph $H’$에 대해 $\lvert V_H\rvert \ne2^{d-1}$이면
\[\max(\Delta(H),\Delta(H'))\ge h(d).\]모든 boolean function $f$에 대해
\[s(f)\ge h(deg(f)).\]Huang’s Theorem에서 절반보다 하나 더 많은 정점을 가진 induced subgraph는 maximum degree가 최소 $\sqrt d$임을 보였으므로
\[h(d)=\sqrt d\]를 사용할 수 있습니다. 따라서
\[s(f)\ge\sqrt{deg(f)}\]이고, 이를 다시 쓰면
\[deg(f)\le s^2(f)\]입니다.
Nisan-Szegedy의 결과와 합치면
\[\begin{aligned} s(f) &\le bs(f)\\ &\le2deg^2(f)\\ &\le2s^4(f). \end{aligned}\]즉 block sensitivity가 sensitivity의 polynomial로 제한됨을 얻게 되고, 이것으로 Sensitivity Conjecture가 해결됩니다. 강의 노트에서는 이를 $k=4$의 형태로 정리하고 있으며, 위 계산에서 직접 얻어지는 bound는 상수항까지 쓰면 $bs(f)\le2s^4(f)$입니다.
처음에는 Eigenvalue Interlacing Theorem이라는 선형대수 정리에서 출발했습니다. 이 정리를 그래프의 adjacency matrix에 적용하면, 정점을 일부 제거해 만든 induced subgraph의 eigenvalue가 원래 그래프의 eigenvalue 사이에서 어떻게 제한되는지를 알 수 있습니다. 이 관점을 이용해 clique number와 chromatic number에 대한 bound를 얻고, 정점을 하나씩 제거하는 induction과 결합하면 Wilf’s Theorem까지 이어집니다. 이후에는 같은 principal submatrix의 아이디어를 hypercube에 적용하되, 일반적인 adjacency matrix 대신 signed matrix를 사용하면서 Huang’s Theorem과 boolean function의 sensitivity 문제로 연결됩니다.
이전 Moore graph에서도 비슷한 점을 느꼈지만, Spectral Graph Theory의 특징은 그래프의 연결 구조를 직접 하나씩 추적하기보다, 그 구조를 matrix로 옮긴 뒤 eigenvalue가 가질 수 있는 범위를 이용해 그래프의 성질을 알아낸다는 점인 것 같습니다. 특히 이번 내용에서는 정점을 제거하면 principal submatrix가 만들어지고, principal submatrix의 eigenvalue는 원래 matrix의 eigenvalue와 interlace한다는 관계가 처음부터 끝까지 계속 사용되었습니다.
Multiplicative Weights Update Algorithm
이번 Lecture에서는 Multiplicative Weights Update(MWU)라는 알고리즘을 다룹니다.
Lecture 2에서는 graph의 구조를 matrix로 옮기고 eigenvalue를 이용해 discrete structure를 분석했다면, 이번에는 반복적으로 의사결정을 내려야 하는 상황에서 과거의 결과를 weight에 반영하면서 좋은 선택에 점점 더 큰 확률을 부여하는 방법을 다룹니다.
전체 흐름은 다음과 같습니다.
\[\begin{array}{c} \text{Repeated Decision Problem} \\ \downarrow \\ \text{Multiplicative Weights} \\ \downarrow \\ \text{Performance Guarantee} \\ \downarrow \\ \epsilon\text{-Feasibility} \\ \downarrow \\ \text{Oracle} \\ \downarrow \\ \text{Max Flow} \end{array}\]핵심 아이디어는 단순합니다. 매 iteration마다 여러 선택지 중 하나를 골라야 하는데, 현재 어떤 선택이 가장 좋은지 미리 알 수는 없습니다. 대신 각 선택지에 weight를 부여하고, 이전 iteration에서 좋은 결과를 냈던 선택지의 weight를 multiplicatively 증가시킵니다.
이렇게 하면 시간이 지날수록 좋은 선택지에 더 높은 probability가 배정됩니다.
Repeated Decision Problem
매 time step $t$마다 선택 가능한 decision이
\[1,\dots,N\]개 있다고 합시다.
Decision $i$를 time $t$에 선택했을 때 얻는 value를
\[v_t(i)\in[0,1]\]라고 하겠습니다.
중요한 점은 decision을 내리기 전에는
\[v_t(1),\dots,v_t(N)\]을 알지 못한다는 것입니다. 즉, 현재 어떤 decision이 좋은지는 미리 알 수 없습니다. 다만 decision을 한 번 내린 뒤에는 모든 $v_t(j)$를 관찰할 수 있다고 가정합니다.
Time horizon을 $T$라고 하면 우리의 benchmark는 처음부터 끝까지 하나의 decision만 고정해서 사용했다고 가정했을 때 가장 좋았던 decision입니다.
즉
\[\max_{1\le j\le N} \sum_{t=1}^{T}v_t(j)\]와 비교합니다.
우리의 목표는 online하게 decision을 선택하면서도 total value가 이 값에 가깝도록 만드는 것입니다. 특히 Lecture에서는 $v_t$가 시간에 따라 어떤 방식으로 변하는지에 대한 가정을 두지 않습니다.
즉, 환경이 일정하거나 확률적으로 안정적일 필요가 없습니다. MWU의 목표는 value sequence가 어떻게 생성되었는지 모르더라도, 사후적으로 가장 좋았던 fixed decision과 비교했을 때 크게 뒤처지지 않는 것입니다.
Weight를 이용해 Decision을 선택하기
각 decision $i$에 대해 time $t$에서 weight
\[w_t(i)\]를 둡니다.
초기에는 모든 decision을 동일하게 취급하여
\[w_1(i)=1 \qquad \forall i=1,\dots,N\]로 설정합니다.
전체 weight의 합을
\[W_t = \sum_{i=1}^{N}w_t(i)\]라고 하면, decision $i$를 선택할 probability는
\[\boxed{ p_t(i) = \frac{w_t(i)}{W_t} }\]로 정의합니다.
따라서
\[\sum_{i=1}^{N}p_t(i)=1\]이고 $p_t$는 probability distribution이 됩니다.
Multiplicative Update
Decision의 결과를 본 뒤 weight는
\[\boxed{ w_{t+1}(i) = (1+\epsilon v_t(i))w_t(i) }\]로 update합니다.
여기서
\[0<\epsilon\le\frac12\]입니다.
$v_t(i)$가 클수록 $1+\epsilon v_t(i)$도 커지므로 더 좋은 value를 만든 decision의 weight가 더 빠르게 증가합니다.
예를 들어
\[v_t(1)=1, \qquad v_t(2)=0.2\]라면
\[w_{t+1}(1) =(1+\epsilon)w_t(1),\] \[w_{t+1}(2) =(1+0.2\epsilon)w_t(2)\]가 되어 다음 iteration에서는 decision 1의 probability가 더 커집니다.
여기서 update가 additive가 아니라 multiplicative라는 점이 중요합니다. 여러 iteration 동안 계속 좋은 결과를 보인 decision은 weight가 반복해서 곱해지기 때문에 빠르게 커집니다.
실제로
\[w_{T+1}(i) = \prod_{t=1}^{T}(1+\epsilon v_t(i))\]가 됩니다.
따라서 weight는 해당 decision이 지금까지 얼마나 좋은 결과를 누적해왔는지를 multiplicative하게 저장한다고 볼 수 있습니다.
Multiplicative Weights Algorithm
알고리즘을 정리하면 다음과 같습니다.
1
2
3
4
5
6
7
8
9
10
11
12
Initialize:
    w_1(i) = 1 for all i = 1,...,N

For t = 1,...,T:
    W_t = sum_i w_t(i)
    p_t(i) = w_t(i) / W_t

    Pick decision i according to p_t
    Observe v_t(1),...,v_t(N)

    For every i:
        w_{t+1}(i) = (1 + epsilon v_t(i)) w_t(i)
Time $t$에서 algorithm이 얻는 expected value는
\[\sum_{i=1}^{N}p_t(i)v_t(i)\]이고, 전체 expected total value는
\[\boxed{ \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) }\]입니다.
이제 정말로 이 값이 best fixed decision의 total value에 가까운지를 증명합니다.
Performance Guarantee
Theorem
$\epsilon\le\frac12$라고 합시다. 그러면 모든 fixed decision $j$에 대해
\[\boxed{ \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \ge (1-\epsilon) \sum_{t=1}^{T}v_t(j) - \frac{\ln N}{\epsilon} }\]이 성립합니다.
특히 오른쪽의 $j$를 best fixed decision으로 선택하면
\[\sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \ge (1-\epsilon) \max_j\sum_{t=1}^{T}v_t(j) - \frac{\ln N}{\epsilon}.\]즉 algorithm의 expected reward가 best fixed decision보다 크게 뒤처지지 않습니다.
왜 $W_{T+1}$을 보는가?
이 theorem의 proof에서는 전체 weight
\[W_{T+1}\]에 대해 upper bound와 lower bound를 각각 구한 뒤 둘을 비교합니다.
이 방법이 중요한 이유는 $W_{T+1}$이 서로 다른 두 정보를 동시에 담고 있기 때문입니다.
- Algorithm 전체가 얻은 expected value를 이용하면 $W_{T+1}$의 upper bound를 만들 수 있습니다.
- 특정 fixed decision $j$의 누적 value를 이용하면 $W_{T+1}$의 lower bound를 만들 수 있습니다.
따라서
\[\text{Algorithm's performance} \quad\leftrightarrow\quad W_{T+1} \quad\leftrightarrow\quad \text{Fixed decision }j\]라는 연결을 만들 수 있습니다.
$W_{T+1}$의 Upper Bound
먼저
\[W_{t+1} = \sum_{i=1}^{N}w_{t+1}(i)\]입니다.
Update rule을 대입하면
\[\begin{aligned} W_{t+1} &= \sum_{i=1}^{N}w_t(i)(1+\epsilon v_t(i))\\ &= W_t+\epsilon\sum_{i=1}^{N}w_t(i)v_t(i). \end{aligned}\]$w_t(i)=W_tp_t(i)$이므로
\[W_{t+1} = W_t \left( 1+\epsilon\sum_{i=1}^{N}p_t(i)v_t(i) \right).\]이제
\[1+x\le e^x\]를 사용하면
\[W_{t+1} \le W_t \exp\left( \epsilon\sum_{i=1}^{N}p_t(i)v_t(i) \right).\]이를 $t=1$부터 $T$까지 반복하면
\[W_{T+1} \le W_1 \exp\left( \epsilon \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \right).\]초기 weight가 모두 $1$이므로
\[W_1=N\]이고 따라서
\[\boxed{ W_{T+1} \le N \exp\left( \epsilon \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \right) }\]을 얻습니다.
$W_{T+1}$의 Lower Bound
이번에는 특정 fixed decision $j$ 하나를 봅니다.
전체 weight의 합은 특정 하나의 weight보다 항상 크므로
\[W_{T+1} \ge w_{T+1}(j).\]Update rule을 반복 적용하면
\[w_{T+1}(j) = \prod_{t=1}^{T}(1+\epsilon v_t(j)).\]Lecture에서는
\[1+\epsilon x \ge (1+\epsilon)^x, \qquad x\in[0,1]\]를 사용합니다.
따라서
\[\boxed{ W_{T+1} \ge (1+\epsilon)^{\sum_{t=1}^{T}v_t(j)} }\]입니다.
두 Bound를 연결하기
앞의 결과를 합치면
\[(1+\epsilon)^{\sum_{t=1}^{T}v_t(j)} \le N \exp\left( \epsilon \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \right).\]양변에 logarithm을 취하면
\[\ln(1+\epsilon) \sum_{t=1}^{T}v_t(j) \le \ln N + \epsilon \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i).\]정리하면
\[\sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \ge \frac{\ln(1+\epsilon)}{\epsilon} \sum_{t=1}^{T}v_t(j) - \frac{\ln N}{\epsilon}.\]$\epsilon\le\frac12$에서
\[\ln(1+x)\ge x-x^2\]이므로
\[\frac{\ln(1+\epsilon)}{\epsilon} \ge 1-\epsilon.\]결국
\[\boxed{ \sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \ge (1-\epsilon) \sum_{t=1}^{T}v_t(j) - \frac{\ln N}{\epsilon} }\]을 얻습니다.
왜 Exponential과 Logarithm이 등장하는가?
처음에는 update rule이
\[w_{t+1}(i) = (1+\epsilon v_t(i))w_t(i)\]처럼 단순한 multiplication인데, proof에서는 exponential과 logarithm이 등장합니다.
이유는 여러 iteration에 걸친 multiplicative growth를 다루기 위해서입니다.
Weight는
\[\prod_{t=1}^{T}(1+\epsilon v_t(i))\]처럼 product 형태로 쌓입니다.
Product는 그대로 다루기 복잡하지만 exponential과 logarithm을 사용하면 sum으로 바꿀 수 있습니다.
\[\prod_t e^{a_t} = e^{\sum_t a_t}\]이고
\[\ln\left(\prod_ta_t\right) = \sum_t\ln a_t\]이기 때문입니다.
즉 multiplicative update를 cumulative sum과 비교하기 위해 exponential/logarithm inequality를 사용하는 것입니다.
Application: Finding $\epsilon$-Feasible Solutions
이제 MWU를 inequality system의 feasible solution을 찾는 문제에 적용합니다.
다음 system을 생각합니다.
\[Ax\le e, \qquad x\in Q.\]여기서
\[A\in\mathbb{R}^{m\times n},\] \[e\in\mathbb{R}^{m}\]는 all-ones vector이고,
\[Q\subseteq\mathbb{R}^{n}\]는 convex set입니다.
또한 모든 $x\in Q$에 대해
\[Ax\ge0\]라고 가정합니다.
정확한 feasible solution 대신
\[Ax\le(1+\epsilon)e\]를 만족하는 $x\in Q$를 찾으면 이를 $\epsilon$-feasible solution이라고 부릅니다.
왜 MWU가 Constraint Satisfaction에 연결되는가?
$Ax\le e$를 row별로 보면
\[(Ax)(i)\le1, \qquad i=1,\dots,m\]이라는 $m$개의 constraint입니다.
따라서 각 row를 MWU의 하나의 decision처럼 생각할 수 있습니다.
현재 많이 violation되는 constraint에는 높은 weight를 주고, 다음 iteration에서는 그 constraint를 더 중요하게 보도록 만듭니다.
Iteration $t$에서 oracle이 반환한 $x_t$에 대해
\[v_t(i) = \frac{(Ax_t)(i)}{\rho}\]로 둡니다.
Constraint $i$가 크게 사용될수록 $v_t(i)$가 커지고, 다음 iteration에서 그 row의 weight도 더 커집니다.
Oracle
Lecture에서는 다음과 같은 oracle을 가정합니다.
주어진
\[p\in\mathbb{R}_+^m\]에 대해
\[p^TAx\le p^Te\]를 만족하는
\[x\in Q\]를 찾아줍니다.
만약 그런 $x$가 없다면 원래 system
\[Ax\le e, \qquad x\in Q\]도 infeasible하다고 판단할 수 있습니다.
여기서
\[p^TAx\]는 $x$에 대한 linear function입니다. 따라서 $Q$ 위에서 linear optimization을 쉽게 수행할 수 있다면 이 oracle도 구현할 수 있습니다.
MWU가 복잡한 feasible point를 한 번에 직접 찾는 것이 아니라, weight vector $p_t$를 계속 갱신하면서 매번 상대적으로 쉬운 weighted linear problem을 oracle에 넘기는 구조입니다.
Width $\rho$
Oracle이 반환할 수 있는 $Ax$의 coordinate 중 가장 큰 값을
\[\boxed{ \rho := \max_{i=1,\dots,m} \max_{x\in Q\text{ returned by oracle}} (Ax)(i) }\]로 정의합니다.
이를 width라고 합니다.
이 값이 필요한 이유는 MWU theorem에서
\[v_t(i)\in[0,1]\]이어야 하기 때문입니다.
그래서
\[v_t(i) = \frac{(Ax_t)(i)}{\rho}\]로 normalization합니다.
Feasibility Algorithm
알고리즘은 다음과 같습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
Initialize:
    w_1(i) = 1 for i = 1,...,m

For t = 1,...,T:
    W_t = sum_i w_t(i)
    p_t(i) = w_t(i) / W_t

    Run oracle and obtain x_t in Q such that
        p_t^T A x_t <= p_t^T e

    v_t(i) = (A x_t)(i) / rho
    w_{t+1}(i) = (1 + epsilon v_t(i)) w_t(i)

Return:
    x_bar = (1/T) sum_{t=1}^T x_t
마지막에 하나의 $x_t$를 반환하는 것이 아니라
\[\boxed{ \bar{x} = \frac1T\sum_{t=1}^{T}x_t }\]를 반환합니다.
여기서 $Q$가 convex라는 조건이 중요합니다. 모든 $x_t\in Q$이고 $Q$가 convex이므로
\[\bar{x}\in Q\]입니다.
Oracle이 주는 Bound
Oracle의 정의에 의해
\[p_t^TAx_t \le p_t^Te.\]$p_t$는 probability distribution이므로
\[p_t^Te = \sum_{i=1}^{m}p_t(i) = 1.\]따라서
\[p_t^TAx_t\le1.\]이제
\[v_t(i) = \frac{(Ax_t)(i)}{\rho}\]이므로
\[\begin{aligned} \sum_{i=1}^{m}p_t(i)v_t(i) &= \frac1\rho \sum_{i=1}^{m}p_t(i)(Ax_t)(i)\\ &= \frac1\rho p_t^TAx_t\\ &\le \frac1\rho. \end{aligned}\]따라서
\[\boxed{ \sum_{t=1}^{T} \sum_{i=1}^{m}p_t(i)v_t(i) \le \frac{T}{\rho} }\]입니다.
MWU Theorem을 각 Constraint에 적용하기
앞에서 증명한 theorem에 의해 임의의 row $j$에 대해
\[\sum_{t=1}^{T} \sum_{i=1}^{m}p_t(i)v_t(i) \ge (1-\epsilon) \sum_{t=1}^{T}v_t(j) - \frac{\ln m}{\epsilon}.\]왼쪽은 $T/\rho$ 이하였으므로
\[\frac{T}{\rho} \ge (1-\epsilon) \sum_{t=1}^{T}v_t(j) - \frac{\ln m}{\epsilon}.\]$v_t(j)$를 대입하면
\[\frac{T}{\rho} \ge (1-\epsilon) \sum_{t=1}^{T} \frac{(Ax_t)(j)}{\rho} - \frac{\ln m}{\epsilon}.\]그리고
\[\bar{x} = \frac1T\sum_{t=1}^{T}x_t\]이므로 linearity에 의해
\[\sum_{t=1}^{T}(Ax_t)(j) = T(A\bar{x})(j).\]따라서
\[(1-\epsilon) \frac{T}{\rho} (A\bar{x})(j) \le \frac{T}{\rho} + \frac{\ln m}{\epsilon}.\]Iteration 수 $T$
Lecture에서는
\[\boxed{ T = \frac{\rho\ln m}{\epsilon^2} }\]로 설정합니다.
이를 대입하면
\[(A\bar{x})(j) \le \frac{1}{1-\epsilon} \left( 1+ \frac{\rho\ln m}{\epsilon T} \right)\]이고
\[\frac{\rho\ln m}{\epsilon T} = \epsilon\]이므로
\[(A\bar{x})(j) \le \frac{1+\epsilon}{1-\epsilon}.\]$\epsilon\le\frac13$이면 Lecture에서 사용하는 bound에 의해
\[\frac{1+\epsilon}{1-\epsilon} \le 1+4\epsilon.\]따라서
\[\boxed{ A\bar{x} \le (1+4\epsilon)e }\]를 얻습니다.
즉 $\bar{x}$는 approximate feasible solution입니다.
Feasibility Algorithm의 핵심
Constraint가
\[(Ax)(i)\le1\]형태로 여러 개 존재합니다.
현재 크게 violation되는 constraint $i$는
\[v_t(i) = \frac{(Ax_t)(i)}{\rho}\]가 큽니다.
그러면 다음 iteration에서
\[w_{t+1}(i) = (1+\epsilon v_t(i))w_t(i)\]가 크게 증가하고, 따라서 $p_{t+1}(i)$도 커집니다.
다음 oracle call에서는
\[p_{t+1}^TAx\]를 작게 만들어야 하므로 weight가 커진 constraint가 더 중요하게 반영됩니다.
즉
\[\boxed{ \text{violation} \rightarrow \text{larger weight} \rightarrow \text{larger importance in oracle} \rightarrow \text{future correction} }\]이라는 feedback loop가 만들어집니다.
Application: Max Flow in Unit Capacity Graphs
Lecture 마지막에서는 이 framework를 unit capacity graph의 Maximum Flow에 적용합니다.
Graph
\[G=(V,E)\]가 있고 모든 edge의 capacity가
\[u(i,j)=1\]이라고 합시다.
Source를 $s$, sink를 $t$라고 하고 $s$에서 $t$로 보내는 maximum flow를 찾고 싶습니다.
하지만 앞에서 만든 algorithm은 optimization algorithm이 아니라 feasibility checker입니다. 따라서 maximum flow value를 직접 찾기보다
\[\text{value }k\text{의 flow가 존재하는가?}\]라는 질문을 반복해서 해결합니다.
Binary Search로 Optimization을 Feasibility로 바꾸기
Edge 수를
\[m=|E|\]라고 합시다.
모든 edge capacity가 $1$이므로 maximum flow value의 간단한 upper bound는 $m$입니다.
따라서 value $k$가 feasible한지 검사할 수 있다면 $k$에 대해 binary search를 수행할 수 있습니다.
즉
\[\boxed{ \text{Max Flow Optimization} \rightarrow \text{Repeated Feasibility Check} }\]로 바꿉니다.
Lecture에서는 약
\[\left\lceil\log_2m\right\rceil\]번의 feasibility check를 사용합니다.
Max Flow를 $Ax\le e$, $x\in Q$로 표현하기
각 edge $(i,j)$의 flow를
\[x(i,j)\]라고 합시다.
모든 edge capacity가 $1$이므로
\[x(i,j)\le1.\]따라서 capacity constraint를 담당하는 $A$는 identity matrix로 둘 수 있습니다.
\[A=I.\]그러면
\[Ax\le e\]는 정확히 모든 capacity constraint를 표현합니다.
이제 $Q$에는 나머지 flow 조건을 넣습니다.
먼저
\[x\ge0\]이어야 하고, $s,t$가 아닌 모든 vertex에서는 flow conservation이 성립해야 합니다.
\[\sum_{j:(i,j)\in E}x(i,j) - \sum_{j:(j,i)\in E}x(j,i) = 0, \qquad i\neq s,t.\]또한 source에서 나가는 net flow가 원하는 flow value $k$가 되어야 합니다.
\[\sum_{j:(s,j)\in E}x(s,j) - \sum_{j:(j,s)\in E}x(j,s) = k.\]따라서
\[Q = \left\{ x\ge0: \begin{array}{l} \text{flow conservation holds for }i\neq s,t,\\ \text{net flow from }s\text{ equals }k \end{array} \right\}.\]즉
- $Ax\le e$는 capacity constraint,
- $x\in Q$는 flow conservation과 target flow value
를 담당합니다.
Max Flow에서 Oracle은 무엇을 하는가?
MWU feasibility framework에서는 주어진
\[p\ge0\]에 대해
\[p^TAx\]를 작게 만드는 $x\in Q$를 찾아야 합니다.
여기서는
\[A=I\]이므로
\[p^TAx = p^Tx.\]각 edge $(i,j)$에
\[d(i,j)=p(i,j)\]라는 length를 부여했다고 생각할 수 있습니다.
그러면 oracle problem은 value $k$의 flow를 보내되 weighted cost $p^Tx$를 최소화하는 문제가 됩니다.
Lecture에서는 capacity constraint가 $Q$ 안에는 아직 들어있지 않기 때문에, flow를 더 긴 path로 보낼 이유가 없다고 설명합니다. 따라서 minimum은 $p(i,j)$를 edge length로 보았을 때 shortest path를 따라 flow를 보내는 방식으로 얻을 수 있습니다.
즉
\[\boxed{ \text{MWU weight }p \rightarrow \text{edge length} \rightarrow \text{shortest path oracle} }\]라는 연결입니다.
정리
이번 Lecture의 시작은 매우 일반적인 repeated decision problem이었습니다.
매 time step에서 어떤 decision이 좋은지 미리 알 수 없지만, 각 decision에 weight를 두고
\[w_{t+1}(i) = (1+\epsilon v_t(i))w_t(i)\]와 같이 update하면 좋은 결과를 계속 낸 decision의 probability가 자연스럽게 증가합니다.
그리고 total weight
\[W_t = \sum_iw_t(i)\]를 분석하면서 algorithm 전체 performance로 $W_{T+1}$의 upper bound를 만들고, 특정 fixed decision의 performance로 lower bound를 만든 뒤 둘을 비교하여
\[\sum_{t=1}^{T} \sum_{i=1}^{N} p_t(i)v_t(i) \ge (1-\epsilon) \sum_{t=1}^{T}v_t(j) - \frac{\ln N}{\epsilon}\]라는 guarantee를 얻었습니다.
여기서 끝나지 않고 matrix inequality
\[Ax\le e, \qquad x\in Q\]의 각 row를 하나의 MWU decision으로 해석했습니다.
Constraint가 많이 violation될수록 그 row의 weight를 증가시키고, 다음 oracle call에서는 해당 constraint를 더 중요하게 다루도록 만들었습니다.
결국 여러 iteration에서 얻은
\[x_1,\dots,x_T\]를 평균내어
\[\bar{x} = \frac1T\sum_{t=1}^{T}x_t\]를 만들면 convexity 덕분에 $\bar{x}\in Q$가 유지되고,
\[A\bar{x} \le (1+4\epsilon)e\]라는 approximate feasibility를 얻을 수 있었습니다.
마지막으로 unit capacity Max Flow에서는 optimization problem을 “value $k$의 flow가 존재하는가?”라는 feasibility problem으로 바꾸고 binary search를 사용했습니다.
Capacity constraint는 $Ax\le e$에 넣고, flow conservation과 target flow value는 convex set $Q$에 넣었습니다. 그리고 MWU가 만들어내는 weight vector를 edge length로 해석하면 oracle은 shortest path problem으로 바뀝니다.
이번 Lecture에서 흥미로웠던 점은 Multiplicative Weights가 단순히 여러 선택지 중 좋은 선택을 점점 더 자주 고르는 알고리즘으로 끝나지 않는다는 것입니다.
처음에는
\[\text{decision} \leftrightarrow \text{weight}\]라는 구조였지만, constraint satisfaction에서는
\[\text{decision} \leftrightarrow \text{constraint}\]로 해석되고, Max Flow에서는 다시
\[\text{weight} \leftrightarrow \text{edge length}\]로 해석됩니다.
같은 update rule을 유지한 채 문제의 구성 요소가 무엇을 의미하는지만 바꾸면서 전혀 다른 optimization problem에 적용할 수 있다는 점이 이번 Lecture의 핵심으로 보입니다.