Probabilistic Robotics
Intelligent Robotics and Autonomous Agents
Introduce
Figure 03이 택배 검수도 하고 아틀라스가 월드컵에서 공도 전달하고 백덤블링 갈기는, 그야말로 로봇의 시대이지만 로보틱스는 많은 영역에서 아직 많이 부족합니다. 이러한 지능형 매니퓰레이터에 대한 연구는 오랜 시간 진행되어왔으며 많은 발전을 거듭해왔습니다. 어릴적 게임에만 관심있던 나조차 계단을 걷는 로봇 아시모(ASIMO)의 등장으로 TV가 떠들썩했던 기억이 있습니다. 현재 그때에 비하면 엄청난 발전을 이뤄낸 로봇산업이지만, 자연어 기반의 플랫폼들의 발전 속도에 비하면 턱없이 느린 수준입니다. 이러한 엄청난 잠재력을 현실로 만들기 위해서는 실세계에 존재하는 엄청난 불확실성을 로봇이 수용할 수 있어야 합니다.
그러나 나는 현재 VLA 연구의 주류인 Diffusion, Flow Matching기반의 생성모델 접근만으로는 진정한 AGI에 도달할 수 없다고 생각합니다. 이들 모델은 시연 데이터의 분포를 모방하여 그럴듯한 행동을 생성하는 데에는 탁월하지만, 그것은 어디까지나 학습된 분포 안에서의 보간이지 세계에 대한 이해가 아닙니다. 분포 밖의 불확실성 - 처음 만지는 재질, 예상과 다른 무게, 미끄러지는 순간 생성모델은 근거 없는 자신감으로 틀린 행동을 생성할 뿐입니다.
더 근본적인 한계는 감각의 구조에 있다고 봅니다. 현재의 로봇 시스템은 촉각(tactile), 힘(force), 시각과 같은 감각들을 각각의 독립된 모듈로 붙여놓습니다. 촉각 센서가 값을 읽고, 힘 제어기가 따로 돌고, 비전 모델이 별도로 판단한 결과를 상위 정책이 뒤늦게 취합하는 식입니다. 그러나 인간의 지능은 그렇게 작동하지 않습니다. 컵을 쥐는 순간 우리는 미끄러짐을 보고 나서 느끼는 것이 아니라, 시각·촉각·고유수용감각이 하나의 예측 속에서 동시에 어긋남을 감지하고 행동을 수정합니다. 감각이 모듈로 분리된 시스템은 각 모듈이 완벽해도 그 사이의 틈에서 불확실성이 새어나갑니다. 결국 로봇의 AGI는 더 큰 생성모델이 아니라, 이러한 이종의 감각들이 유기적으로 연결되어 하나의 세계 모델 안에서 서로를 예측하고 교정할 수 있을 때 비로소 가능할 것이라고 생각합니다. 내가 로보틱스를 공부하며 도달하고 싶은 지점도 바로 그 연결의 구조를 만드는 일입니다.
로봇에게 불확실성을 주는 요인은 여러가지가 있습니다.
첫째, 환경은 본질적으로 예측이 불가능합니다. 공정 라인처럼 잘 구조화된 환경뿐 아니라 고속도로나 학교 혹은 공장 같은 환경은 너무나 다이나믹하고 여러면에서 예측이 불가능합니다. 불확실성은 사람 근처에서 동작하는 로봇에서 특히 높게 나타납니다.
둘째, 센서는 무엇을 인식할 수 있는가에 따라 제약이 발생합니다. 지상에서 라이다는 물체의 질감과 반사도에 큰 영향을 받습니다. 카메라는 조도에 취약합니다. 수중환경에서는 물이라는 매질의 특성으로 인해 라이다가 완전히 무력해집니다. 반면 지상에서는 멀리 전달되지 못하는 음향이 수중환경에서는 물이라는 매질과 만나 빛을 발합니다. 이렇듯 센서 측정에 있어 예측 불가능한 형태로 교란이 발생하면 정보 추출이 어려워집니다.
셋째, 액츄에이터 에는 모터가 포함되어 있는데, 이 모터는 제어 과정에서 마모 및 기계적 고장이 발생할 수 있습니다. 물론 중장비 산업에서 사용되는 일부 액추에이터는 매우 정밀하고 신뢰성이 높지만 가격이 높으며, 일반적인 로봇에 사용되는 로봇에서는 이러한 불확실성을 최대한 낮춰주는 방향성으로의 기술이 필요합니다.
확률론적 로보틱스는 Perception과 Action의 불확실성을 주로 다루는 로봇 연구 분야입니다. 확률론적 로보틱스의 핵심 아이디어는 학률 이론의 미적분학을 사용해 불확실성을 명확하게 표현하는 것입니다. 즉 추측할 수 있는 전체 공간의 확률 분포를 기반으로 정보를 표현합니다. 맵이 주어지고, 센싱과 모션을 통해 자신의 위치를 파악하는 로컬화 문제를 글로벌 로컬화(global localization)라고 합니다. 로봇은 주어진 환경 내의 모든 위치의 탐색공간에 대해 확률 밀도 함수를 이용하여 로봇의 특정 순간에 대한 빌리프(belief)를 표현합니다.
likelihodod와 Prior로 Posterior을 표현해 추측할 수 있는 전체 공간의 확률 분포를 표현하기 위해서는 Bayes Theorem에 대한 이해가 필요하다(앞으로 그냥 베이즈 정리라고 하겠습니다). 그리고 기본적으로 이산확률분포, 연속확률분포, 확률밀도함수, 확률질량함수.. 이건 알아야합니다.
Bayes Theorem & Filter
확률론적 로보틱스에서 모든 추론은 베이즈 정리입니다. 관측(증거)을 통해 상태에 대한 믿음을 갱신하는 이 한 줄의 식이, 뒤에서 다룰 칼만 필터와 파티클 필터를 비롯한 거의 모든 추정 기법의 뿌리가 됩니다.
본격적으로 들어가기 전에, 확률변수가 이산형이냐 연속형이냐에 따라 분포를 기술하는 방식이 갈린다는 점을 짚고 가겠습니다. 단 두 가지 가정은 전제로 합니다. (1) 모든 연속형 확률 변수는 측정 가능합니다. (2) 모든 연속형 확률 분포는 실질적으로 밀도를 지니고 있습니다.
이산 확률변수 (확률질량함수, PMF)
값이 셀 수 있게 떨어져 있는 경우(주사위 눈, 토큰, 상태 후보 등), 각 값에 직접 확률이 부여됩니다. 이때 함수값 p(x)는 그 값이 나올 확률이며, 모든 값에 대해 합이 1이 됩니다.
\[p(x) = P(X = x), \qquad \sum_{x} p(x) = 1\]연속 확률변수 (확률밀도함수, PDF)
값이 연속인 경우(위치, 속도, 각도 등), 특정 한 점의 확률은 0이 됩니다. 따라서 p(x)는 확률이 아니라 밀도이며, 확률은 구간에 대해 적분해야 얻어집니다. 전체 적분값이 1이 됩니다.
\[P(a \le X \le b) = \int_{a}^{b} p(x)\, dx, \qquad \int_{-\infty}^{\infty} p(x)\, dx = 1\]조건부 확률
확률 변수는 다른 확률 변수에 대한 정보도 함께 지니고 있는 경우가 많습니다. 예를 들어 확률변수 $Y$값이 $y$임을 이미 알고 있다는 조건 하에서 확률 변수 $X$가 $x$값을 가질 확률을 계산한다고 해보겠습니다. 이 경우 확률을 다음과 같이 표현 가능합니다.
\[P(x|y) = P(X = x|Y=y)\]이 식을 조건부 확률(conditional probability)라고 합니다. $P(x) > 0$ 이면, 조건부 확률은 다음과 같이 정의됩니다.
\[P(x|y) = \frac{P(x,y)}{P(y)}\]그리고 $X$와 $Y$가 독립인 경우 아래와 같이 표현됩니다.
\[P(x|y) = \frac{P(x)P(y)}{P(y)} = P(x)\]사실 고등학교 확률통계 내용입니다. 그렇지만 이는 확률변수 $X$와 $Y$가 서로 독립이면 $Y$는 확률변수 $X$에 아무 영향을 미치지 않으므로 확률 변수 $Y$를 고려해야할 필요가 전혀 없음을 보여줍니다. 이러한 개념을 독립성(Independence)라고 하며, 내용은 쉽지만 여기서 응용하여 역확률을 기반으로 생성 모델을 만들어내므로 아주 아주 중요한 내용이라고 할 수 있습니다.
베이즈 정리
두 경우 모두에서, 증거 $z$가 주어졌을 때 상태 $x$에 대한 믿음은 다음과 같이 갱신됩니다.
$p(x∣z)=p(z∣x) p(x)p(z)p(x \mid z) = \frac{p(z \mid x)\, p(x)}{p(z)}p(x∣z)=p(z)p(z∣x)p(x)$
여기서 분모 $p(z)$는 모든 가능한 상태에 대해 합(이산) 또는 적분(연속)하여 구하는 정규화 항입니다.
\[p(x \mid z) = \frac{p(z \mid x)p(x)}{p(z)}\]이 정규화 항은 사후분포 전체의 합(또는 적분)이 1이 되도록 맞춰주는 역할만 하므로, 비례 관계로 간단히 표현하면 핵심이 더 선명해집니다.
\[\begin{aligned} p(z) &= \sum_{x} p(z \mid x)\, p(x) && \text{(이산)} \\[6pt] p(z) &= \int p(z \mid x)\, p(x)\, dx && \text{(연속)} \end{aligned}\] \[\underbrace{p(x \mid z)}_{\text{posterior}} \propto \underbrace{p(z \mid x)}_{\text{likelihood}} \cdot \underbrace{p(x)}_{\text{prior}}\]의미론적 베이즈 정리
식을 외우는 것과 그 식이 무엇을 말하는지 아는 것은 다릅니다. 의미론적으로 베이즈 정리는 한 문장으로 압축됩니다. 새로운 믿음은, 원래 믿음에다가 그 증거가 이 믿음을 얼마나 뒷받침하는지를 곱한 것입니다.
각 항을 믿음의 언어로 읽으면 이렇습니다.
- Prior $p(x)$ (사전믿음): 증거를 보기 전에, 상태에 대해 미리 갖고 있던 믿음
- Likelihood $p(z \mid x)$ (우도): 상태가 $x$라면 이 관측 $z$가 나올 법한가, 즉 그 증거가 이 상태를 얼마나 뒷받침하는지
- Posterior $p(x \mid z)$ (사후믿음): 증거를 보고 난 뒤 새로 갱신된 믿음
여기서 핵심은 방향이 뒤집힌다는 점입니다.
우리가 실제로 측정할 수 있는 것은 보통 상태를 알 때 어떤 관측이 나올 확률 $p(z \mid x)$ 입니다. 이건 원인에서 결과로 향하는 방향입니다. 예를 들어 병에 걸렸다면 검사가 양성일 확률은 알기 쉽습니다.
그런데 우리가 정작 알고 싶은 것은 그 반대입니다. 이 관측이 나왔는데 그렇다면 상태는 무엇일까 $p(x \mid z)$. 결과를 보고 원인을 거슬러 추측하는 방향입니다. 검사가 양성인데 그래서 진짜 병일 확률은 얼마인가가 바로 이쪽입니다.
세상은 우리에게 원인에서 결과로 향하는 확률을 주는데, 우리가 원하는 건 결과에서 원인으로 거슬러 가는 방향입니다. 베이즈 정리는 이 두 방향을 잇는 다리이며, 관측할 수 있는 것으로부터 알고 싶은 것을 거꾸로 추론하게 해주는 도구입니다.
그리고 이 갱신은 한 번으로 끝나지 않습니다. 한 번 얻은 사후믿음은 다음 관측을 맞이할 때의 사전믿음이 됩니다. 즉 오늘의 결론이 내일의 출발점이 되는 것입니다. 이 사이클이 반복될수록 믿음은 점점 또렷해집니다. 로봇이 관측을 쌓아갈수록 자신이 어디 있는지 더 확신하게 되는 과정, 그것이 곧 베이즈 갱신의 연쇄이며, 앞으로 살펴볼 필터링 기법들이 시간 축 위에서 펼치는 바로 그 동작입니다.
Bayes Filter
베이즈 필터로 들어가기 전에, 로봇이 세계와 주고받는 것이 무엇인지부터 정리하겠습니다. 로봇과 환경의 상호작용은 세 가지 변수로 기술됩니다.
- 상태 $x$ : 로봇과 환경의 실제 상황. 로봇의 위치, 속도, 주변 지형처럼 우리가 알고 싶지만 직접 볼 수 없는 값입니다.
- 제어 $u$ : 로봇이 환경에 가하는 행동. “앞으로 1m” 같은 명령이며, 상태를 변화시키는 원인입니다.
- 관측 $z$ : 로봇이 환경으로부터 받는 정보. 센서 측정값이며, 상태를 간접적으로 들여다보는 창입니다.
이때 상태가 미래를 예측하는 데 필요한 모든 정보를 담고 있으면 그 상태를 완전한 상태(complete state)라고 부릅니다. 완전한 상태에서는 과거의 이력을 따로 기억할 필요가 없습니다. 현재 상태 하나만 알면 미래를 추론하는 데 과거가 더 보탤 정보가 없기 때문입니다. 이것이 곧 마르코프 성질이며, 앞으로 다룰 모든 필터의 토대가 됩니다.
반대로 미래 예측에 필요한 정보 중 일부가 상태에 빠져 있으면 불완전한 상태(incomplete state)입니다. 현실의 로봇은 거의 항상 불완전한 상태에서 동작합니다. 모든 것을 다 측정할 수도, 상태 변수에 다 담을 수도 없기 때문입니다. 확률론적 접근이 필요한 이유가 여기에 있습니다. 빠진 정보로 인한 불확실성을 확률분포로 표현하는 것입니다.
확률론적 생성 법칙
로봇의 상태와 관측이 시간에 따라 어떻게 만들어지는지를 기술하는 두 개의 모델이 있습니다.
상태 천이 모델(state transition model)은 이전 상태와 제어로부터 다음 상태가 생성되는 과정입니다.
\[p(x_t \mid x_{t-1}, u_t)\]관측 모델(measurement model)은 현재 상태로부터 관측이 생성되는 과정입니다.
\[p(z_t \mid x_t)\]이 두 모델이 시간 축을 따라 반복되며 상태와 관측의 흐름을 만들어냅니다. 상태는 천이 모델을 따라 한 단계씩 진화(evolution)하고, 각 상태에서 관측 모델을 따라 측정값이 생성됩니다.
이렇게 시간에 따라 상태가 생성되고 그 상태가 관측을 낳는 구조를, 숨은 상태를 관측을 통해 추론한다는 의미에서 은닉 마르코프 모델(Hidden Markov Model, HMM)이라 부릅니다. 더 일반적으로 여러 변수 사이의 의존 관계를 시간 축 위에 펼쳐 표현한 것을 동적 베이즈 네트워크(Dynamic Bayes Network, DBN)라 합니다. 베이즈 필터는 바로 이 구조 위에서 동작합니다.
belief와 두 단계
로봇은 실제 상태 $x$를 직접 알 수 없습니다. 로봇이 가질 수 있는 것은 상태에 대한 belief(믿음)뿐입니다. belief는 지금까지의 모든 관측과 제어를 종합해 상태가 어디일지를 나타낸 확률분포이며, 그래서 지식 상태(knowledge state) 혹은 정보 상태(information state)라고도 불립니다. 로봇은 세계 그 자체가 아니라, 세계에 대한 자신의 정보를 들고 움직이는 셈입니다.
belief는 다음과 같이 정의됩니다.
\[bel(x_t) = p(x_t \mid z_{1:t}, u_{1:t})\]belief는 한 타임스텝마다 두 단계를 거쳐 갱신됩니다.
예측(prediction)은 제어 $u_t$를 반영해 belief를 한 단계 굴리는 과정입니다. 아직 이번 관측 $z_t$를 보기 전의 belief이며, 예측 belief(표기는 $\overline{bel}$)라고 부르고 다음과 같이 정의됩니다.
\[\overline{bel}(x_t) = p(x_t \mid z_{1:t-1}, u_{1:t})\]이 단계에서는 제어 명령대로 움직였다고 믿지만 실제로는 오차가 끼므로, belief의 불확실성이 커집니다. 분포가 퍼지는 것입니다.
보정(correction)은 이번 관측 $z_t$를 반영해 예측 belief를 다듬는 과정입니다. 관측이라는 새로운 증거가 들어오면서 불확실성이 줄어듭니다. 분포가 좁혀지는 것입니다.
\[bel(x_t) = \eta \, p(z_t \mid x_t) \, \overline{bel}(x_t)\]정리하면 belief는 예측에서 한 번 퍼졌다가 보정에서 다시 좁혀지는 호흡을 매 순간 반복합니다. 예측은 믿음을 흐리게 만들고, 관측은 다시 또렷하게 만듭니다.
베이즈 필터
위의 예측과 보정을 하나로 묶은 것이 베이즈 필터입니다. 직전 belief $bel(x_{t-1})$로부터 현재 belief $bel(x_t)$를 만들어내는 재귀적 절차이며, 두 줄로 요약됩니다.
예측 단계는 다음과 같습니다.
\[\overline{bel}(x_t) = \int p(x_t \mid x_{t-1}, u_t) \, bel(x_{t-1}) \, dx_{t-1}\]보정 단계는 다음과 같습니다.
\[bel(x_t) = \eta \, p(z_t \mid x_t) \, \overline{bel}(x_t)\]수학적 유도
베이즈 필터가 어떻게 유도되는지 차례로 따라가 보겠습니다. 출발점은 belief의 정의입니다.
\[bel(x_t) = p(x_t \mid z_{1:t}, u_{1:t})\]먼저 가장 최근 관측 $z_t$를 나머지 이력과 분리한 뒤, $z_t$에 대해 베이즈 정리를 적용합니다.
\[bel(x_t) = \frac{p(z_t \mid x_t, z_{1:t-1}, u_{1:t}) \, p(x_t \mid z_{1:t-1}, u_{1:t})}{p(z_t \mid z_{1:t-1}, u_{1:t})}\]분모는 $x_t$를 포함하지 않으므로 정규화 상수 $\eta$로 묶습니다.
\[bel(x_t) = \eta \, p(z_t \mid x_t, z_{1:t-1}, u_{1:t}) \, p(x_t \mid z_{1:t-1}, u_{1:t})\]여기서 관측 모델의 마르코프 가정을 적용합니다. 현재 상태 $x_t$가 주어지면 관측 $z_t$는 과거와 조건부 독립(Conditional Independence)이므로 다음이 성립합니다. (Absolute Independence와 Conditional Independence는 완전히 다르니 주의)
\[p(z_t \mid x_t, z_{1:t-1}, u_{1:t}) = p(z_t \mid x_t)\]또한 남은 항은 정의상 예측 belief와 같습니다.
\[p(x_t \mid z_{1:t-1}, u_{1:t}) = \overline{bel}(x_t)\]이 둘을 대입하면 보정 단계가 완성됩니다.
\[bel(x_t) = \eta \, p(z_t \mid x_t) \, \overline{bel}(x_t)\]이제 예측 belief $\overline{bel}(x_t)$를 직전 belief로 풀어냅니다. 전체 확률의 법칙으로 직전 상태 $x_{t-1}$을 끌어들입니다.
\[\overline{bel}(x_t) = \int p(x_t \mid x_{t-1}, z_{1:t-1}, u_{1:t}) \, p(x_{t-1} \mid z_{1:t-1}, u_{1:t}) \, dx_{t-1}\]여기서 상태 천이 모델의 마르코프 가정을 적용합니다. 직전 상태 $x_{t-1}$과 제어 $u_t$가 주어지면 $x_t$는 과거와 조건부 독립입니다.
\[p(x_t \mid x_{t-1}, z_{1:t-1}, u_{1:t}) = p(x_t \mid x_{t-1}, u_t)\]그리고 남은 항은 직전 belief 그 자체입니다.
\[p(x_{t-1} \mid z_{1:t-1}, u_{1:t}) = bel(x_{t-1})\]대입하면 예측 단계가 완성됩니다.
\[\overline{bel}(x_t) = \int p(x_t \mid x_{t-1}, u_t) \, bel(x_{t-1}) \, dx_{t-1}\]이렇게 예측과 보정 두 단계가 유도되었습니다. 한 번 얻은 $bel(x_t)$는 다음 타임스텝에서 $bel(x_{t-1})$의 자리로 들어가 다시 예측의 재료가 됩니다. 오늘의 결론이 내일의 출발점이 되는 이 재귀가 베이즈 필터의 핵심입니다.
근사화 기법의 세 가지 고려 요소
베이즈 필터는 이론적으로 완결된 틀이지만, 적분을 그대로 계산할 수 있는 경우는 드뭅니다. 그래서 현실에서는 belief를 어떻게 근사할지를 선택해야 하며, 이때 계산 효율성, 근사 정확도, 구현 용이함이라는 세 가지를 함께 고려해야 합니다.
첫째, 계산 효율성입니다. 근사 기법에 따라 belief를 갱신하는 데 드는 시간복잡도가 크게 달라집니다. 선형 가우시안 근사 같은 일부 기법은 상태 공간의 차원에 대해 다항식 수준의 시간복잡도로 belief를 계산할 수 있습니다. 파티클 기반 기법은 계산 효율성과 정확도 사이에서 최적의 조합을 찾게 해주는 any-time 특성을 지닙니다. 반면 기법을 잘못 선택하면 시간복잡도가 기하급수적으로 늘어나는 상황을 겪을 수 있습니다.
둘째, 근사 정확도입니다. 기법마다 표현할 수 있는 분포의 범위가 다릅니다. 가우시안은 확률 분포상에서 최고점이 하나만 있는 유니모달성질을 지니고 있기 때문에 선형 가우시안 근사 기법은 유니모달 확률분포로 제한됩니다. 히스토그램 표현은 제한된 정확도로나마 멀티모달(봉오리 여러개) 확률분포를 근사할 수 있습니다. 파티클 표현은 광범위한 확률분포를 근사할 수 있지만, 원하는 정확도에 도달하기 위해 필요한 파티클의 수가 매우 커질 수 있습니다. 즉 더 넓은 범위의 분포를 더 확실하게 근사할수록 그 대가가 따릅니다.
셋째, 구현 용이함입니다. 확률적 알고리즘의 구현 난이도는 측정 확률과 상태 천이 확률이 어떤 형태를 갖느냐에 따라 천차만별입니다. 같은 알고리즘이라도 이 확률들의 형태가 단순하면 구현이 쉽고, 복잡하면 구현과 유지가 까다로워집니다. 이 또한 근사 기법을 고를 때 놓쳐서는 안 될 주요 포인트입니다.
결국 좋은 근사를 고른다는 것은 이 세 요소를 문제의 성격에 맞게 저울질하는 일입니다. belief가 대체로 하나의 봉우리에 가깝다면 선형 가우시안 기법이 효율적이고, 여러 후보가 공존하는 멀티모달 상황이라면 히스토그램이나 파티클 기반 기법이 필요합니다.
그럼 다음으로 Bayes Filter를 구현하기 가장 좋은 연구 기법인 칼만 필터를 알아보겠습니다.
Gaussian Filter
칼만 필터는 선형 가우시안 시스템에서 필터링 및 예측을 위한 기술로 Swerling과 Kalman에 의해 발명됐습니다. 칼만필터는 연속형 스테이트상에서 belief계산 방법을 구현한 것으로, 이산형 스테이트 또는 하이브리드 스테이트 공간에서는 칼만 필터를 적용할 수 없습니다.
Linear Gaussian System
칼만 필터가 성립하기 위한 전제는 정확히 세 가지입니다. 베이즈 필터가 임의의 분포에 대해 성립하는 일반적인 틀이라면, 칼만 필터는 이 틀에 세 가지 전제를 얹어 적분을 닫힌 형태(closed form)로 계산 가능하게 만든 특수해입니다.
전제 1: 상태 천이가 선형이고 노이즈가 가우시안이다
\[x_t = A_t\, x_{t-1} + B_t\, u_t + \varepsilon_t, \qquad \varepsilon_t \sim \mathcal{N}(0, R_t)\]$A_t$는 상태 천이 행렬, $B_t$는 제어 행렬이며, $\varepsilon_t$는 평균 0, 공분산 $R_t$의 가우시안 프로세스 노이즈입니다. 이를 확률분포로 쓰면 상태 천이 확률이 가우시안임을 의미합니다.
\[p(x_t \mid x_{t-1}, u_t) = \det(2\pi R_t)^{-\frac{1}{2}} \exp\left\lbrace -\tfrac{1}{2}(x_t - A_t x_{t-1} - B_t u_t)^T R_t^{-1} (x_t - A_t x_{t-1} - B_t u_t) \right\rbrace\]전제 2: 관측이 선형이고 노이즈가 가우시안이다
\[z_t = C_t\, x_t + \delta_t, \qquad \delta_t \sim \mathcal{N}(0, Q_t)\] \[p(z_t \mid x_t) = \det(2\pi Q_t)^{-\frac{1}{2}} \exp\left\lbrace -\tfrac{1}{2}(z_t - C_t x_t)^T Q_t^{-1} (z_t - C_t x_t) \right\rbrace\]전제 3: 초기 belief가 가우시안이다
\[bel(x_0) = \mathcal{N}(x_0;\ \mu_0,\ \Sigma_0)\]이 세 전제가 보장하는 것은 닫힘(closure)입니다. 가우시안끼리의 곱과 주변화(marginalization)는 다시 가우시안이 되므로, 초기 belief가 가우시안이면 베이즈 필터의 예측과 보정을 아무리 반복해도 belief는 영원히 가우시안으로 유지됩니다. 그리고 가우시안은 평균과 공분산 딱 두 개의 파라미터로 완전히 결정되므로, “분포를 계산한다”는 무한차원 문제가 “$\mu$와 $\Sigma$ 두 값을 갱신한다”는 유한한 문제로 축소됩니다. 칼만 필터가 존재할 수 있는 이유의 전부가 이 닫힘 성질에 있습니다. 다만 이 닫힘이 정말 성립하는지는 선언이 아니라 증명이 필요하며, 아래의 수학적 유도가 바로 그 증명입니다.
Kalman Filter
로켓의 연소 장치처럼 정밀한 제어가 필요하지만 극한 환경 때문에 직접 측정이 어려운 시스템이 있다고 가정해보겠습니다. 이 경우, 로켓의 동작 시스템을 설명하는 수학적 모델과 측정 가능한 다른 데이터를 결합하여 연소 장치의 상태를 추정할 수 있습니다. 그러나 이렇게 얻은 추정치는 모델의 부정확성과 측정 장비의 한계로 인해 두 가지 오차를 포함하게 됩니다. 이러한 오차를 최소화하기 위해서는 피드백 제어를 통해 추정 값을 지속적으로 보정하는 과정이 필요합니다.
이를 위해 칼만 필터는 예측 단계에서 이전 상태와 시스템 모델을 바탕으로 다음 상태를 추정하고, 업데이트(측정) 단계에서 실제 측정값과 비교하여 보정하는 방식으로 동작합니다. 이러한 과정을 반복하면 시간이 지날수록 더 정밀한 상태 추정이 가능해지며, 결과적으로 극한 환경에서도 안정적인 로켓 제어가 가능해진다
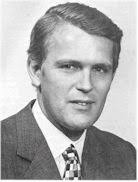
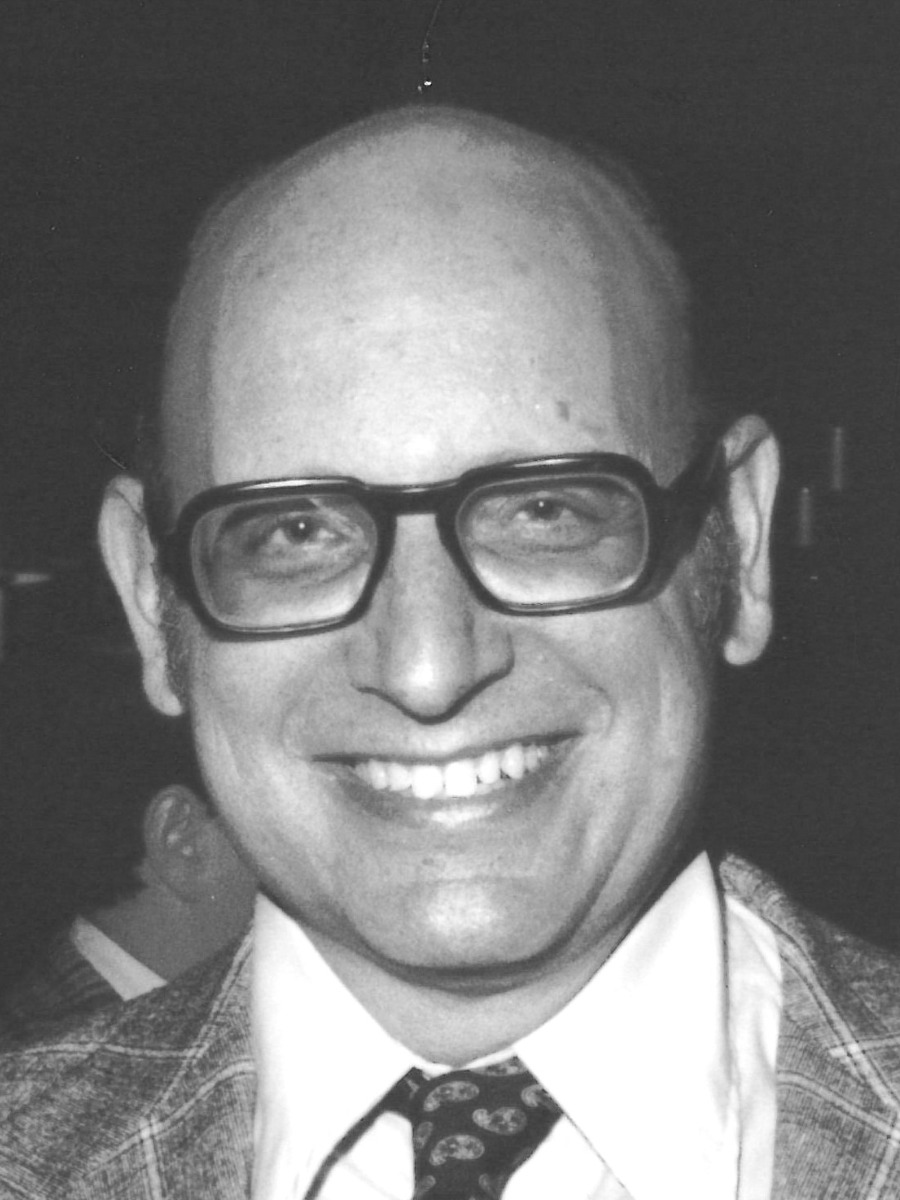
젊은시절 Donald Trump를 연상캐 하는 왼쪽 인물은 Rudolf E. Kálmán, 칼만 필터를 제안한 인물입니다. 오른쪽은 Peter Swerling, 칼만 필터를 개발한 인물입니다.
베이즈 필터 기반 예측과 보정의 분리
칼만 필터는 새로운 알고리즘이 아니라 베이즈 필터의 두 단계에 세 전제를 대입한 결과물입니다. 즉 갱신은 여전히 두 단계로 분리되어 있습니다.
\[\overline{bel}(x_t) = \int p(x_t \mid x_{t-1}, u_t) \, bel(x_{t-1}) \, dx_{t-1} \qquad \text{(예측)}\] \[bel(x_t) = \eta \, p(z_t \mid x_t) \, \overline{bel}(x_t) \qquad \text{(보정)}\]두 단계의 수학적 성격은 다릅니다. 예측은 $x_{t-1}$을 적분으로 소거하는 주변화이고, 보정은 두 분포를 곱하는 조건화입니다. 적분이 곱보다 훨씬 어렵기 때문에, 유도의 무게중심은 예측 단계에 실립니다. 예측만 넘어서면 보정은 같은 기술의 짧은 반복입니다.
1차 목표: 적분 소거
전제 1과 3을 예측 식에 대입하면, 가우시안 두 개의 곱을 적분하는 문제가 됩니다. 지수부를 하나로 합쳐 $L_t$라 하겠습니다.
\[\overline{bel}(x_t) = \eta \int \{\exp{-L_t}\} \, dx_{t-1}\] \[L_t = \tfrac{1}{2}(x_t - A_t x_{t-1} - B_t u_t)^T R_t^{-1}(x_t - A_t x_{t-1} - B_t u_t) + \tfrac{1}{2}(x_{t-1} - \mu_{t-1})^T \Sigma_{t-1}^{-1}(x_{t-1} - \mu_{t-1})\]$L_t$는 두 가우시안 지수부의 합이므로 $x_{t-1}$에 대해서도, $x_t$에 대해서도 2차식입니다. 이 사실이 이후 모든 전개의 열쇠입니다.
문제는 이 적분이 그대로는 풀리지 않는다는 것입니다. $L_t$ 안에서 $x_{t-1}$과 $x_t$가 교차항으로 엉켜 있기 때문입니다. 그런데 지수함수 적분 중 답이 닫힌 형태로 알려진 것이 하나 있습니다. 가우시안 적분입니다.
\[\int \exp\left\lbrace -\tfrac{1}{2}(x - m)^T \Psi^{-1} (x - m)\right\rbrace dx = \det(2\pi \Psi)^{\frac{1}{2}}\]따라서 전략이 정해집니다. $L_t$를 “$x_{t-1}$에 대한 완전제곱”과 “$x_{t-1}$이 없는 잔여항”으로 항등 분해하는 것입니다.
\[L_t = L_t(x_{t-1}, x_t) + L_t(x_t)\]여기서 $L_t(x_{t-1}, x_t)$는 $x_{t-1}$을 포함하는 모든 항을 모은 완전제곱 조각이고, $L_t(x_t)$는 $x_{t-1}$과 무관한 잔여 조각입니다. 주의할 점은 이 표기가 상당히 위험하다는 것입니다. 같은 글자 $L_t$가 인자 표기에 따라 서로 다른 세 함수(전체, 완전제곱 조각, 잔여 조각)를 가리킵니다. 문자 그대로 읽으면 $L_t(x_{t-1}, x_t)$는 전체 함수 그 자체로 읽히므로, 뒤에 나올 “적분이 1”이라는 명제가 모순처럼 보이게 됩니다. 원서부터 내려온 표기 남용이니, $L_t(x_{t-1}, x_t)$는 완전제곱 조각만을 가리키는 별도의 이름이라고 읽어야 합니다.
분해가 성립한다면 적분은 다음처럼 붕괴합니다.
\[\overline{bel}(x_t) = \eta \exp{-L_t(x_t)} \int \exp{-L_t(x_{t-1}, x_t)} \, dx_{t-1}\]$L_t(x_t)$는 적분변수 $x_{t-1}$과 무관하므로 적분 밖으로 나오고, 남은 적분은 가우시안 적분 공식으로 상수가 됩니다. 이제 남은 일은 완전제곱을 실제로 만들어내는 것입니다.
Hessian의 역행렬이 곧 Covariance다
완전제곱 $\tfrac{1}{2}(x_{t-1} - m)^T \Psi^{-1}(x_{t-1} - m)$을 쓰려면 두 재료가 필요합니다. 중심 $m$과 곡률 $\Psi^{-1}$입니다. 둘 다 $L_t$가 2차식이라는 사실 덕분에 미분으로 추출할 수 있습니다.
핵심 원리를 먼저 확인하겠습니다. 가우시안 $\mathcal{N}(x;\ \mu, \Sigma)$의 음의 로그, 즉 지수부는 $\tfrac{1}{2}(x-\mu)^T \Sigma^{-1}(x-\mu)$이고, 이를 두 번 미분하면
\[\frac{\partial^2}{\partial x^2} \left[ \tfrac{1}{2}(x-\mu)^T \Sigma^{-1} (x-\mu) \right] = \Sigma^{-1}\]이 나옵니다. 즉 음의 로그 밀도의 Hessian은 공분산의 역행렬이고, 뒤집으면 Hessian의 역행렬이 곧 공분산입니다. 기하적으로 Hessian은 골짜기의 곡률입니다. 곡률이 크다는 것은 최소점에서 조금만 벗어나도 음의 로그 확률이 급격히 커진다는 뜻, 즉 그 추정을 강하게 확신한다는 뜻이므로 분산은 작아야 합니다. 곡률과 불확실성은 본질적으로 역수 관계이며, 그래서 Hessian을 정보 행렬(information matrix)이라고도 부릅니다. 이 원리 하나가 칼만 필터 유도 전체에서 공분산을 읽어내는 도구로 반복 사용됩니다.
$L_t$를 $x_{t-1}$로 미분합니다.
\[\frac{\partial L_t}{\partial x_{t-1}} = -A_t^T R_t^{-1}(x_t - A_t x_{t-1} - B_t u_t) + \Sigma_{t-1}^{-1}(x_{t-1} - \mu_{t-1})\] \[\frac{\partial^2 L_t}{\partial x_{t-1}^2} = A_t^T R_t^{-1} A_t + \Sigma_{t-1}^{-1} =: \Psi_t^{-1}\]이계도함수가 상수 행렬로 떨어진 것 자체가 $L_t$가 $x_{t-1}$의 2차식이라는 증거입니다. 이 곡률에 $\Psi_t^{-1}$라는 이름을 붙입니다. 굳이 역행렬 꼴로 이름 붙이는 이유는, 방금 확인한 원리에 따라 이후 등장할 조건부 가우시안의 공분산이 $\Psi_t$가 되도록 설계한 것입니다. 참고로 $\Psi_t^{-1}$가 두 항의 합이라는 점도 의미심장합니다. 동역학을 통해 $x_t$가 주는 정보($A_t^T R_t^{-1} A_t$)와 사전 믿음이 주는 정보($\Sigma_{t-1}^{-1}$)가 더해집니다. 정보는 합산되고, 그만큼 불확실성은 줄어듭니다.
다음으로 중심 $m$입니다. 2차식에서 완전제곱의 중심은 일계도함수가 0이 되는 지점과 항상 일치하므로, $\partial L_t / \partial x_{t-1} = 0$을 풀면 됩니다.
\[A_t^T R_t^{-1}(x_t - A_t x_{t-1} - B_t u_t) = \Sigma_{t-1}^{-1}(x_{t-1} - \mu_{t-1})\]$x_{t-1}$이 든 항을 좌변으로 모읍니다.
\[\begin{aligned} A_t^T R_t^{-1}(x_t - B_t u_t) - A_t^T R_t^{-1} A_t\ x_{t-1} &= \Sigma_{t-1}^{-1} x_{t-1} - \Sigma_{t-1}^{-1} \mu_{t-1} \\\\ (A_t^T R_t^{-1} A_t + \Sigma_{t-1}^{-1})\ x_{t-1} &= A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1} \mu_{t-1} \\\\ \Psi_t^{-1}\ x_{t-1} &= A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1} \mu_{t-1} \\\\ x_{t-1} &= \Psi_t \left[ A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1} \mu_{t-1} \right] \end{aligned}\]여기서 오해하기 쉬운 지점을 짚고 가겠습니다. 이 계산은 “최적의 $x_{t-1}$을 고르는 최적화”가 아닙니다. 2차식에서 도함수가 0이 되는 해는 언제나 완전제곱의 중심 그 자체이므로, 이 계산의 정체는 $L_t$ 안에 이미 박혀 있던 중심 좌표를 추출하는 기계적 절차입니다. 그 점이 하필 최솟값이기도 한 것은 볼록 2차식에서 중심과 최소점이 같은 점이라는 부수적 사실일 뿐입니다.
완전제곱 분리와 적분의 소거
두 재료가 모였으니 완전제곱 조각을 정의합니다.
\[L_t(x_{t-1}, x_t) = \tfrac{1}{2}\left( x_{t-1} - \Psi_t[A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1}\mu_{t-1}] \right)^T \Psi_t^{-1} \left( x_{t-1} - \Psi_t[A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1}\mu_{t-1}] \right)\]이 함수는 순수한 완전제곱이므로, 정규화 상수를 붙이면 변수 $x_{t-1}$에 대한 유효한 가우시안 확률밀도함수가 됩니다. 주의할 것은 이 성질이 어떤 기존 분포에서 물려받은 것이 아니라는 점입니다. 완전제곱 꼴에 양의 정부호 곡률이면 적분이 1이 되는 것은 가우시안 적분 공식이라는 순수 미적분 사실이며, $x_t$는 중심 안에 파라미터로 앉아 있을 뿐 적분과 무관합니다. 밀도함수라는 지위는 여기서 확률적 의미를 위해서가 아니라, “밀도는 적분하면 1”이라는 성질을 적분 계산기로 쓰기 위해 동원됩니다.
\[\int \det(2\pi\Psi_t)^{-\frac{1}{2}} \{\exp{-L_t(x_{t-1}, x_t)} \} \, dx_{t-1} = 1 \quad\Longrightarrow\quad \int \{\exp{-L_t(x_{t-1}, x_t)}\} \, dx_{t-1} = \det(2\pi\Psi_t)^{\frac{1}{2}}\]적분 결과가 타깃 변수 $x_t$와 무관한 상수라는 점이 결정적입니다. 이 상수를 정규화 상수 $\eta$에 흡수시키면 적분이 완전히 사라집니다.
\[\overline{bel}(x_t) = \eta \exp{-L_t(x_t)}\]이제 잔여항 $L_t(x_t)$를 구할 차례입니다. 정의상 전체에서 완전제곱 조각을 뺀 차입니다.
\[L_t(x_t) = L_t - L_t(x_{t-1}, x_t)\]그런데 여기서 정당한 의문이 생깁니다. 이렇게 뺀 결과에 정말 $x_{t-1}$이 하나도 안 남는다는 보장이 있습니까? 보장은 저절로 오지 않고 검산으로 확정됩니다. 양쪽을 전부 전개해 $x_{t-1}$의 차수별로 모으면 다음과 같습니다. 전체 $L_t$에서 나오는 $x_{t-1}$ 항은
\[\underbrace{\tfrac{1}{2} x_{t-1}^T A_t^T R_t^{-1} A_t\, x_{t-1} + \tfrac{1}{2} x_{t-1}^T \Sigma_{t-1}^{-1} x_{t-1}}_{\text{2차항}} \underbrace{-\ x_{t-1}^T A_t^T R_t^{-1}(x_t - B_t u_t) - x_{t-1}^T \Sigma_{t-1}^{-1}\mu_{t-1}}_{\text{1차항}}\]이고, 완전제곱 조각을 빼면서 나오는 $x_{t-1}$ 항은 부호가 반전되어
\[-\tfrac{1}{2} x_{t-1}^T (A_t^T R_t^{-1} A_t + \Sigma_{t-1}^{-1})\, x_{t-1} + x_{t-1}^T \left[ A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1}\mu_{t-1} \right]\]입니다. 2차항끼리 보면 $\Psi_t^{-1} = A_t^T R_t^{-1} A_t + \Sigma_{t-1}^{-1}$이므로 정확히 소거되고, 1차항끼리 보면 대괄호가 전체 쪽 1차항의 합과 동일하므로 역시 소거됩니다. 이 소거는 우연이 아니라 설계입니다. 곡률을 이계도함수로, 중심을 일계도함수의 영점으로 정의한 순간 이 상쇄는 예약되어 있었습니다. 살아남는 것은 $x_{t-1}$이 원래 없던 항들과, 완전제곱을 빼며 딸려 나온 중심값 보정항뿐입니다.
\[L_t(x_t) = \tfrac{1}{2}(x_t - B_t u_t)^T R_t^{-1}(x_t - B_t u_t) + \tfrac{1}{2}\mu_{t-1}^T \Sigma_{t-1}^{-1}\mu_{t-1} - \tfrac{1}{2}\left[ A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1}\mu_{t-1} \right]^T \Psi_t \left[ A_t^T R_t^{-1}(x_t - B_t u_t) + \Sigma_{t-1}^{-1}\mu_{t-1} \right]\]중요한 것은 잔여항이 버려지지 않았다는 사실입니다. 스칼라 평방완성 $\tfrac{1}{2}ax^2 - bx = \tfrac{1}{2}a(x - b/a)^2 - b^2/2a$에서 마지막 보정항이 반드시 남듯, 여기서도 $x_{t-1}$ 문제에서 밀려난 정보가 전부 $L_t(x_t)$로 이사했고, 이것이 그대로 $\overline{bel}(x_t)$의 지수부가 됩니다.
예측 분포 끝내기
$L_t(x_t)$는 $x_t$의 2차식입니다. 따라서 $\overline{bel}(x_t) = \eta\exp{-L_t(x_t)}$는 가우시안 밀도의 꼴이며, 이는 가정이 아니라 방금 계산으로 도출된 결론입니다. 남은 일은 이 가우시안의 평균과 공분산을 읽어내는 것인데, 방법은 앞과 완전히 동일합니다. 이계도함수로 곡률을, 일계도함수의 영점으로 중심을 추출합니다. 같은 기술이 변수만 바꿔 두 번째로 재사용되는 것입니다.
\[\frac{\partial L_t(x_t)}{\partial x_t} = \left[ R_t^{-1} - R_t^{-1} A_t \Psi_t A_t^T R_t^{-1} \right](x_t - B_t u_t) - R_t^{-1} A_t \Psi_t \Sigma_{t-1}^{-1} \mu_{t-1}\] \[\frac{\partial^2 L_t(x_t)}{\partial x_t^2} = R_t^{-1} - R_t^{-1} A_t (A_t^T R_t^{-1} A_t + \Sigma_{t-1}^{-1})^{-1} A_t^T R_t^{-1}\]이대로도 수학적으로는 완결입니다. 이 3중 역행렬 덩어리의 역을 취하면 공분산이 나오고 값도 정확합니다. 그러나 이 꼴로는 물리적 의미가 전혀 보이지 않고, 다음 타임스텝의 입력으로 넣으면 식이 스텝마다 눈덩이처럼 불어나 재귀가 닫히지 않습니다. 여기서 역행렬 정리(matrix inversion lemma, Sherman-Morrison-Woodbury)가 투입됩니다.
\[\left( R + A \Sigma A^T \right)^{-1} = R^{-1} - R^{-1} A \left( A^T R^{-1} A + \Sigma^{-1} \right)^{-1} A^T R^{-1}\]우변이 정확히 위의 곡률이므로,
\[\frac{\partial^2 L_t(x_t)}{\partial x_t^2} = (R_t + A_t \Sigma_{t-1} A_t^T)^{-1}\]Hessian의 역행렬이 공분산이라는 원리를 적용하면 예측 공분산이 즉시 나옵니다.
\[\bar\Sigma_t = R_t + A_t \Sigma_{t-1} A_t^T\]이제야 의미가 읽힙니다. 사전 불확실성이 동역학을 타고 전파되고($A_t \Sigma_{t-1} A_t^T$), 거기에 프로세스 노이즈($R_t$)가 쌓입니다. 로봇이 움직이면 위치를 더 모르게 되는 것이 사실이고, 필터는 그 사실을 공분산 증가로 정직하게 기록합니다.
평균은 일계도함수를 0으로 놓고 풉니다.
\[(R_t + A_t \Sigma_{t-1} A_t^T)^{-1}(x_t - B_t u_t) = R_t^{-1} A_t \Psi_t \Sigma_{t-1}^{-1} \mu_{t-1}\] \[\bar\mu_t = B_t u_t + (R_t + A_t \Sigma_{t-1} A_t^T)\, R_t^{-1} A_t \Psi_t \Sigma_{t-1}^{-1} \mu_{t-1}\]복잡해 보이지만 $\mu_{t-1}$ 앞의 행렬 덩어리는 통째로 $A_t$로 붕괴합니다.
\[(R_t + A_t \Sigma_{t-1} A_t^T) R_t^{-1} A_t = A_t + A_t \Sigma_{t-1} A_t^T R_t^{-1} A_t = A_t \Sigma_{t-1}(\Sigma_{t-1}^{-1} + A_t^T R_t^{-1} A_t) = A_t \Sigma_{t-1} \Psi_t^{-1}\]이므로 $\Psi_t \Sigma_{t-1}^{-1}$과 만나 $A_t \Sigma_{t-1} \Psi_t^{-1} \Psi_t \Sigma_{t-1}^{-1} = A_t$가 됩니다. 따라서
\[\bar\mu_t = A_t \mu_{t-1} + B_t u_t\]몇 페이지짜리 유도의 결론이 허무할 만큼 직관적입니다. 예측 평균은 이전 평균을 동역학에 그대로 통과시킨 것입니다. 정리하면 예측 단계는 다음 두 줄로 완성됩니다.
\[\bar\mu_t = A_t \mu_{t-1} + B_t u_t, \qquad \bar\Sigma_t = A_t \Sigma_{t-1} A_t^T + R_t\]강조하고 싶은 것은 이 전 과정에 근사가 단 하나도 없었다는 점입니다. 평방완성은 항등 분해이고, 적분 트릭은 가우시안 적분 공식이며, 역행렬 정리는 항등식입니다. 선형 가우시안 전제 하에서 칼만 필터의 예측은 정확(exact)합니다.
칼만 이득
보정은 곱입니다. 적분이 없으므로 완전제곱 분리 트릭이 필요 없고, 지수부를 합친 뒤 미분 두 번이면 끝납니다. 전제 2와 방금 구한 예측 분포를 곱하면
\[bel(x_t) = \eta p(z_t \mid x_t)\overline{bel}(x_t) = \eta \exp{-J_t}\] \[J_t = \tfrac{1}{2}(z_t - C_t x_t)^T Q_t^{-1}(z_t - C_t x_t) + \tfrac{1}{2}(x_t - \bar\mu_t)^T \bar\Sigma_t^{-1}(x_t - \bar\mu_t)\]$J_t$는 $x_t$의 2차식이므로 $bel(x_t)$도 가우시안입니다. 같은 기술을 세 번째로 적용합니다.
\[\frac{\partial J_t}{\partial x_t} = -C_t^T Q_t^{-1}(z_t - C_t x_t) + \bar\Sigma_t^{-1}(x_t - \bar\mu_t)\] \[\frac{\partial^2 J_t}{\partial x_t^2} = C_t^T Q_t^{-1} C_t + \bar\Sigma_t^{-1}\]곡률이 또 두 정보의 합입니다. 관측이 주는 정보($C_t^T Q_t^{-1} C_t$)와 예측이 주는 정보($\bar\Sigma_t^{-1}$)가 더해지며, Hessian의 역이 공분산이므로
\[\Sigma_t = \left( C_t^T Q_t^{-1} C_t + \bar\Sigma_t^{-1} \right)^{-1}\]정보가 더해졌으니 $\Sigma_t$는 $\bar\Sigma_t$보다 반드시 작습니다. 예측에서 퍼졌던 belief가 관측으로 다시 좁혀지는 호흡이 수식으로 확인되는 순간입니다.
평균은 일계도함수를 $\mu_t$에서 0으로 놓습니다.
\[C_t^T Q_t^{-1}(z_t - C_t \mu_t) = \bar\Sigma_t^{-1}(\mu_t - \bar\mu_t)\]좌변을 예측 평균 $\bar\mu_t$ 기준으로 갈라 쓰면
\[C_t^T Q_t^{-1}(z_t - C_t \mu_t) = C_t^T Q_t^{-1}\left( z_t - C_t \bar\mu_t \right) - C_t^T Q_t^{-1} C_t (\mu_t - \bar\mu_t)\]이를 대입해 $(\mu_t - \bar\mu_t)$로 묶으면
\[C_t^T Q_t^{-1}(z_t - C_t \bar\mu_t) = \left( C_t^T Q_t^{-1} C_t + \bar\Sigma_t^{-1} \right)(\mu_t - \bar\mu_t) = \Sigma_t^{-1}(\mu_t - \bar\mu_t)\] \[\mu_t = \bar\mu_t + \underbrace{\Sigma_t C_t^T Q_t^{-1}}_{=:\ K_t} (z_t - C_t \bar\mu_t)\]여기서 칼만 이득(Kalman gain) $K_t = \Sigma_t C_t^T Q_t^{-1}$이 자연스럽게 존재를 드러냅니다. 괄호 안의 $z_t - C_t \bar\mu_t$는 혁신(innovation)이라 불리는 양으로, 실제 관측과 예측된 관측의 차이, 즉 예측이 틀린 정도입니다. 칼만 이득은 이 관측 공간의 오차를 상태 공간의 수정량으로 바꾸는 환산 비율이며, 그 크기는 예측과 관측 중 어느 쪽을 더 믿을지를 자동으로 결정합니다. 관측 노이즈 $Q_t$가 작을수록(관측이 정확할수록) 이득이 커져 관측을 크게 반영하고, 예측이 이미 확실할수록($\Sigma_t$가 작을수록) 이득이 작아져 조금만 움직입니다. 뉴턴법에서 기울기에 (이계도함수)$^{-1}$을 곱해 이동량을 정하던 것과 완전히 같은 구조가 여기서도 반복됩니다.
공분산과 이득 정리
남은 것은 표기 정리입니다. 현재의 $K_t = \Sigma_t C_t^T Q_t^{-1}$와 $\Sigma_t = (C_t^T Q_t^{-1} C_t + \bar\Sigma_t^{-1})^{-1}$는 값은 정확하지만 역행렬 계산이 상태 차원의 큰 행렬에 걸려 있고 형태도 재귀에 불편합니다. 먼저 이득을 $\Sigma_t$ 없이 표현합니다. 항등원 $(C_t \bar\Sigma_t C_t^T + Q_t)(C_t \bar\Sigma_t C_t^T + Q_t)^{-1}$을 오른쪽에 끼워 넣고 전개하면
\[\begin{aligned} K_t &= \Sigma_t C_t^T Q_t^{-1} \left( C_t \bar\Sigma_t C_t^T + Q_t \right)\left( C_t \bar\Sigma_t C_t^T + Q_t \right)^{-1} \\\\ &= \Sigma_t \left( C_t^T Q_t^{-1} C_t \bar\Sigma_t C_t^T + C_t^T \right)\left( C_t \bar\Sigma_t C_t^T + Q_t \right)^{-1} \\\\ &= \Sigma_t \left( C_t^T Q_t^{-1} C_t + \bar\Sigma_t^{-1} \right) \bar\Sigma_t C_t^T \left( C_t \bar\Sigma_t C_t^T + Q_t \right)^{-1} \\\\ &= \Sigma_t\, \Sigma_t^{-1}\, \bar\Sigma_t C_t^T \left( C_t \bar\Sigma_t C_t^T + Q_t \right)^{-1} \\\\ &= \bar\Sigma_t C_t^T \left( C_t \bar\Sigma_t C_t^T + Q_t \right)^{-1} \end{aligned}\]역행렬이 관측 공간 차원으로 내려왔습니다. 관측 차원이 상태 차원보다 작은 경우가 대부분이므로 계산상 큰 이득입니다. 다음으로 공분산입니다. $\Sigma_t = (C_t^T Q_t^{-1} C_t + \bar\Sigma_t^{-1})^{-1}$에 역행렬 정리를 다시 적용하면
\[\Sigma_t = \bar\Sigma_t - \bar\Sigma_t C_t^T \left( Q_t + C_t \bar\Sigma_t C_t^T \right)^{-1} C_t \bar\Sigma_t\]가 되고, 방금 정리한 $K_t$의 표현이 그대로 안에 들어있음을 알아채면
\[\Sigma_t = \left( I - K_t C_t \right) \bar\Sigma_t\]로 압축됩니다. 예측 공분산에서 관측이 가져다준 정보만큼 깎아내는 형태입니다. 예측 단계에서와 마찬가지로 이 정리 과정 역시 근사가 아니라 항등 변형이며, 목적은 값의 변경이 아니라 재귀에 적합하고 의미가 읽히는 닫힌 꼴을 얻는 것입니다.
칼만 필터 알고리즘
이상의 유도를 모으면 칼만 필터는 다섯 줄로 완성됩니다. 입력은 직전 belief $(\mu_{t-1}, \Sigma_{t-1})$과 제어 $u_t$, 관측 $z_t$이고, 출력은 새 belief $(\mu_t, \Sigma_t)$입니다.
\[\begin{aligned} \bar\mu_t &= A_t \mu_{t-1} + B_t u_t \\\\ \bar\Sigma_t &= A_t \Sigma_{t-1} A_t^T + R_t \\\\ K_t &= \bar\Sigma_t C_t^T \left( C_t \bar\Sigma_t C_t^T + Q_t \right)^{-1} \\\\ \mu_t &= \bar\mu_t + K_t \left( z_t - C_t \bar\mu_t \right) \\\\ \Sigma_t &= \left( I - K_t C_t \right) \bar\Sigma_t \end{aligned}\]앞의 두 줄이 예측, 뒤의 세 줄이 보정입니다. 출력 $(\mu_t, \Sigma_t)$는 다음 타임스텝에서 입력 자리로 들어가 재귀가 영원히 돕니다. 유도 전체를 관통한 뼈대는 결국 하나였습니다. 선형 가우시안 전제 하에서 음의 로그 belief는 언제나 2차식이고, 2차식이면 이계도함수(Hessian)의 역으로 공분산을, 일계도함수의 영점으로 평균을 기계적으로 읽어낼 수 있으며, 유일한 난관이었던 예측 단계의 적분은 완전제곱 분리로 상수화하여 소거합니다. 이 뼈대는 변수만 바꿔 세 번($x_{t-1}$, 예측의 $x_t$, 보정의 $x_t$) 반복되었습니다.
Extended Kalman Filter
선형성이 무너지는 순간
칼만 필터의 세 전제 중 현실에서 가장 먼저 깨지는 것이 선형성입니다. 일정한 병진·회전 속도로 움직이는 로봇만 해도 원호를 그리며 이동하므로 상태 천이에 삼각함수가 들어가고, 거리·베어링 센서의 관측 모델에도 비선형이 낍니다. 실제 시스템의 상태 천이와 관측은 일반적으로 비선형 함수 $g$와 $h$로 기술됩니다.
\[x_t = g(u_t, x_{t-1}) + \varepsilon_t, \qquad z_t = h(x_t) + \delta_t\]이 순간 칼만 필터의 유도가 정확히 어디서 무너지는지 보겠습니다. 유도의 뼈대는 “음의 로그 belief가 2차식”이라는 사실이었습니다. 그런데 $g$가 비선형이면 지수부의 $(x_t - g(u_t, x_{t-1}))^T R_t^{-1} (\cdots)$가 $x_{t-1}$에 대해 더 이상 2차식이 아닙니다. 2차식이 아니면 이계도함수가 상수가 아니게 되어 완전제곱 분리가 불가능하고, 가우시안 적분 공식을 끼울 자리가 사라지며, 평균·공분산을 미분으로 읽어내는 패턴 매칭 전체가 근거를 잃습니다. 분포의 관점에서 말하면, 가우시안을 비선형 함수에 통과시킨 결과는 가우시안이 아닙니다. 닫힘 성질이 깨지는 것입니다.
테일러 전개를 통한 선형화
EKF의 아이디어는 정면 돌파가 아니라 국소적 타협입니다. 비선형 함수를 현재 추정치 주변에서 1차 테일러 전개로 근사하는 것입니다. 함수를 통째로 직선(초평면)으로 바꾸는 것이 아니라, 지금 belief가 몰려 있는 지점 근처에서만 접선으로 대체합니다.
상태 천이 함수는 가장 그럴듯한 지점, 즉 직전 평균 $\mu_{t-1}$에서 전개합니다.
\[g(u_t, x_{t-1}) \approx g(u_t, \mu_{t-1}) + G_t \left( x_{t-1} - \mu_{t-1} \right), \qquad G_t := \left. \frac{\partial g(u_t, x_{t-1})}{\partial x_{t-1}} \right|_{x_{t-1} = \mu_{t-1}}\]관측 함수는 예측 평균 $\bar\mu_t$에서 전개합니다.
\[h(x_t) \approx h(\bar\mu_t) + H_t \left( x_t - \bar\mu_t \right), \qquad H_t := \left. \frac{\partial h(x_t)}{\partial x_t} \right|_{x_t = \bar\mu_t}\]$G_t$와 $H_t$는 자코비안(Jacobian) 행렬입니다. 선형 칼만 필터에서 상수 행렬이던 $A_t$, $C_t$의 자리를, 매 타임스텝 현재 추정치에서 새로 계산되는 접선 기울기가 대신하는 셈입니다. 이 근사를 대입하는 순간 지수부는 다시 2차식이 되고, 앞 절에서 완성한 유도 기계가 그대로 재가동됩니다. 따라서 EKF의 수학적 유도는 칼만 필터와 동일하며 새로 증명할 것이 없습니다.
EKF 알고리즘
\[\begin{aligned} \bar\mu_t &= g(u_t, \mu_{t-1}) \\\\ \bar\Sigma_t &= G_t \Sigma_{t-1} G_t^T + R_t \\\\ K_t &= \bar\Sigma_t H_t^T \left( H_t \bar\Sigma_t H_t^T + Q_t \right)^{-1} \\\\ \mu_t &= \bar\mu_t + K_t \left( z_t - h(\bar\mu_t) \right) \\\\ \Sigma_t &= \left( I - K_t H_t \right) \bar\Sigma_t \end{aligned}\]칼만 필터와의 차이는 정확히 두 종류입니다. 첫째, 평균의 전파는 근사 없이 진짜 비선형 함수를 씁니다. 예측 평균은 $g(u_t, \mu_{t-1})$이고, 혁신은 $z_t - h(\bar\mu_t)$입니다. 평균이라는 한 점을 통과시키는 데에는 선형화가 필요 없기 때문입니다. 둘째, 공분산의 전파와 칼만 이득은 자코비안 $G_t$, $H_t$를 씁니다. 분포의 퍼짐을 통과시키는 데에는 함수의 국소 기울기가 필요하기 때문입니다. 요약하면 점은 비선형 그대로, 퍼짐은 접선으로 흘려보내는 것이 EKF입니다.
선형화로 인한 Trade Off
칼만 필터의 유도가 항등 변형의 연쇄였다면, EKF는 테일러 전개라는 근사가 개입한 첫 지점입니다. 이 차이의 결과는 가볍지 않습니다. 칼만 필터가 선형 가우시안 시스템에서 최적 추정기인 반면, EKF가 계산하는 것은 참 belief(비가우시안)의 가우시안 근사일 뿐이며 최적성 보장이 사라집니다.
근사의 품질은 두 요인이 좌우합니다. 첫째는 국소 비선형성의 정도입니다. 전개 지점 근처에서 함수가 접선과 많이 벌어질수록 근사가 나빠집니다. 둘째는 불확실성의 크기입니다. belief가 넓게 퍼져 있으면 접선이 유효한 좁은 구간을 벗어난 영역까지 분포가 걸치므로, 같은 함수라도 공분산이 클수록 선형화 오차가 커집니다. 불확실성이 작게 유지되는 시스템일수록 EKF가 잘 동작하는 이유입니다.
구조적인 약점도 있습니다. 선형화 지점이 추정 평균이라는 점입니다. 추정이 이미 틀려 있으면 엉뚱한 지점의 접선으로 공분산을 전파하게 되고, 이것이 추정을 더 틀리게 만드는 악순환으로 이어질 수 있습니다. 필터 발산(divergence)의 전형적인 경로입니다. 또한 EKF는 가우시안이라는 유니모달 표현을 유지하므로, 후보가 여러 개 공존하는 멀티모달 상황은 원리적으로 표현하지 못합니다.
그럼에도 EKF가 오랫동안 로보틱스 상태 추정의 표준이었던 이유는 명확합니다. 자코비안 계산이 추가될 뿐 계산 복잡도가 칼만 필터와 같은 수준이고, 비선형성이 완만하고 불확실성이 작은 영역에서는 근사가 충분히 정확하기 때문입니다. 선형화를 접선 하나가 아니라 분포의 샘플들로 수행해 근사 품질을 높이려는 시도가 다음에 다룰 무향 칼만 필터(UKF)이고, 가우시안 표현 자체를 포기하는 것이 파티클 필터입니다. 결국 이후의 필터들은 전부 “EKF의 근사를 어떻게 개선할 것인가”라는 질문에 대한 서로 다른 답인 셈입니다.
Non-Parametric Filter
가우시안 필터 계열의 공통 전제는 belief를 고정된 함수 형태, 즉 평균과 공분산이라는 파라미터에 가둔다는 것이었습니다. 비모수 필터(non-parametric filter)는 이 전제를 버립니다. belief를 어떤 함수 형태로도 강제하지 않고, 상태 공간을 유한 개의 조각으로 근사해 표현합니다. 상태 공간을 격자로 잘라 조각마다 확률을 부여하면 히스토그램 필터(histogram filter)가 되고, 상태 공간에서 뽑은 샘플들의 무리로 분포를 그리면 이 절의 주인공인 파티클 필터(particle filter)가 됩니다.
파라미터를 버린 대가와 보상은 명확합니다. 보상은 표현력입니다. 봉우리가 여러 개인 멀티모달 분포든 비대칭 분포든, 조각 수만 충분하면 근사할 수 있습니다. EKF가 원리적으로 표현하지 못하던, 후보가 여러 곳에 공존하는 상황을 자연스럽게 담습니다. 대가는 계산입니다. 조각 수에 비례해 비용이 늘고, 원하는 정확도에 필요한 조각 수는 상태 차원에 따라 폭발할 수 있습니다. 다만 조각 수를 실행 중에 조절할 수 있다는 any-time 특성 덕분에, 정확도와 효율의 저울질을 상황에 맞춰 실시간으로 할 수 있다는 것이 실무적 매력입니다.
Particle Filter
특성
Particle filter는 belief를 상태 공간의 샘플 집합으로 표현합니다. 샘플 하나를 파티클(particle)이라 부르며, belief는 $M$개 파티클의 집합입니다.
\[\mathcal{X}_t := \{x_t^{[1]}, x_t^{[2]}, \ldots, x_t^{[M]} \}\]파티클 하나는 로봇이 여기 있을지도 모른다는 가설 하나입니다. 확률이 높은 영역일수록 파티클이 빽빽하게 몰리고, 낮은 영역은 성기게 덮입니다. 분포의 모양을 파라미터가 아니라 밀도 그 자체로 그리는 것입니다. 이상적으로 우리가 원하는 상태는 파티클들이 belief에서 뽑은 샘플처럼 분포하는 것입니다.
\[x_t^{[m]} \sim p(x_t \mid z_{1:t}, u_{1:t}) = bel(x_t)\]이 표현 방식 하나가 particle filter의 특성 전부를 결정합니다. 첫째, 멀티모달입니다. 대칭 복도에서 후보 위치가 세 곳이면 파티클 구름이 세 덩어리로 갈라져 공존하다가, 결정적인 관측이 들어오는 순간 두 덩어리가 소멸합니다. 유니모달에 묶인 가우시안 필터가 원리적으로 못 하는 동작입니다. 둘째, 비선형에 근사가 필요 없습니다. EKF 절에서 평균이라는 한 점을 통과시키는 데에는 선형화가 필요 없다고 했는데, 파티클은 전부가 점입니다. 비선형 함수에 그냥 넣으면 되고, 분포의 퍼짐은 접선이 아니라 샘플들의 실제 이동으로 전파됩니다. 자코비안이 등장할 자리가 없습니다. 셋째, 근사 오차가 파티클 수 $M$으로 제어됩니다. $M \to \infty$에서 참 belief로 수렴하고, $M$을 줄이면 정확도를 내주고 속도를 얻습니다.
개념
Particle filter는 베이즈 필터의 예측과 보정을 파티클 집합 위에서 구현한 것입니다. 직전 집합 $\mathcal{X}_{t-1}$과 제어 $u_t$, 관측 $z_t$를 받아 새 집합 $\mathcal{X}_t$를 만드는 한 스텝은 세 동작으로 이뤄집니다.
첫째, 예측입니다. 파티클마다 상태 천이 모델에서 다음 상태를 샘플링합니다.
\[x_t^{[m]} \sim p(x_t \mid u_t,\ x_{t-1}^{[m]})\]제어 명령대로 파티클을 밀되 이동 노이즈를 난수로 섞는 것입니다. 명령이 같아도 노이즈가 파티클마다 다르게 뽑히므로 구름이 퍼집니다. 베이즈 필터의 예측 단계가 belief를 흐리게 만들던 그 동작이, 여기서는 문자 그대로 구름의 확산으로 나타납니다.
둘째, 가중치 갱신(weight update)입니다. 파티클마다 방금 들어온 관측과의 부합도를 중요도 가중치(importance weight)로 계산합니다.
\[w_t^{[m]} = p(z_t \mid x_t^{[m]})\]미리 말해두면, 이 한 줄이 particle filter의 심장입니다. 예측 샘플링은 이동 모델에 난수를 넣는 기계적 작업이고 뒤에 올 리샘플링은 관리 작업인 반면, 베이즈 필터의 보정, 즉 관측으로 belief를 갱신하는 일 전체가 이 가중치 한 줄에 실려 있습니다. 앞 장에서 만든 측정 모델 $q$가 소켓에 꽂히는 자리가 정확히 여기이며, 왜 하필 관측 우도가 가중치가 되는지는 아래 수학적 증명의 결론으로 밝혀집니다.
셋째, 리샘플링(resampling)입니다. 가중치에 비례하는 확률로 파티클을 복원추출해 $M$개를 다시 뽑습니다. 점수 높은 파티클은 여러 번 복제되고 낮은 파티클은 뽑히지 못해 소멸하며, 새 집합의 가중치는 모두 같게 초기화됩니다. 관측이라는 증거가 구름을 그럴듯한 영역으로 조여내는 것이고, 예측에서 퍼지고 보정에서 좁혀지는 베이즈 필터의 호흡이 파티클의 확산과 도태로 재연됩니다.
전체 알고리즘을 의사코드로 정리하면 다음과 같습니다.
\[\begin{aligned} &\text{Algorithm Particle filter}(\mathcal{X}_{t-1}, u_t, z_t): \\\\ &\quad \bar{\mathcal{X}}_t = \mathcal{X}_t = \emptyset \\\\ &\quad \text{for } m = 1 \text{ to } M \text{:} \\\\ &\qquad \text{sample } x_t^{[m]} \sim p(x_t \mid u_t,\ x_{t-1}^{[m]}) \\\\ &\qquad w_t^{[m]} = p(z_t \mid x_t^{[m]}) \\\\ &\qquad \bar{\mathcal{X}}_t = \bar{\mathcal{X}}_t + \langle x_t^{[m]},\ w_t^{[m]} \rangle \\\\ &\quad \text{for } m = 1 \text{ to } M \text{:} \\\\ &\qquad \text{draw } i \text{ with probability } \propto w_t^{[i]} \\\\ &\qquad \text{add } x_t^{[i]} \text{ to } \mathcal{X}_t \\\\ &\quad \text{return } \mathcal{X}_t \end{aligned}\]중간 산물 $\bar{\mathcal{X}}_t$가 예측 belief $\overline{bel}(x_t)$의 파티클 표현이고, 리샘플링을 거친 $\mathcal{X}_t$가 사후 belief $bel(x_t)$의 파티클 표현입니다. 그런데 이 대응이 정말 성립합니까? 파티클을 이동 모델에서 뽑아놓고, 왜 관측 우도를 곱해 리샘플링하면 사후분포의 샘플이 됩니까? 칼만 필터의 닫힘 성질이 그랬듯 이것도 선언이 아니라 증명이 필요한 명제이며, 증명의 뼈대는 중요도 샘플링(importance sampling)이라는 원리 하나입니다.
수학적 증명
증명은 세 단계로 갑니다. 먼저 importance sampling이라는 일반 원리를 증명하고, 다음으로 particle filter의 가중치가 정확히 그 원리에서 유도됨을 보이며, 마지막으로 리샘플링이 가중 표본을 비가중 표본으로 바꾸는 정당한 절차임을 확인합니다. 유도의 무게중심은 두 번째 단계, 즉 가중치의 신분 증명에 있습니다.
1단계, importance sampling의 원리부터 세우겠습니다. 목표 분포(target distribution) $f$에서 샘플을 뽑고 싶은데 $f$에서 직접 뽑을 수는 없고, 대신 제안 분포(proposal distribution) $g$에서는 뽑을 수 있다고 하겠습니다. 단 하나의 조건은 $f(x) > 0$이면 $g(x) > 0$이어야 한다는 것입니다. 제안이 덮지 못하는 영역은 영원히 샘플링되지 않으므로, 목표가 살아 있는 곳을 제안이 빠짐없이 덮어야 합니다. 이제 $g$에서 뽑은 샘플에 두 분포의 비율을 가중치로 부여합니다.
\[x^{[m]} \sim g, \qquad w^{[m]} = \frac{f(x^{[m]})}{g(x^{[m]})}\]이 가중 표본이 $f$를 올바르게 표현한다는 것이 핵심 명제입니다. 임의의 사건 $A$에 대해, 지시함수 $\mathbf{1}_A$를 붙인 가중치의 기대값을 계산해 보겠습니다. 샘플이 $g$를 따르므로 기대값은 $g$에 대한 적분입니다.
\[\begin{aligned} E_g\left[ w(x)\, \mathbf{1}_A(x) \right] &= \int w(x)\, \mathbf{1}_A(x)\, g(x)\, dx \\\\[4pt] &= \int \frac{f(x)}{g(x)}\, \mathbf{1}_A(x)\, g(x)\, dx \\\\[4pt] &= \int_A f(x)\, dx \\\\[4pt] &= P_f(A) \end{aligned}\]$g$가 분모와 분자에서 정확히 소거되는 둘째 줄이 증명의 전부입니다. 가중치를 확률 질량처럼 취급해 사건 $A$에 떨어진 가중치를 세면, 그 기대값은 목표 분포가 $A$에 부여하는 확률과 일치합니다. 잘못된 분포에서 뽑았다는 죄를 가중치가 정확히 사면하는 것입니다. 대수의 법칙에 의해 표본 평균은 기대값으로 수렴하므로, $M \to \infty$에서 가중 표본은 $f$의 어떤 확률도 올바르게 재현합니다. 특수한 경우로 $A$를 전체 공간으로 잡으면
\[E_g[w] = \int f(x)\, dx = 1\]가중치의 기대값이 1이라는 이 사실은 3단계에서 다시 쓰입니다.
여기에 실용적으로 중요한 성질 하나를 미리 확인해 두겠습니다. 목표를 정규화 상수까지 알 필요가 없다는 것입니다. $f = \eta f’$처럼 비례 상수 $\eta$를 모르는 채 $f’$만 계산할 수 있다고 하겠습니다. $f’$로 만든 가중치를 $w’ = f’/g$라 하면, 실제 알고리즘이 쓰는 것은 개별 가중치가 아니라 합으로 나눈 정규화 가중치이므로
\[\frac{w^{[m]}}{\sum_{j} w^{[j]}} = \frac{\eta\, w'^{[m]}}{\sum_{j} \eta\, w'^{[j]}} = \frac{w'^{[m]}}{\sum_{j} w'^{[j]}}\]$\eta$가 분자와 분모에 공통으로 나타나 소거됩니다. 즉 정규화 가중치는 $\eta$를 몰라도 정확히 같은 값이 나옵니다. 베이즈 정리의 정규화 항이 골칫거리였던 것을 기억하면, 이 소거는 뒤에서 요긴하게 쓰일 복선입니다.
2단계, particle filter의 가중치를 유도하겠습니다. 먼저 목표와 제안이 무엇인지 특정해야 하는데, 여기에 미묘한 문제가 하나 있습니다. 시각 $t$의 파티클은 조상 파티클 $x_{t-1}^{[m]}$ 위에 이동 샘플을 얹어 만들어지므로, 파티클 하나의 정체는 사실 상태 하나가 아니라 조상까지 이어진 궤적 $x_{0:t}^{[m]}$입니다. 뽑기가 궤적 공간에서 일어났으니 증명도 궤적 공간에서 세우는 것이 정확합니다. 목표는 궤적 전체에 대한 사후분포입니다.
\[f = p(x_{0:t} \mid z_{1:t},\ u_{1:t})\]제안은 알고리즘이 실제로 하는 일 그 자체를 적으면 됩니다. 직전 스텝의 파티클이 직전 사후분포를 표현한다고 가정하고(귀납 가정, 기저는 초기 belief에서의 샘플링이다), 그 궤적 끝에 이동 모델 샘플 하나를 이어 붙입니다. 두 뽑기가 순차적으로 일어나므로 제안 분포는 두 분포의 곱입니다.
\[g = p(x_t \mid x_{t-1},\ u_t)p(x_{0:t-1} \mid z_{1:t-1},\ u_{1:t-1})\]이제 가중치 $w = f/g$를 계산합니다. 전략은 베이즈 필터의 수학적 유도에서 했던 것과 동일합니다. 목표에서 최신 관측 $z_t$를 분리해 베이즈 정리를 적용하고, 마르코프 가정으로 조건을 정리하는 것입니다. 다른 점은 상태 하나가 아니라 궤적 전체에 대해 같은 조작을 한다는 것뿐입니다. 먼저 $z_t$에 대한 베이즈 정리를 쓰고, $x_{0:t}$를 포함하지 않는 분모를 정규화 상수 $\eta$로 묶으면
\[p(x_{0:t} \mid z_{1:t},\ u_{1:t}) = \eta p(z_t \mid x_{0:t},\ z_{1:t-1},\ u_{1:t})p(x_{0:t} \mid z_{1:t-1},\ u_{1:t})\]우변 첫 항에 관측 모델의 마르코프 가정을 적용합니다. 베이즈 필터 유도에서 확인했듯 현재 상태 $x_t$가 주어지면 관측은 그 외의 모든 과거와 조건부 독립이므로
\[p(z_t \mid x_{0:t},\ z_{1:t-1},\ u_{1:t}) = p(z_t \mid x_t)\]입니다. 우변 둘째 항은 조건부 확률의 연쇄 법칙으로 최신 상태와 과거 궤적으로 쪼갭니다. 근사가 아니라 확률의 정의에서 나오는 항등 분해입니다.
\[p(x_{0:t} \mid z_{1:t-1},\ u_{1:t}) = p(x_t \mid x_{0:t-1},\ z_{1:t-1},\ u_{1:t})p(x_{0:t-1} \mid z_{1:t-1},\ u_{1:t})\]쪼개진 앞 항에는 상태 천이의 마르코프 가정을 적용합니다. 직전 상태와 현재 제어가 주어지면 $x_t$는 더 먼 과거와 조건부 독립이므로
\[p(x_t \mid x_{0:t-1},\ z_{1:t-1},\ u_{1:t}) = p(x_t \mid x_{t-1},\ u_t)\]입니다. 쪼개진 뒷 항에서는 조건의 $u_t$를 지울 수 있습니다. $u_t$는 시각 $t-1$ 이후에 가해지는 제어이므로 과거 궤적 $x_{0:t-1}$의 분포에 인과적으로 영향을 줄 수 없기 때문입니다.
\[p(x_{0:t-1} \mid z_{1:t-1},\ u_{1:t}) = p(x_{0:t-1} \mid z_{1:t-1},\ u_{1:t-1})\]이제 조각들을 다시 조립하면 목표가 다음과 같이 정리됩니다.
\[f = \eta \, p(z_t \mid x_t) \, \underbrace{p(x_t \mid x_{t-1},\ u_t) \, p(x_{0:t-1} \mid z_{1:t-1},\ u_{1:t-1})}_{=\ g}\]밑줄 친 덩어리가 정확히 제안 분포 $g$입니다. 목표를 전개했더니 제안이 통째로 인수로 들어 있었던 것이고, 따라서 비율에서 소거됩니다.
\[w_t^{[m]} = \frac{f}{g} = \frac{\eta \, p(z_t \mid x_t^{[m]}) \, g}{g} = \eta \, p(z_t \mid x_t^{[m]})\]그리고 $\eta$는 1단계 말미에서 확인한 소거 성질에 의해 정규화 과정에서 사라지므로 계산할 필요가 없습니다. 알고리즘의 가중치 갱신 줄 $w_t^{[m]} = p(z_t \mid x_t^{[m]})$이 이렇게 유도됩니다. 이 결과의 의미를 음미할 필요가 있습니다. 관측 우도를 가중치로 쓰는 것은 그럴듯해서 고른 발견법이 아니라, 목표 대 제안의 비율이라는 엄밀한 신분을 가진 값입니다. 그리고 그 비율이 우도 한 항으로 붕괴한 것은 우연이 아닙니다. 제안 분포가 목표에서 정확히 최신 관측 하나만 빠진 분포가 되도록 알고리즘이 설계되어 있기 때문입니다. 이동 모델로 뽑는 순간 제안은 관측 직전까지의 모든 정보를 이미 담고 있고, 목표와의 차이는 $z_t$ 하나뿐이므로, 그 차이의 값어치인 $p(z_t \mid x_t)$가 가중치의 전부가 됩니다. 예측 샘플링과 리샘플링이 이 등식이 성립할 무대를 만드는 조연이라면, 베이즈 보정의 실체는 가중치 갱신 한 줄에 전부 실려 있는 셈입니다.
궤적에서 상태로 내려오는 일이 남았습니다. 방금 증명한 것은 가중 파티클이 궤적의 사후분포를 표현한다는 것인데, 우리가 원하는 것은 현재 상태의 belief입니다. 결합분포에서 뽑은 샘플의 한 성분만 남기면 그 성분은 주변분포를 따른다는 것이 주변화(marginalization)의 표본 버전입니다. 실제로 $x_{0:t} \sim p(x_{0:t} \mid \cdot)$일 때 마지막 성분 $x_t$가 사건 $A$에 들어갈 확률은
\[P(x_t \in A) = \int \mathbf{1}_A(x_t)p(x_{0:t} \mid \cdot) \, dx_{0:t} = \int_A \left[ \int p(x_{0:t} \mid \cdot) \, dx_{0:t-1} \right] dx_t\]이고 대괄호 안이 주변분포의 정의이므로, 조상 부분을 그냥 버린 $x_t^{[m]}$들은
\[\int p(x_{0:t} \mid z_{1:t},\ u_{1:t}) \, dx_{0:t-1} = p(x_t \mid z_{1:t},\ u_{1:t}) = bel(x_t)\]의 가중 표본입니다. 알고리즘이 조상을 저장하지 않고 현재 상태만 들고 다니는 것이 이 주변화의 구현입니다.
3단계, 리샘플링을 정당화하겠습니다. 남은 일은 가중 표본을 가중치 없는 표본으로 바꾸는 것입니다. 리샘플링은 정규화 가중치를 확률로 하는 복원추출이므로, 새로 뽑히는 파티클 $\tilde{x}$가 기존 파티클 $x^{[i]}$일 확률은
\[P\left( \tilde{x} = x^{[i]} \right) = \frac{w^{[i]}}{\sum_{j=1}^{M} w^{[j]}}\]입니다. 새 파티클이 사건 $A$에 떨어질 확률은 $A$ 안의 파티클들에 대한 합입니다.
\[P(\tilde{x} \in A) = \sum_{i:\ x^{[i]} \in A} \frac{w^{[i]}}{\sum_{j} w^{[j]}} = \frac{\frac{1}{M}\sum_{i} w^{[i]} \mathbf{1}_A(x^{[i]})}{\frac{1}{M}\sum_{j} w^{[j]}}\]마지막 등호에서 분자와 분모를 $M$으로 나눴습니다. 이제 두 표본 평균에 대수의 법칙을 적용하면, $M \to \infty$에서 분자는 1단계의 핵심 명제에 의해 $E_g[w\, \mathbf{1}_A] = P_f(A)$로, 분모는 $E_g[w] = 1$로 수렴합니다. 따라서
\[P(\tilde{x} \in A) \longrightarrow \frac{P_f(A)}{1} = P_f(A)\]리샘플링된 비가중 파티클은 목표 분포 $f$, 곧 $bel(x_t)$를 따르는 표본이 됩니다. 그리고 이 결과가 다음 스텝에서 2단계의 귀납 가정을 다시 성립시킵니다. 초기 파티클을 초기 belief에서 뽑아두는 것이 귀납의 기저이고, 매 스텝 세 단계가 반복되며 표현이 유지됩니다. 유도 전체를 관통한 뼈대는 결국 하나였습니다. 뽑기 쉬운 분포에서 뽑고, 목표 대 제안의 비율로 죄를 사면하며, 알고리즘의 설계 덕분에 그 비율이 최신 관측의 우도 한 항으로 붕괴한다는 것입니다.
유한한 M에서의 현실
정직하게 짚을 것은 위의 보장이 전부 점근적이라는 점입니다. 유한한 $M$에서는 편향과 분산이 존재하며, 특히 심장인 가중치가 병드는 방식이 곧 particle filter가 실패하는 방식입니다. 가중치의 분산이 커져 소수의 파티클이 가중치를 독식하면 나머지는 사실상 죽은 표본이 되는데, 이것이 리샘플링 없는 순차 importance sampling이 시간이 갈수록 퇴화(degeneracy)하는 이유이고, 리샘플링은 이 퇴화를 도태와 복제로 끊어내기 위해 존재합니다. 그러나 리샘플링도 공짜가 아닙니다. 같은 파티클이 복제되며 표본의 다양성이 줄고, 관측이 별 정보를 주지 않는 스텝에서까지 반복하면 파티클들이 이유 없이 소수의 조상으로 수렴해 버리는 파티클 고갈(particle deprivation)이 일어납니다. 그래서 실무에서는 가중치 분산이 충분히 커졌을 때만 리샘플링하는 조건부 전략이나, 복원추출의 난수 분산 자체를 줄이는 저분산 샘플링(low variance sampling)을 씁니다. 마지막으로 앞 장과의 연결을 상기하면, 가중치를 계산하는 측정 모델의 우도 지형이 파티클에게 방향 신호를 줄 만큼 부드러워야 이 기계가 실제로 굴러갑니다. 증명이 보장하는 것은 가중치라는 심장의 정당성이고, 유한 표본에서 그 심장을 계속 뛰게 하는 것은 공학의 몫입니다.
Perception
로봇이 세계를 들여다보는 유일한 창은 센서입니다. 그리고 센서는 거짓말을 합니다. 라이다는 유리를 통과하고, 초음파는 벽에 비스듬히 맞으면 엉뚱한 곳으로 튕겨나가며, 지도에 없는 사람이 빔을 가로막습니다. 확률론적 로보틱스가 이 거짓말을 다루는 방식은 센서를 고치는 것이 아니라, 센서가 어떤 방식으로 거짓말하는지를 확률분포로 정직하게 기술하는 것입니다. 이 장에서 만드는 것이 바로 그 분포, 측정 모델(measurement model) $p(z_t \mid x_t, m)$입니다.
베이즈 필터의 보정 단계를 다시 보겠습니다.
\[bel(x_t) = \eta \, p(z_t \mid x_t) \, \overline{bel}(x_t)\]여기서 $p(z_t \mid x_t)$ 자리에 꽂히는 부품이 측정 모델입니다. 앞으로 다룰 beam model, likelihood field, feature 기반 모델은 전부 이 소켓에 꽂히는 서로 다른 부품이며, 파티클 필터(particle filter) 관점에서는 전부 파티클의 가중치를 계산하는 채점 함수입니다. 이 관점 하나를 붙들고 가면 이 장이 훨씬 선명해집니다.
Map and Measurement
맵
측정 모델은 조건부에 맵(map) $m$을 달고 다닙니다. 같은 측정이라도 어떤 세계에서 이뤄졌느냐에 따라 그럴듯함이 달라지기 때문입니다. 맵은 환경에 대한 객체들의 목록으로 정의됩니다.
\[m = \{m_1, m_2, \ldots, m_N\}\]이 장에서 주로 쓰는 형태는 점유 격자 맵(occupancy grid map)입니다. 공간을 일정 크기의 셀로 나누고, 셀마다 이진 상태를 부여합니다.
\[m_i \in \{\text{occupied},\ \text{free}\}\]occupied는 그 셀에 물체가 있어서 센서 빔이 거기서 막힌다는 뜻이고, free는 빔이 통과한다는 뜻입니다. 물체의 정체는 묻지 않습니다. 벽인지 화분인지 구별하지 않고 오직 “빔을 막느냐”라는 기하학적 사실만 저장합니다. 함수의 관점으로 보면 맵은 평면의 점을 넣으면 점유 여부를 답하는 함수입니다.
\[m: \mathbb{R}^2 \to \{\text{occupied},\ \text{free}\}\]실제 맵은 노이즈 때문에 셀마다 점유 확률 $p(m_i) \in [0,1]$을 들고 있지만, 측정 모델에서는 문턱값으로 이진화한 것을 쓴다고 생각하면 됩니다. 이 장에서 맵은 주어진 참값으로 취급합니다. 맵을 만드는 문제는 별도의 주제입니다.
측정과 독립 가정
시간 $t$의 측정 $z_t$는 하나의 값이 아니라 $K$개 빔의 묶음입니다.
\[z_t = \{z_t^1, z_t^2, \ldots, z_t^K\}\]전체 스캔의 확률은 개별 빔 확률의 곱으로 모델링합니다.
\[p(z_t \mid x_t, m) = \prod_{k=1}^{K} p(z_t^k \mid x_t, m)\]이 곱이 성립하려면 빔들이 조건부 독립이어야 하는데, 솔직히 말하면 이 가정은 거짓입니다. 이웃한 빔들은 같은 벽면을 보고, 지도에 없는 사람 한 명이 여러 빔을 동시에 가리며, 센서의 온도 드리프트는 모든 빔에 공통으로 낍니다. 이런 종속성을 만들어내는 잠재 변수(latent variable)들을 전부 모델에 넣으면 계산이 폭발하므로 무시하고 곱을 씁니다. 이 거짓말의 대가는 뒤의 실제 활용 절에서 청구서로 돌아옵니다.
측정 모델을 읽는 방향
$p(z_t \mid x_t, m)$은 문법적으로 $z$에 대한 확률입니다. $x$를 고정하면 $z$ 방향으로 적분해서 1이 되는 정상적인 분포입니다. 그런데 위치추정에서 이 함수를 쓸 때는 반대로 읽습니다. 스캔 $z_t$는 이미 들어와서 고정된 데이터이고, 움직이는 것은 포즈 가설 $x_t$ 쪽입니다. $z$를 고정하고 $x$의 함수로 읽은 것을 우도(likelihood)라 부르며, 이 장의 알고리즘들이 반환하는 값 $q$가 정확히 그것입니다.
\[q(x_t) = p(z_t \mid x_t, m)\]$q$의 의미를 한 문장으로 압축하면 이렇습니다. 포즈 가설 $x_t$가 참이라 가정할 때, 실제로 들어온 스캔 $z_t$가 관측될 확률. 즉 “네 말대로 거기 있었다면, 이 스캔이 나왔겠냐”에 대한 답입니다. 주의할 것은 $q(x)$가 $x$에 대한 확률분포가 아니라는 점입니다. $x$ 방향으로 적분해도 1이 될 이유가 없습니다. $q$는 분포가 아니라 가설별 채점표이며, 사전믿음과 곱해지고 정규화를 거친 뒤에야 $bel(x_t)$라는 진짜 분포가 됩니다. Particle filter에서는 파티클마다 $w^{[i]} = q(x^{[i]})$를 계산해 가중치로 쓰고, 이 가중치에 비례해 리샘플링하는 것이 보정 단계의 구현입니다.
Beam Model
기본 측정 알고리즘
빔 모델(beam model)은 레이저 빔 하나가 겪을 수 있는 운명을 네 가지로 분류하고, 각각을 확률분포로 만들어 섞습니다. 재료가 되는 것은 예측 거리 $z_t^{k\ast}$입니다. 포즈 가설 $x_t$에서 맵 $m$을 향해 가상의 레이저를 쏘아, 처음 만나는 occupied 셀까지의 거리를 계산한 값입니다. 이 절차를 레이캐스팅(ray casting)이라 부릅니다.
\[z_t^{k\ast} = \text{ray casting}(x_t, m, k)\]책은 이것을 프로시저 호출로만 표기하지만, 내부를 열어보면 좌표 변환이 들어 있습니다. 레이의 시작점은 로봇 위치에 센서 장착 오프셋을 회전시켜 더한 것이고, 레이의 방향은 로봇 헤딩에 빔의 상대 각도를 더한 것입니다.
\[\text{시작점} = p_t + R(\theta)\, s_k, \qquad \text{방향} = \theta + \theta_{k,\text{sens}}\]여기서 $p_t = (x\ y)^T$는 포즈의 위치 성분, $R(\theta)$는 회전행렬, $s_k = (x_{k,\text{sens}}\ y_{k,\text{sens}})^T$와 $\theta_{k,\text{sens}}$는 로봇 몸체에 고정된 센서의 장착 위치와 빔 각도입니다. 뒤의 둘은 캘리브레이션으로 정해지는 상수이므로, 시간에 따라 변하는 유일한 변수는 $x_t$뿐입니다. 즉 $z_t^{k\ast}$는 포즈의 함수 $z^{k\ast}(x_t)$이며, 이 사실이 뒤에서 beam model의 발목을 잡습니다.
네 가지 운명은 다음과 같습니다.
첫째, 정상 명중입니다. 빔이 맵에 등록된 장애물을 제대로 맞추면 측정값은 예측값 근처에서 가우시안으로 흔들립니다.
\[p_{\text{hit}}(z_t^k \mid x_t, m) = \eta \, \mathcal{N}(z_t^k;\ z_t^{k\ast},\ \sigma_{\text{hit}}^2)\]$\eta$는 측정값이 $[0, z_{\max}]$ 범위로 잘리는 것을 보정하는 정규화 상수입니다.
둘째, 예상 밖의 물체입니다. 맵에 없는 사람이나 물건이 빔을 중간에서 가로채면 측정값은 예측값보다 짧아집니다. 가까이 있는 물체일수록 가로챌 확률이 높으므로 지수분포로 모델링합니다.
\[p_{\text{short}}(z_t^k \mid x_t, m) = \eta \, \lambda_{\text{short}} \, e^{-\lambda_{\text{short}} z_t^k}, \qquad 0 \le z_t^k \le z_t^{k\ast}\]셋째, 완전한 실패입니다. 빔이 아무것도 감지하지 못하면 센서는 최대 사거리 $z_{\max}$를 반환합니다. 이 사건은 딱 한 점에 몰리므로 점질량으로 표현합니다.
\[p_{\text{max}}(z_t^k \mid x_t, m) = \mathbf{1}[z_t^k = z_{\max}]\]넷째, 설명 불가능한 랜덤 측정입니다. 크로스토크나 다중 반사 같은 원인으로 아무 값이나 튀어나오는 경우이며, 균일분포를 깔아둡니다.
\[p_{\text{rand}}(z_t^k \mid x_t, m) = \frac{1}{z_{\max}}\]최종 모델은 네 분포의 가중 혼합입니다.
\[p(z_t^k \mid x_t, m) = \begin{pmatrix} z_{\text{hit}} \\\\ z_{\text{short}} \\\\ z_{\text{max}} \\\\ z_{\text{rand}} \end{pmatrix}^{T} \cdot \begin{pmatrix} p_{\text{hit}} \\\\ p_{\text{short}} \\\\ p_{\text{max}} \\\\ p_{\text{rand}} \end{pmatrix}, \qquad z_{\text{hit}} + z_{\text{short}} + z_{\text{max}} + z_{\text{rand}} = 1\]표기에 대해 한 가지 경고를 남깁니다. 이 책에서 $z$라는 글자는 세 가지 전혀 다른 역할로 재활용됩니다. $z_t^k$는 측정값(확률변수), $z_{\max}$는 사거리 상수(미터), $z_{\text{hit}}$ 같은 것들은 혼합 가중치(무차원 확률)입니다. 특히 $z_{\max}$는 조건문에서는 거리로, 혼합식에서는 가중치로 겸직합니다. 아래첨자가 시간이나 빔 번호면 측정값이고 단어면 파라미터라고 구분해서 읽어야 하며, 혼합 가중치들은 맵에서 나온 정보가 아니라 센서의 고장 통계라는 점을 놓치면 안 됩니다.
내재된 모델 파라미터 조정
혼합 가중치 넷과 분포의 모양을 정하는 $\sigma_{\text{hit}}$, $\lambda_{\text{short}}$를 합쳐 내재 파라미터(intrinsic parameter) $\Theta$라 부릅니다. 손으로 튜닝할 수도 있지만, 원리적인 방법은 데이터로부터의 최대 우도 추정입니다. 포즈를 아는 상태에서 수집한 측정 데이터 $Z = {z_i}$에 대해
\[\Theta^\ast = \arg\max_{\Theta}\ p(Z \mid X, m, \Theta) = \arg\max_{\Theta} \sum_i \log p(z_i \mid x_i, m, \Theta)\]를 푸는 것입니다. 포즈 $x_i$를 알고 있으므로 각 측정의 예측값 $z_i^\ast = \text{ray casting}(x_i, m)$은 미리 계산되는 숫자가 되고, 미지수는 $\Theta$만 남습니다. 문제는 이 로그 우도가 혼합분포의 로그라서 직접 미분으로 풀리지 않는다는 것입니다. 어떤 측정이 네 성분 중 어디서 나왔는지를 모르기 때문입니다. 이 숨은 정보를 다루는 표준 도구가 EM(Expectation-Maximization)입니다.
빔모델 수학적 유도 (EM Algorithm)
측정 $z_i$마다 숨은 원인을 나타내는 잠재 변수 $c_i \in {\text{hit}, \text{short}, \text{max}, \text{rand}}$를 도입하겠습니다. 만약 모든 $c_i$를 안다면 문제는 허무할 만큼 쉬워집니다. hit으로 분류된 측정들만 모아 잔차의 표준편차를 재면 $\sigma_{\text{hit}}$이고, 각 원인의 등장 비율이 곧 혼합 가중치입니다. EM은 이 “안다면 쉬운” 구조를 반복으로 흉내냅니다. 현재 파라미터로 $c_i$를 확률적으로 추정하고(E-step), 그 추정을 정답인 셈 치고 파라미터를 갱신하는(M-step) 왕복입니다.
E-step은 측정 하나하나에 대한 재판입니다. 현재 파라미터 하에서 측정 $z_i$가 각 성분에서 나왔을 사후확률, 즉 책임값(responsibility)을 계산합니다.
\[e_{i,\text{hit}} = \frac{z_{\text{hit}} \, p_{\text{hit}}(z_i)}{z_{\text{hit}} \, p_{\text{hit}}(z_i) + z_{\text{short}} \, p_{\text{short}}(z_i) + z_{\text{max}} \, p_{\text{max}}(z_i) + z_{\text{rand}} \, p_{\text{rand}}(z_i)}\]분모는 네 성분의 합이고 분자만 성분별로 바꾸면 $e_{i,\text{short}}$, $e_{i,\text{max}}$, $e_{i,\text{rand}}$가 됩니다. 실측이 예측과 가까우면 hit의 책임이 커지고, 예측보다 한참 짧으면 short의 책임이 커지는 식으로, 맵의 예측 $z_i^\ast$가 재판의 증거로 쓰입니다.
M-step은 판결문의 집계입니다. 혼합 가중치는 책임값의 평균입니다.
\[z_{\text{hit}} = \frac{1}{|Z|} \sum_{i} e_{i,\text{hit}}\]나머지 세 가중치도 같은 꼴입니다. 분포 파라미터는 완전 데이터였다면 썼을 최대 우도 추정치를 책임값으로 가중한 형태가 됩니다. 가우시안의 표준편차는
\[\sigma_{\text{hit}} = \sqrt{\frac{1}{\sum_i e_{i,\text{hit}}}\ \sum_{i} e_{i,\text{hit}}\, (z_i - z_i^\ast)^2}\]이고, 지수분포의 파라미터는 지수분포 MLE가 표본평균의 역수라는 사실의 가중 버전입니다.
\[\lambda_{\text{short}} = \frac{\sum_i e_{i,\text{short}}}{\sum_i e_{i,\text{short}} z_i}\]두 스텝을 수렴할 때까지 반복하면 각 반복에서 로그 우도가 단조 증가함이 보장됩니다. 의미를 되새기면, 이 학습이 조정하는 것은 가우시안의 퍼짐 정도와 지수함수의 기울기이지, 예측 함수 $z^\ast(x)$의 모양이 아닙니다. $z^\ast(x)$는 레이캐스팅이라는 기하학이 정하는 것이므로 $\Theta$를 아무리 잘 맞춰도 바뀌지 않습니다. 이 구분이 바로 다음 절의 복선입니다.
실제 활용시 고려사항
Beam model은 센서의 물리에 충실한 정직한 모델이지만, particle filter에 꽂아 돌리는 순간 세 가지 문제가 터집니다.
첫째, 계산량입니다. $z^{k\ast}$를 구하는 레이캐스팅을 파티클 수 곱하기 빔 수만큼 매 스텝 반복해야 합니다. 파티클 천 개에 빔 백팔십 개면 스텝당 십팔만 번입니다. 레이캐스팅 결과를 이산화된 포즈에 대해 미리 계산해 테이블로 캐싱하는 방법이 있지만 메모리 비용이 큽니다.
둘째, 우도 지형의 비평활성입니다. $z^\ast(x)$는 포즈에 대해 불연속입니다. 문틈 모서리를 스치는 빔을 생각해보겠습니다. 후보 포즈가 몇 센티미터만 옆으로 가도 그 빔의 예측은 “문틈 통과, $z_{\max}$”와 “벽에 막힘, 2m” 사이를 점프하고, 우도는 절벽처럼 무너집니다. 더 나쁜 것은 정답에서 멀리 떨어진 파티클의 처집니다. 틀린 포즈에서 레이캐스팅한 예측은 엉뚱한 벽까지의 거리이므로, 잔차가 오차의 크기와 통계적으로 무관한 난수가 됩니다. 오차 2m인 파티클과 5m인 파티클이 받는 점수에 체계적 차이가 없다는 뜻이고, 리샘플링은 동전던지기가 됩니다. 전역 위치추정처럼 파티클이 정답 근처에 있다는 보장이 없는 상황에서 beam model이 고전하는 이유가 정확히 이것입니다.
셋째, 독립 가정발 과신입니다. 이웃 빔들이 같은 벽을 보는데 독립인 척 수백 개를 곱하면, 우도의 봉우리가 실제 정보량이 정당화하는 것보다 훨씬 뾰족해집니다. 사후분포가 과도하게 좁아지면 particle filter는 오답에 조기 수렴한 뒤 회복하지 못합니다.
Likelihood Field
발상의 전환
Beam model의 병리는 전부 $z^\ast(x)$라는 함수, 즉 레이캐스팅에서 나왔습니다. 유사가능도 필드(likelihood field)의 발상은 그 함수를 통째로 버리는 것입니다. 예측 거리를 만들어 실측과 비교하는 대신, 실측을 그대로 믿고 지도에 찍어본 뒤 그 점이 장애물 근처에 있는지만 묻습니다.
빔의 끝점을 전역좌표로 투영하는 식이 출발점입니다.
\[\begin{pmatrix} x_{z_t^k} \ y_{z_t^k} \end{pmatrix} = \begin{pmatrix} x \ y \end{pmatrix} - \begin{pmatrix} \cos\theta & -\sin\theta \ \sin\theta & \cos\theta \end{pmatrix} \begin{pmatrix} x_{k,\text{sens}} \ y_{k,\text{sens}} \end{pmatrix} - z_t^k \begin{pmatrix} \cos(\theta + \theta_{k,\text{sens}}) \ \sin(\theta + \theta_{k,\text{sens}}) \end{pmatrix}\]세 항의 역할은 로봇 위치, 센서 장착 오프셋의 회전, 그리고 빔 방향으로 실측 거리만큼의 전진입니다. Beam model의 레이캐스팅과 같은 부품(시작점과 방향)을 쓰되, 가상 사격 대신 실제 착탄 보고서 $z_t^k$를 대입해 착탄점 좌표만 찍는 셈입니다. 이 끝점을 $e_k(x_t)$라 쓰겠습니다.
주의할 것은 $e_k$가 장애물의 위치가 아니라는 점입니다. $e_k$는 “후보 포즈 $x_t$가 참이라면 끝점이 놓일 위치”라는 주장입니다. 가설이 정확하면 이 주장은 실제 장애물 표면 위에 떨어지고, 가설이 틀리면 허공에 뜹니다. 그리고 계산 과정에 맵이 전혀 안 들어갔다는 점이 결정적입니다. 센서와 가설만으로 만든 주장을, 맵만이 아는 사실과 대질하는 것이 다음 단계입니다.
\[dist = \min_{x', y'} \left\lbrace \sqrt{(x_{z_t^k} - x')^2 + (y_{z_t^k} - y')^2}\ \middle|\ m \text{ 내에 occupied인 } \langle x', y' \rangle \right\rbrace\]끝점에서 맵상 가장 가까운 occupied 셀까지의 유클리드 거리입니다. 빔 방향으로의 1차원 비교가 아니라 평면 전방위 최근접 탐색이라는 점이 beam model과의 구조적 차입니다. 이 거리를 평균 0인 가우시안에 통과시키고, 랜덤 측정의 바닥값을 더한 것이 빔 하나의 점수입니다.
\[q = \prod_{k:\ z_t^k \ne z_{\max}} \left[ z_{\text{hit}} \cdot \text{prob}(dist,\ \sigma_{\text{hit}}) + \frac{z_{\text{rand}}}{z_{\max}} \right]\]$z_{\max}$인 빔은 곱에서 제외합니다. 최대거리 측정은 그 방향에 아무것도 안 잡혔다는 뜻이라 끝점이 실제 표면이 아니고, 그 가짜 끝점과 벽의 거리는 정보가 아니기 때문입니다.
구현에서는 거리 함수 $d(\cdot)$를 맵이 주어질 때 모든 셀에 대해 한 번만 미리 계산해둡니다. 이 전처리를 거리 변환(distance transform)이라 하며, 이후 빔마다 min을 도는 대신 배열 조회 한 번으로 끝납니다. 맵 위에 우도값의 장이 미리 깔려 있다는 뜻에서 likelihood field라는 이름이 나왔습니다.
Why Smooth?
Beam model 대비 likelihood field의 우위는 우도 지형의 평활성으로 요약됩니다. 빔 하나의 점수는 세 함수의 합성입니다. 좌표 변환 $x_t \mapsto e_k$는 삼각함수 조합이라 매끄럽고, 거리 함수 $d$는 삼각부등식에 의해 1-Lipschitz라 어디서나 연속이며, 가우시안과 바닥값은 매끄럽고 하한이 있습니다. 얌전한 함수들의 합성이므로 $q(x)$도 얌전합니다. 레이캐스팅의 infimum이 문틈에서 점프하던 것과 달리, 평면 전방위 min은 포즈가 움직여도 연속적으로 따라옵니다.
이 평활성의 실전적 의미는 방향 신호입니다. 포즈 오차가 $\Delta$일 때 끝점도 $\Delta$만큼 밀리고, 거리 $d$가 근사적으로 $\Delta$에 비례하므로 점수는 오차의 단조 감소함수가 됩니다. 정답에서 2m 떨어진 파티클이 5m 떨어진 파티클보다 일관되게 높은 점수를 받고, 리샘플링을 반복하면 파티클 구름이 언덕을 타고 정답으로 흘러 들어갑니다. Beam model이 금고 다이얼이라면(정답 근처에서만 걸쇠 느낌이 오고 멀면 무신호), likelihood field는 뜨겁다 차갑다 놀이다(어디서든 방향을 알려준다). 전역 위치추정은 정의상 출발점이 아무 데나인 게임이므로, 이 차이가 승부를 가릅니다. 실무에서 $\sigma_{\text{hit}}$을 센서의 실제 노이즈보다 훨씬 크게 잡는 것도 같은 맥락인데, 정밀도를 팔아 방향 신호가 유효한 반경을 사는 트레이드입니다.
대가
공짜는 아닙니다. 첫째, $z_{\text{short}}$ 성분이 사라졌습니다. 끝점만 보고 빔의 경로는 안 보기 때문에 예측보다 짧게 돌아왔다는 개념 자체가 성립하지 않고, 동적 장애물로 인한 오측정은 전부 뭉툭한 $z_{\text{rand}}$가 흡수합니다. 둘째, 같은 이유로 벽을 뚫고 봅니다. 빔 경로에 뭐가 있는지 검사하지 않으므로, 오답 포즈에서 찍힌 끝점이 우연히 벽 반대편의 다른 벽에 얹히면 그 오답에 고득점을 줍니다. 셋째, 이것은 더 이상 생성 모델이 아닙니다. $z$ 방향으로 적분해도 1이 되지 않으며, 물리적 유도 없이 계산 효율과 평활성을 위해 설계된 근사입니다. Particle filter의 가중치는 리샘플링에서 어차피 정규화되므로 실용상 문제가 없지만, beam model이 갖던 확률적 정당성은 포기한 것입니다.
정리하면 beam model과 likelihood field는 정확도의 싸움이 아니라 지형의 싸움입니다. 둘 다 정답 포즈에서 봉우리를 만들지만, 전자의 봉우리는 절벽으로 조각난 계단 위의 바늘이고 후자는 완만한 언덕 위의 봉우리입니다. 알고리즘이 유한한 파티클로 탐색할 수 있는 쪽은 후자입니다.
Feature Based Measurement Model
Feature Extract from Landmark
지금까지의 모델은 원시 스캔을 통째로 썼습니다. 반대편 전통은 스캔에서 굵직한 특징만 추출해 쓰는 피처 기반(feature based) 접근입니다. 실내의 문설주나 모서리, 실외의 나무 줄기처럼 로봇 내비게이션의 기준점이 되는 물리적 객체를 랜드마크(landmark)라 부르고, 피처 추출기 $f$는 원시 측정을 랜드마크 관측들의 목록으로 압축합니다.
\[f(z_t) = {f_t^1, f_t^2, \ldots} = \left\lbrace \begin{pmatrix} r_t^1 \ \phi_t^1 \ s_t^1 \end{pmatrix}, \begin{pmatrix} r_t^2 \ \phi_t^2 \ s_t^2 \end{pmatrix}, \ldots \right\rbrace\]랜드마크 관측 하나는 세 성분으로 이뤄집니다. $r$은 범위(range), 로봇에서 랜드마크까지의 거리입니다. $\phi$는 방위(bearing), 로봇 진행 방향 기준 랜드마크가 보이는 각도입니다. 2차원 평면에서 점 하나를 특정하려면 좌표가 정확히 두 개 필요한데, $(r, \phi)$는 로봇 중심의 극좌표입니다. $r$만 있으면 원 위 어딘가, $\phi$만 있으면 반직선 위 어딘가이고, 둘이 합쳐져야 점이 찍힙니다. 센서의 물리가 원래 “이 방향으로 쐈더니 이 거리에서 반사됐다”이므로 극좌표가 날것의 출력이기도 합니다.
$s$는 시그니처(signature)로, 거리도 각도도 아닌 랜드마크의 정체를 나타내는 특징값입니다. 평균 색상 같은 수치일 수도, 유형을 나타내는 정수일 수도, 다차원 벡터일 수도 있습니다. 왜 정체가 필요합니까? $(r, \phi)$는 “3m 앞 30도 방향에 뭔가 있다”까지만 말해주는데, 맵에 랜드마크가 스무 개 등록돼 있다면 그 뭔가가 스무 개 중 몇 번인지를 알아야 채점이 가능하기 때문입니다. 관측과 맵상 개체를 짝짓는 이 문제를 데이터 연관 문제(data association problem)라 하며, 시그니처는 그 짝짓기의 힌트입니다.
Known Correspondence Model
짝짓기를 명시적으로 다루기 위해 대응 변수(correspondence variable) $c_t^i \in {1, \ldots, N+1}$를 도입합니다. $N$은 맵의 랜드마크 개수이며, $c_t^i = j \le N$이면 $i$번째 관측 피처가 맵의 $j$번째 랜드마크에 대응된다는 뜻입니다. 유일한 예외인 $c_t^i = N+1$은 이 관측이 맵의 어떤 랜드마크에도 대응하지 않는다는 뜻으로, 가짜 감지나 아직 지도에 없는 새 랜드마크를 처리하는 탈출구입니다.
Correspondence가 정답으로 주어졌다고 가정하면 측정 모델은 단순해집니다. 맵에서 $j$번째 랜드마크의 좌표 $(m_{j,x}, m_{j,y})$를 꺼내, 포즈 가설에서의 예측 범위와 방위를 계산합니다.
\[\hat{r} = \sqrt{(m_{j,x} - x)^2 + (m_{j,y} - y)^2}, \qquad \hat{\phi} = \text{atan2}(m_{j,y} - y,\ m_{j,x} - x) - \theta\]Beam model의 레이캐스팅이 하던 역할과 같은 예측이지만, 랜드마크 좌표를 알고 있으므로 닫힌 식 한 줄로 끝납니다. 채점은 세 잔차 각각의 독립 가우시안 곱입니다.
\[q = \text{prob}(r_t^i - \hat{r},\ \sigma_r) \cdot \text{prob}(\phi_t^i - \hat{\phi},\ \sigma_\phi) \cdot \text{prob}(s_t^i - s_j,\ \sigma_s)\]구조를 보면 알겠지만, correspondence $j$가 예측의 기준점을 통째로 결정합니다. 짝을 잘못 지으면 엉뚱한 랜드마크 기준의 잔차가 계산되어 정답 포즈가 억울하게 감점당하고, 그 틀린 방향으로 확신에 찬 갱신이 일어납니다. Beam model의 절벽이 점수를 잠깐 이상하게 만드는 수준이라면 오대응(misassociation)은 필터를 발산시킵니다. 그래서 known correspondence 모델은 완결된 해법이 아니라, correspondence를 추정해야 하는 진짜 문제의 부품입니다. 실무의 방어선은 층위로 이뤄집니다. 시그니처로 후보를 걸러 예방하고, 예측 위치 기준의 게이팅으로 거르고, 후보가 여럿이라 애매하면 그 관측을 통째로 버립니다. 랜드마크 하나를 버리는 손해가 오대응 한 번의 손해보다 훨씬 싸기 때문입니다. 더 원리적으로는 correspondence를 하나로 확정하지 않고 모든 가능성에 대해 합산하는 방법도 있습니다.
\[p(f_t^i \mid x_t, m) = \sum_{j=1}^{N+1} p(f_t^i \mid c_t^i = j,\ x_t, m)\ p(c_t^i = j)\]Particle filter에는 숨은 이점이 하나 있는데, 파티클마다 자기 포즈 기준으로 correspondence를 따로 추정하면 오대응한 파티클만 낮은 점수를 받고 도태됩니다. 대응 오류가 필터 전체를 죽이는 대신 파티클 하나만 죽이는 구조가 되는 것입니다.
Sampling Pose
측정 모델은 채점에만 쓰이는 것이 아닙니다. 방향을 뒤집으면 생성기로도 쓸 수 있습니다. 랜드마크 관측 하나가 주어졌을 때 그 관측과 부합하는 포즈를 역으로 샘플링하는 것입니다.
\[p(x_t \mid f_t^i, m) \propto p(f_t^i \mid c_t^i, x_t, m)\ p(x_t)\]사전분포를 균일하게 두면, 기하학이 답을 알려줍니다. 랜드마크까지의 거리가 $r$인 포즈들은 랜드마크를 중심으로 반지름 $r$인 원 위에 놓입니다. 관측 하나로는 원 위의 어디인지가 결정되지 않으므로, 그 미결정 자유도를 난수로 뽑습니다. 랜드마크에서 로봇을 바라보는 각도를 $\hat{\gamma}$라 하면 샘플링 절차는 다음과 같습니다.
\[\hat{\gamma} = \text{rand}(0, 2\pi), \qquad \hat{r} = r_t^i + \text{sample}(\sigma_r^2), \qquad \hat{\phi} = \phi_t^i + \text{sample}(\sigma_\phi^2)\] \[x = m_{j,x} + \hat{r}\cos\hat{\gamma}, \qquad y = m_{j,y} + \hat{r}\sin\hat{\gamma}, \qquad \theta = \hat{\gamma} - \pi - \hat{\phi}\]원 위의 위치를 균일하게 뽑고, 측정 노이즈만큼 반지름과 방위를 흔든 뒤, 관측된 방위와 일관되도록 헤딩을 역산하는 것입니다. 결과물은 랜드마크를 둘러싼 도넛 모양의 포즈 분포입니다. 이것이 유용한 순간은 particle filter의 초기화와 납치 로봇 복구입니다. 파티클을 지도 전체에 무작위로 뿌리는 대신, 방금 관측된 랜드마크와 부합하는 도넛 위에 뿌리면 처음부터 가망 있는 가설들로 시작할 수 있습니다. 관측 모델을 정방향으로는 채점기로, 역방향으로는 가설 생성기로 쓰는 이 이중 용법은 뒤에서 다룰 MCL의 개선 기법들에서 다시 등장합니다.
실제 활용시 고려사항
이 장의 모델들을 실제 시스템에 넣을 때 반복적으로 마주치는 논점들을 정리합니다.
비평활 우도와 particle filter의 궁합
물리적으로 현실적인 범위 센서 모델일수록 우도가 포즈에 대해 부드럽지 않을 가능성이 높고, 이는 particle filter에서 실질적인 문제를 일으킵니다. Beam model에서 보았듯 레이캐스팅 기반 예측은 환경의 기하(문틈, 모서리, 얇은 기둥)를 그대로 물려받아 절벽과 바늘로 가득한 지형을 만듭니다. 파티클은 유한하므로 바늘 꼭대기에 우연히 앉은 파티클이 없으면 전원이 바닥의 무의미한 점수를 받고, 리샘플링은 방향 정보 없이 공회전합니다. 모델의 물리적 정확성과 알고리즘의 탐색 가능성은 별개의 미덕이며 종종 충돌한다는 것, 그리고 필요하면 후자를 위해 전자를 의도적으로 희생해야 한다는 것이 이 장의 가장 중요한 교훈입니다. Likelihood field가 바로 그 희생의 산물입니다.
불확실성의 인위적 팽창
내재 파라미터를 조정할 때, 학습으로 얻은 값보다 불확실성을 인위적으로 부풀리는 것이 종종 유용합니다. 방식은 두 가지입니다. 하나는 $\sigma_{\text{hit}}$을 실제 센서 노이즈보다 크게 잡아 우도의 봉우리 자체를 뭉개는 것이고, 다른 하나는 우도 전체에 1보다 작은 지수를 얹는 것입니다.
\[\tilde{p}(z_t \mid x_t, m) = p(z_t \mid x_t, m)^{\alpha}, \qquad 0 < \alpha < 1\]이것이 필요한 근본 원인은 빔 독립 가정의 거짓말입니다. 이웃 빔들이 같은 벽을 관측하므로 실제 유효 정보량은 빔 수 $K$가 아니라 훨씬 작은 $K_{\text{eff}}$인데, 독립 곱은 $K$개만큼의 정보가 있는 척 사후분포를 좁힙니다. 지수 $\alpha$는 이 과신을 사후적으로 되돌리는 완화 장치입니다. 같은 목적의 더 거친 방법으로 빔 서브샘플링이 있습니다. 백팔십 개 빔 중 스무 개 남짓만 쓰는 것인데, 남는 빔들 사이의 각도가 벌어져 독립 가정이 덜 거짓이 되는 동시에 계산량까지 줄어, 실무에서 오히려 이쪽이 표준에 가깝습니다.
계산 구조의 선택
세 모델의 계산 비용은 구조적으로 다릅니다. Beam model은 온라인 비용(파티클마다, 빔마다, 매 스텝 레이캐스팅)이 지배하고, likelihood field는 오프라인 비용(맵당 한 번의 distance transform) 이후 온라인은 조회뿐이며, feature 기반 모델은 피처 추출이라는 전처리에 비용을 몰아넣는 대신 관측 개수 자체를 줄입니다. 맵이 고정된 위치추정에서는 전처리를 캐싱할 수 있는 likelihood field가 유리하고, 맵이 계속 갱신되는 상황에서는 그 캐시가 무효화되므로 셈법이 달라집니다.
원시 스캔과 피처의 저울
피처 추출은 본래 계산력이 부족하던 시절의 강제된 압축이었습니다. 스캔 수백 개의 빔을 랜드마크 몇 개로 줄이면 계산은 싸지지만, 랜드마크가 아닌 정보, 즉 벽면 전체의 형상과 빈 공간의 증거는 전부 버려집니다. 컴퓨팅 성능의 향상으로 이 압축의 필요성은 낮아지는 추세이며, 원시 스캔을 통째로 쓰는 모델이 정보를 덜 버리는 만큼 대체로 더 정확합니다. 다만 이것을 “근사가 불필요해졌다”로 읽으면 안 됩니다. 데이터를 얼마나 압축할 것인가와 모델을 얼마나 단순화할 것인가는 독립된 두 개의 저울입니다. 전자는 계산력이 풀어주고 있는 문제지만, 후자, 즉 실세계의 종속성과 그것을 만드는 무수한 latent variable을 무시하는 근사는 계산기가 아무리 빨라져도 여전히 강제됩니다. 원시 스캔을 쓰면서 빔 독립을 가정하는 likelihood field가 두 저울이 독립임을 보여주는 증거입니다.
모델 선택의 기준
결국 어느 모델을 쓸 것인가는 상황이 정합니다. 파티클이 정답에서 멀리 있을 수 있는 전역 위치추정과 납치 로봇 상황에서는 매끄러운 지형이 주는 방향 신호가 결정적이므로 likelihood field가 유리합니다. 지도에 없는 사람이 많은 동적 환경에서는 미등록 장애물을 명시적으로 모델링하는 $z_{\text{short}}$ 성분 덕에 beam model이 정직합니다. 이미 수렴한 뒤의 정밀 추적에서는 두 모델의 차이가 봉우리 폭 몇 센티미터 수준으로 줄어듭니다. 그리고 시그니처가 확실한 인공 랜드마크를 깔 수 있는 통제된 환경이라면 feature 기반 모델이 가장 가볍습니다. 완벽한 측정 모델은 없고, 각 모델은 물리적 충실도, 우도 지형의 평활성, 계산 비용이라는 세 꼭짓점 사이의 서로 다른 타협점일 뿐입니다. 다음 장의 위치추정 알고리즘들은 이 부품들을 실제로 소켓에 꽂아 돌리는 이야기입니다.
Planning and Control: MDP & POMDP
앞에서 다룬 Bayes filter와 measurement model의 목적은 한 가지였습니다. 센서가 불완전한 상황에서 현재 상태가 무엇인지 추정하는 것입니다. 그러나 로봇은 자신의 위치를 아는 것만으로는 아무 일도 하지 못합니다. 상태를 추정한 다음에는 그 상태에서 어떤 제어를 선택해야 하는지가 남습니다. 여기서부터 문제의 중심은 Perception에서 Planning and Control로 이동합니다.
Perception이 $p(x_t \mid z_{1}, u_{1})$를 계산하는 문제라면, Planning은 현재 가지고 있는 정보를 바탕으로 앞으로 받을 reward의 합을 최대화하는 제어 $u$를 선택하는 문제입니다. 이 문제를 상태를 완전히 관측할 수 있다는 가정 아래 정리한 것이 Markov Decision Process(MDP)이고, 실제 상태를 직접 알 수 없는 경우까지 확장한 것이 Partially Observable Markov Decision Process(POMDP)입니다.
MDP
MDP의 핵심은 Bellman optimality equation 한 줄에 거의 전부 들어 있습니다.
\[\max_{u} \left[ r(x,u) + \gamma \sum_{x'} p(x' \mid x,u)V^\ast(x') \right]\]위 식에서 $x$는 현재 state, $u$는 현재 선택할 control, $r(x,u)$는 즉시 얻는 reward, $p(x’ \mid x,u)$는 state transition model입니다. $V^\ast(x)$는 상태 $x$에서 출발했을 때 앞으로 얻을 수 있는 reward의 최대 기대값을 뜻합니다. 연속 상태 공간이라면 합은 적분으로 바뀝니다.
\[\max_{u} \left[ r(x,u) + \gamma \int p(x' \mid x,u)V^\ast(x')\,dx' \right]\]식의 구조는 단순합니다. 지금 얻는 reward와, 지금의 행동으로 이동하게 될 모든 다음 상태의 미래 가치를 더합니다. 다만 다음 상태 $x’$는 확정되어 있지 않으므로 $p(x’ \mid x,u)$로 가중평균합니다. 그리고 그 모든 가능한 제어 $u$ 중 가장 큰 값을 만드는 제어를 선택합니다. 즉 MDP가 푸는 문제는 매 순간 가장 큰 즉시 reward를 고르는 문제가 아니라, 현재 행동이 만들어낼 미래까지 포함한 누적 reward를 최대화하는 문제입니다.
Bellman 식이 재귀적으로 닫힐 수 있는 이유는 Markov property 때문입니다. MDP에서는 현재 상태 $x_t$가 미래를 예측하는 데 필요한 과거의 정보를 모두 담고 있다고 가정합니다.
\[p(x_{t+1} \mid x_t,u_t)\]과거의 상태 $x_0,\ldots,x_{t-1}$을 전부 기억하더라도 현재 상태 $x_t$와 현재 제어 $u_t$를 이미 알고 있다면 다음 상태를 예측하는 데 추가 정보가 되지 않습니다. 따라서 긴 trajectory 전체를 상태로 들고 다닐 필요 없이 $x_t$ 하나만으로 다음 스텝을 계산할 수 있고, 이것이 Bellman recursion을 가능하게 합니다.
여기서 주의할 것은 MDP가 deterministic system을 의미하지는 않는다는 점입니다. 현재 상태 $x_t$를 정확히 알고 있다는 것과 다음 상태 $x_{t+1}$가 확정되어 있다는 것은 전혀 다른 이야기입니다. 현재 상태는 완전히 관측하더라도 actuator noise나 환경의 불확실성 때문에 $p(x_{t+1} \mid x_t,u_t)$는 여전히 확률분포일 수 있습니다.
Return과 Value Function
Bellman equation이 어디서 나오는지 보기 위해 먼저 미래 reward의 합을 정의하겠습니다. 무한 시간 문제에서 discounted return은 다음과 같습니다.
\[r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \cdots\] \[\sum_{k=0}^{\infty}\gamma^k r_{t+k}\]$\gamma \in [0,1)$는 discount factor입니다. 미래의 reward일수록 $\gamma^k$만큼 작게 반영하며, 무한히 긴 시간에 대해서도 reward의 합이 발산하지 않도록 만듭니다. $\gamma$가 0에 가까우면 당장의 reward를 중요하게 보고, 1에 가까우면 먼 미래까지 중요하게 봅니다.
정책(policy) $\pi$는 상태가 주어졌을 때 어떤 행동을 선택할지를 정하는 규칙입니다. stochastic policy라면 $\pi(u \mid x)$, deterministic policy라면 $u=\pi(x)$로 쓸 수 있습니다. 특정 정책 $\pi$를 계속 따랐을 때 상태 $x$의 가치를 state value function으로 정의합니다.
\[\mathbb{E}_\pi\left[G_t \mid x_t\right]\]이제 return을 현재 reward와 나머지 미래 reward로 한 번만 분리합니다.
$G_t = r_t + \gamma G_{t+1}$이므로,
\[\mathbb{E}_\pi\left[r_t + \gamma G_{t+1} \mid x_t\right]\]기대값의 선형성을 적용하고, 다음 상태 $x_{t+1}$부터의 기대 return이 정의상 $V^\pi(x_{t+1})$라는 사실을 쓰면
\[\sum_u \pi(u \mid x) \left[ r(x,u) + \gamma \sum_{x'}p(x' \mid x,u)V^\pi(x') \right]\]을 얻습니다. 이것이 Bellman expectation equation입니다. 현재 상태의 가치가 다음 상태들의 가치로 다시 표현되므로 재귀식이 만들어집니다.
이 식에서 행동 $u$까지 고정한 값을 따로 떼어내면 action value function, 즉 $Q$ function이 됩니다.
\[r(x,u) + \gamma \sum_{x'}p(x' \mid x,u)V^\pi(x')\]$V^\pi(x)$와 $Q^\pi(x,u)$의 차이는 첫 행동이 정해져 있느냐에 있습니다. $V^\pi(x)$는 상태 $x$에서 정책 $\pi$를 따를 때의 가치이고, $Q^\pi(x,u)$는 상태 $x$에서 첫 행동만 $u$로 고정한 뒤 그 이후 정책 $\pi$를 따를 때의 가치입니다. 따라서 둘의 관계는 $V^\pi(x)=\sum_u \pi(u \mid x)Q^\pi(x,u)$가 됩니다.
Optimal Bellman Equation
지금까지는 정책 $\pi$가 이미 주어져 있었습니다. Planning에서 원하는 것은 정책 자체를 찾는 것이므로 가능한 모든 정책 중 가장 큰 value를 정의합니다.
$V^\ast(x)=\max_\pi V^\pi(x)$, $Q^\ast(x,u)=\max_\pi Q^\pi(x,u)$라 두면 두 함수는 다음 관계로 압축됩니다.
\[r(x,u) + \gamma \sum_{x'}p(x' \mid x,u)V^\ast(x'), \qquad V^\ast(x)=\max_u Q^\ast(x,u)\]첫 번째 식은 행동 $u$를 하나 고정했을 때의 장기 가치를 계산하고, 두 번째 식은 그 값이 가장 큰 행동을 고릅니다. 둘을 합치면 처음에 제시한 Bellman optimality equation이 그대로 나옵니다.
최적 정책 역시 여기서 바로 얻어집니다.
\[\arg\max_u Q^\ast(x,u)\] \[\arg\max_u \left[ r(x,u) + \gamma \sum_{x'}p(x' \mid x,u)V^\ast(x') \right]\]여기서 $\max$와 $\arg\max$를 구분해야 합니다. $\max_u Q^\ast(x,u)$는 가장 큰 value 값을 반환하고, $\arg\max_u Q^\ast(x,u)$는 그 value를 만들어내는 control $u$ 자체를 반환합니다. 따라서 정책 $\pi^\ast$의 출력은 reward나 value가 아니라 실제로 실행할 행동입니다.
이 구조를 가장 짧게 적으면 다음 세 줄입니다.
\[r(x,u)+\gamma\,\mathbb{E}_{x' \sim p(\cdot \mid x,u)}\left[V^\ast(x')\right], \qquad V^\ast(x)=\max_u Q^\ast(x,u), \qquad \pi^\ast(x)=\arg\max_u Q^\ast(x,u)\]MDP에서 기대값 내부의 확률변수가 $x’$인 이유도 여기서 보입니다. $\max_u$를 계산하는 순간 현재 행동 $u$는 하나의 후보로 고정되어 있고, 불확실하게 남아 있는 것은 그 행동 이후 어떤 다음 상태 $x’$로 이동할지입니다. 따라서 기대값은 transition model $p(x’ \mid x,u)$에 대해 취합니다.
Finite Horizon과 Backward Recursion
시간이 $T$에서 끝나는 finite horizon 문제에서는 value가 시간에 따라 달라지므로 $V_t(x)$로 씁니다. terminal value를 $V_T(x)$라 하면,
\[\max_u \left[ r_t(x,u) + \gamma \sum_{x'}p(x' \mid x,u)V_{t+1}^\ast(x') \right]\]이 됩니다. 마지막 시점 $T$의 값을 알고 있다면 $T-1$, 그다음 $T-2$ 순서로 거꾸로 계산할 수 있습니다. 이것이 dynamic programming의 backward recursion입니다. 반대로 infinite horizon에서는 시간 첨자를 제거한 $V^\ast(x)$가 Bellman equation의 fixed point가 되며, value iteration 같은 알고리즘은 이 fixed point를 반복적으로 찾아갑니다.
여기까지는 중요한 가정 하나가 숨어 있었습니다. 정책이 $\pi(x)$로 정의되었다는 것은 로봇이 현재의 진짜 상태 $x$를 알고 있다는 뜻입니다. 그러나 앞의 Bayes filter에서 계속 보았듯 현실의 로봇은 자신의 정확한 상태를 직접 관측하지 못합니다. 센서가 주는 것은 $x$가 아니라 $z$이며, 우리가 실제로 계산할 수 있는 것은 $x$에 대한 belief입니다. 이 지점에서 MDP의 상태 가정이 깨지고 POMDP가 시작됩니다.
POMDP
POMDP의 핵심 Bellman equation은 MDP와 거의 똑같이 생겼습니다. 단 하나의 결정적인 차이는 state $x$가 있던 자리에 belief $b$가 들어간다는 것입니다.
\[\max_u \left[ r(b,u) + \gamma \sum_z p(z \mid b,u) V^\ast\bigl(\tau(b,u,z)\bigr) \right]\]$b$는 실제 상태에 대한 확률분포이고, $\tau(b,u,z)$는 현재 belief $b$에서 행동 $u$를 수행한 뒤 관측 $z$를 얻었을 때 만들어지는 새로운 belief입니다. 즉 POMDP에서는 실제 state가 아니라 state에 대한 확률분포 자체를 Planning의 state로 사용합니다.
이것이 가능한 이유를 이해하는 것이 POMDP의 핵심입니다. 실제 상태 $x_t$를 모르더라도 지금까지의 모든 관측과 제어를 조건으로 한 확률분포는 계산할 수 있습니다.
\[b_t(x) := p(x_t=x \mid z_{1},u_{1})\]앞에서 사용한 $bel(x_t)$와 같은 대상이며 여기서는 POMDP 표기에 맞춰 $b_t$라고 쓰는 것뿐입니다. 따라서 belief는 새로운 종류의 추정량이 아니라 이미 Bayes filter에서 계산하고 있던 posterior distribution입니다.
Belief Update
현재 belief가 $b(x)$이고 제어 $u$를 실행했다고 하겠습니다. 먼저 상태 천이 모델을 통해 다음 상태에 대한 예측 belief를 만듭니다.
\[\sum_x p(x' \mid x,u)b(x)\]연속 상태라면 합 대신 적분을 사용합니다. 이 식은 이전 belief의 각 상태 가설을 transition model을 통해 한 스텝 앞으로 이동시킨 뒤 모두 더한 것입니다.
이후 새로운 관측 $z$가 들어오면 measurement model로 보정합니다.
\[\eta\,p(z \mid x')\bar b(x')\]두 식을 합치면 POMDP의 belief transition이 됩니다.
\[\eta\,p(z \mid x') \sum_x p(x' \mid x,u)b(x)\]즉 $\tau$는 새로운 알고리즘이 아니라 Bayes filter의 예측과 보정을 함수 하나로 묶어 쓴 표기입니다. POMDP는 Planning을 하기 전에 매 순간 Bayes filter를 돌리고, 그 결과로 나온 posterior belief를 다음 의사결정의 state로 사용하는 구조입니다.
왜 belief 하나로 과거 전체를 버릴 수 있는가
POMDP에서 가장 중요한 수학적 사실은 belief가 지금까지의 history를 압축하는 sufficient statistic이라는 점입니다. 전체 history를 $h_t=(z_{1},u_{1})$라고 하겠습니다. 원래라면 정책은 $\pi(h_t)$처럼 지금까지 있었던 모든 관측과 제어를 입력으로 받아야 할 것처럼 보입니다. 그러나 history가 미래에 영향을 주는 경로는 현재의 실제 상태 $x_t$를 통하는 것뿐입니다.
다음 상태의 예측 분포를 history 전체로 쓰면
\[\sum_{x_t} p(x_{t+1} \mid x_t,u)\,p(x_t \mid h_t)\]입니다. 그런데 $p(x_t \mid h_t)$가 바로 현재 belief $b_t(x_t)$이므로,
\[\sum_{x_t} p(x_{t+1} \mid x_t,u)b_t(x_t)\]가 됩니다. 우변에는 더 이상 history $h_t$가 없습니다. 미래 상태를 예측하는 데 과거 전체가 필요하지 않고 현재 belief만 있으면 충분하다는 뜻입니다.
reward도 마찬가지입니다. 실제 state를 모르므로 행동 $u$를 했을 때 받을 reward 역시 하나의 값으로 확정할 수 없습니다. belief가 각 state의 가능성을 나타내므로 기대 reward를 계산합니다.
\[\mathbb{E}_{x \sim b}[r(x,u)]\] \[\sum_x b(x)r(x,u)\]즉 미래 state의 분포도 belief만으로 계산되고, 현재 reward의 기대값도 belief만으로 계산됩니다. Planning에 필요한 두 재료가 모두 history가 아니라 $b$만으로 결정됩니다. 따라서
\[\pi(h_t) \quad\Longrightarrow\quad \pi(b_t)\]로 바꿀 수 있습니다. 이것이 POMDP에서 belief를 state처럼 사용할 수 있는 정확한 이유입니다.
Observation Probability
POMDP의 Bellman equation에는 MDP에 없던 $\sum_z p(z \mid b,u)$가 등장합니다. 현재 belief와 행동이 주어져도 다음 observation은 아직 알 수 없기 때문입니다. 그 확률은 예측 belief를 measurement model에 통과시켜 얻습니다.
\[\sum_{x'}p(z \mid x') \sum_x p(x' \mid x,u)b(x)\]안쪽 합은 행동 $u$ 이후 $x’$에 있을 확률이고, 바깥쪽 합은 그 상태에서 관측 $z$가 나올 확률까지 합친 것입니다. 따라서 POMDP에서 다음 belief는 확정적으로 하나 정해지는 것이 아닙니다. 행동 $u$ 이후 어떤 $z$를 보느냐에 따라 $\tau(b,u,z)$가 달라집니다.
이 구조를 Bellman equation에 그대로 대입하면 의미가 선명해집니다.
\[\max_u \left[ \sum_x b(x)r(x,u) + \gamma \sum_z p(z \mid b,u) V^\ast\bigl(\tau(b,u,z)\bigr) \right]\]첫 번째 항은 현재 실제 state를 모르기 때문에 belief 전체에 대해 평균낸 즉시 reward입니다. 두 번째 항은 행동 이후 들어올 수 있는 모든 observation을 고려하고, 각각의 observation이 만들어낼 posterior belief의 미래 가치를 다시 평균낸 것입니다. MDP에서는 불확실성이 다음 state $x’$에만 있었다면, POMDP에서는 숨겨진 state 때문에 observation을 통해 belief가 어떻게 바뀔지까지 가치 계산 안으로 들어옵니다.
이를 $Q$ function으로 쓰면 MDP와의 대응이 더 분명해집니다.
\[r(b,u) + \gamma \sum_z p(z \mid b,u)V^\ast\bigl(\tau(b,u,z)\bigr), \qquad V^\ast(b)=\max_u Q^\ast(b,u)\]따라서 최적 정책은
\[\arg\max_u Q^\ast(b,u)\]가 됩니다. MDP에서 정책이 $\pi^\ast(x)$였던 것과 정확히 같은 구조지만, 로봇이 실제로 접근 가능한 정보가 $x$가 아니라 $b$이므로 정책의 입력이 belief로 바뀐 것입니다.
difference between MDP and POMDP
POMDP는 Belief Space 위의 MDP다
여기까지 전개하면 POMDP의 구조가 의외로 단순해집니다. 원래 POMDP에서는 진짜 state $x$가 숨겨져 있기 때문에 history 전체를 들고 다녀야 할 것처럼 보입니다. 그러나 Bayes filter가 history를 belief $b$ 하나로 압축해주고, 이 belief가 미래 예측과 reward 계산에 필요한 모든 정보를 보존합니다. 그러면 belief를 새로운 state로 보면 다시 Markov property가 성립합니다.
\[p(b_{t+1} \mid b_t,u_t)\]정확히는 $b_{t+1}=\tau(b_t,u_t,z_{t+1})$이고 다음 observation $z_{t+1}$만 확률적입니다. 따라서 POMDP는 부분 관측 문제를 belief space 위의 완전 관측 MDP로 변환한 것으로 이해할 수 있습니다.
이 변환은 공짜가 아닙니다. 원래 state가 $N$개뿐인 이산 POMDP라도 belief는
\[b(x_i) \ge 0, \qquad \sum_{i=1}^{N}b(x_i)=1\]을 만족하는 연속적인 확률벡터입니다. 따라서 belief space는 $(N-1)$차원의 simplex가 됩니다. 유한한 state space가 연속적인 공간으로 바뀌기 때문에 POMDP가 MDP보다 계산적으로 훨씬 어려운 이유가 여기에 있습니다.
MDP는 POMDP의 특수한 경우다
마지막으로 둘의 관계를 수식으로 정리해보겠습니다. MDP에서는 현재 state $x_t$를 정확히 관측할 수 있습니다. belief를 굳이 쓴다면 현재 state 하나에 모든 확률질량이 몰린 delta distribution이 됩니다.
\[\begin{cases} 1, & x=x_t \ 0, & x\ne x_t \end{cases}\]이 belief를 POMDP의 expected reward에 넣으면
$r(b_t,u)=\sum_x b_t(x)r(x,u)=r(x_t,u)$가 되고, belief에 대한 가치함수 역시 사실상 $V(b_t)=V(x_t)$로 붕괴합니다. 즉 상태를 완전히 관측할 수 있는 순간 POMDP의 belief distribution은 한 점으로 무너지고 POMDP Bellman equation은 MDP Bellman equation으로 돌아갑니다.
결국 두 모델의 차이는 recursion 자체가 아닙니다. 둘 다 Bellman recursion으로 미래 가치를 현재 가치에 접어 넣습니다. 차이는 그 recursion의 state로 무엇을 사용할 수 있느냐에 있습니다.
\[\text{MDP: } x_t \text{를 직접 알고 있으므로 } \pi^\ast(x_t) \qquad\Longleftrightarrow\qquad \text{POMDP: } x_t \text{를 모르므로 } \pi^\ast(b_t)\]앞에서 Bayes filter를 통해 계속 계산했던 belief는 단순히 위치를 예쁘게 추정하기 위한 결과물이 아니었습니다. POMDP까지 오면 그 belief 자체가 Planning의 입력이 됩니다. Perception이 현재 세계에 대한 확률분포를 만들고, Planning은 그 분포 위에서 미래 reward를 계산하며, Control은 $\arg\max$가 선택한 행동을 실제 시스템에 가합니다. Bayes filter에서 시작한 상태 추정과 Bellman equation에서 시작한 의사결정이 belief에서 하나의 구조로 만나는 지점이 POMDP입니다.