Dive Deep into System Programming
A deep dive into core System Programming concepts learned in class, including Floating Point, Parallelism, Dynamic Linking, and Dynamic Allocators.
Introduction
본 포스팅은 인하대학교 이어진 교수님의 System Programming강의를 기반으로 작성되었습니다.
한 학기동안 열정적으로 좋은 강의를 제공해주신 이어진 교수님께 진심으로 감사의 마음을 전합니다.
본 포스팅은 전체적으로 강의 요약 형식을 따르지만, 단순한 요약보다는 수업 중 생긴 호기심을 구체화하고 해결하는 과정도 포함되어 있습니다. 따라서 교수님께서 다루지 않은 추가적인 정보가 포함되어 있을 수 있음을 미리 밝힙니다.
X86-64의 탄생 배경
컴퓨터 전공자가 아니더라도 ‘메인보드’는 익숙한 용어일 것입니다. 컴퓨터는 기본적으로 0과 1, 즉 이진(Binary) 데이터로 동작하며, 메인보드에 장착된 모든 프로세서와 메모리는 이 데이터의 송수신을 통해 상호작용합니다.
0101...과 같은 이진 데이터로 고사양 게임이나 고화질 영상을 처리하기 위해서는 데이터가 초고속으로, 그리고 안정적으로 공급되어야 합니다. 이를 위해 고온이나 진동 환경에서도 강건한 수정 발진기(Crystal Oscillator) 가 마더보드의 심장 역할을 수행합니다. 이곳에서 생성된 14.31818 MHz 혹은 25 MHz의 진동이 클럭 제너레이터(Clock Generator) 를 거쳐 체배, 분주되어 CPU, PCIe, SATA, USB 컨트롤러 등에 필요한 기준 클럭(Reference Clock)으로 공급됩니다.
이때 CPU 코어는 다른 유닛들에 비해 훨씬 높은 속도로 동작해야 합니다. 그리고 CPU를 둘러싼 서로 다른 속도를 가진 유닛들이 CPU의 명령에 맞춰 타이밍을 맞추고 협업하는 과정을 동기화(Synchronization) 라고 합니다.
하지만 시스템 전체의 동기화가 아닌, CPU 내부 아키텍처와 그 안에서 일어나는 동작 원리를 얕게 탐구하는 것이 본 교과목의 핵심 목표입니다.
 본격적으로 X86-64 를 다루기 전에 시대 상황을 알고 ISA를 마주하면 아주 재밌습니다.
2000년대 초반 시스템은 32bit 벽에 부딪히고 있던 시기였습니다. 당시 표준이었던 x86(IA-32) 아키텍처는 기술적으로 한계치에 다다르고 있었고, 그 중 가장 치명적인 문제는 바로 메모리(RAM) 였습니다.
32비트 주소 체계로는 $2^{32} \text{bytes} = 4,294,967,296 \text{bytes}$ , 즉 최대 4GB의 메모리밖에 인식하지 못합니다. 당시 인터넷이 폭발적으로 성장하며 서버 시장에서는 4GB 이상의 메모리가 절실했지만, CPU가 이를 받아주지 못하는 병목 현상이 발생했죠
이 문제를 타개하기 위해, 당시 업계의 공룡Intel과 도전자 AMD(이미 제리 샌더스 체제에서 짐캘러가 애슬론을 개발한 상황) 는 서로 완전히 다른 해법을 들고 나왔습니다.
당시 CPU 시장의 절대강자였던 인텔은 아주 급진적인 선택을 합니다.
x86 명령어 세트는 너무 낡고 복잡해(CISC). 이걸 뜯어고치는 건 한계가 있으니, 싹 다 버리고 완벽한 64비트 전용 아키텍처를 새로 만들자!
그래서 탄생한 것이 HP와 합작하여 만든 IA-64 (Itanium, 아이테니엄) 아키텍처입니다. 이는 EPIC이라는 완전히 새로운 설계를 도입하여 이론상으론 훌룡했습니다. 하지만 이전 체계와의 호환성 문제가 심각했습니다.
인텔은 “앞으로는 모두가 64비트 프로그램만 짤 거야”라고 믿었지만, 현실은 전 세계의 모든 PC와 서버가 32비트 x86 프로그램으로 돌아가고 있었습니다. Itanium에서 기존 x86 프로그램을 돌리려면 에뮬레이션을 거쳐야 했는데, 속도가 처참할 정도로 느렸습니다. 결국 이 프로젝트는 사장됐죠.
지금 돌아보면 CISC를 포기한 선택이 틀린 선택은 아니였습니다. 그러나 Intel은 시대를 너무 앞서갔으며 강력한 후발주자가 있었죠.
인텔이 헛발질을 하는 사이, AMD는 철저히 실용주의적인 노선을 택합니다. AMD는 시장의 판을 뒤집을 힘이 부족했기에, 기존 사용자들을 버리지 않는 방법을 고안했습니다.
기존 x86 명령어 세트를 그대로 유지하면서, 레지스터와 주소 공간만 64비트로 ‘확장’하면 어떨까?
이 프로젝트는 짐켈러의 주도 하에 SledgeHammer 라는 프로젝트명으로 진행되었고, AMD64가 이 때 탄생했습니다. 이게 우리가 지금 배우려는 x86-64 됩니다. 2003년, 이 아키텍처를 탑재한 서버용 CPU Opteron(옵테론) 이 출시되었고 시장은 열광했죠.
Legacy Mode: 기존 32비트 OS와 프로그램을 아무런 성능 저하 없이 그대로 돌릴 수 있음.
Long Mode: 필요할 때만 64비트로 전환하여 대용량 메모리를 사용.
호환성이 x86-64의 가장 강력한 무기였던 것은 사실입니다. 하지만 단지 ‘옛날 프로그램을 돌릴 수 있다’는 점만으로 시장에서 우위를 점한 것은 아닙니다. AMD는 IA-32 아키텍처가 태생적으로 안고 있던 고질적인 병목 현상들을 깔끔하게 해결했습니다.
• 메모리 컨트롤러 내장 (IMC): FSB에서의 병목의 해소의 가장 혁신적인 변화는 메모리 컨트롤러를 CPU 코어 안으로 집어넣은(On-die) 것이었습니다. 기존 인텔 방식은 CPU가 메모리에 접근하려면 메인보드에 있는 별도의 칩(노스브리지)을 거쳐야만 했습니다. 이 통로(FSB)가 좁고 멀어서 데이터 전송에 지연(Latency)이 발생할 수밖에 없었습니다. AMD는 메모리 컨트롤러를 CPU에 내장함으로써 프로세서가 메모리에 직접 접근(Direct Connect Architecture) 할 수 있게 만들었습니다. 이로 인해 메모리 지연 시간을 획기적으로 줄였고, 특히 서버 시장(멀티 프로세서 환경)에서 압도적인 성능 격차를 만들어냈습니다.
• 범용 레지스터 증가로 인한 Spilling 감소 (Register Pressure 해결): 기존 IA-32는 범용 레지스터가 8개에 불과해 연산 도중 데이터를 메모리(스택)로 대피시키는 Spilling(변수가 레지스터 개수보다 많을때, Caller-Saved, Callee-Saved, 복잡한 수식 연산과 같은 상황에서 발생)이 빈번하게 일어났습니다. AMD는 이를 16개로 2배 늘려, 데이터를 CPU 내부(레지스터)에서 최대한 처리할 수 있게 만들어 성능을 끌어올렸습니다.
단순히 많이 늘렸다고 성공한건 또 아닙니다. Itanium의 범용 레지스터는 128개였습니다.
• 함수 호출 규약(Calling Convention)의 혁신 레지스터가 늘어난 덕분에 함수를 호출하는 방식 자체가 바뀌었습니다. 기존(cdecl 등)에는 함수 인자를 느린 메모리(스택)에 쌓아서 전달했다면, x86-64(System V AMD64 ABI)에서는 레지스터로 인자를 바로 전달합니다. 덕분에 함수 호출 시 오버헤드가 획기적으로 줄어들었습니다.
• RIP-Relative Addressing (명령어 포인터 상대 주소 지정) 도입 데이터에 접근할 때 현재 실행 위치(RIP)를 기준으로 주소를 계산하는 방식이 도입되었습니다. 이로 인해 운영체제의 핵심인 ‘위치 독립적 코드(PIC)’를 훨씬 효율적으로 작성할 수 있게 되었고, 라이브러리 로딩 속도와 보안성(ASLR)이 크게 향상되었습니다.
“기술적으로도 괜찮은데, 호환성까지 뛰어나네?”
이 사실이 입증되자 흐름이 완전히 바뀌기 시작했습니다. 마이크로소프트가 윈도우 서버의 64비트 버전을 인텔의 IA-64(Itanium)가 아닌, AMD의 x86-64를 기준(Standard)으로 개발하겠다고 공식 선언한것이 화룡정점을 찍었죠.
마이크로소프트의 이 선언으로 사실 끝이 났죠. 결국 Intel은 AMD의 설계를 역설계(Reverse Engineering)하여 거의 동일한 명령어 세트를 자사 CPU에 탑재합니다.
ISA란
한국인과 소통하기 위해서는 한국어를 사용해야한다는 규칙이 존재하듯, 하드웨어와 소프트웨어가 소통하기 위해서는 상호간에 소통 규칙(Interface)이 있어야합니다. 이 규칙이 바로 ISA(Instruction Set Architecture) 입니다.
ISA는 소프트웨어(OS, 컴파일러)가 하드웨어(CPU)에게 작업을 지시할 때 사용하는 어휘 목록(Vocabulary) 이자 문법입니다. 하드웨어는 우리가 0과 1로 이루어진 문법, 즉 기계어를 엄밀하게 지켜서 명령을 전달할 때만 비로소 작동합니다.
물론 현대의 우리는 직접 기계어를 작성하지 않고, 고급 언어로 코딩한 뒤 컴파일러에게 번역을 맡깁니다. 하지만 CPU의 역사를 되짚어보면, 초기 컴퓨터의 제한적인 메모리 용량 탓에 모든 비트에는 정보가 쉴 새 없이 집약되어 설계되었습니다.
따라서 우리는 컴파일러가 어떤 규칙으로 고급 언어를 이진 데이터로 변환하는지 이해할 필요가 있습니다. 특히 Floating Point, 동적 메모리 할당, 링킹(Linking), Exeptional Control Flow의 원리를 파악한다면, Overflow, Coredump, Heap Exhaustion과 같은 치명적인 에러부터 예상치 못한 출력이 발생했을 때의 원일을 추적하고 해결할 수 있는 근간을 형성하게 됩니다.
Floating Point(부동 소수점)
부동 소수점(Floating Point)을 제대로 이해하려면 고정 소수점(Fixed Point) 과 직접 비교해보는 것이 가장 확실합니다. 이 두 방식의 차이를 체감하기 위해 179.9999999999 를 각각의 자료형으로 저장했을 때 어떤 일이 벌어지는지 확인해 보겠습니다.
딥러닝 모델의 비약적인 발전은 GPU, TPU와 같은 하드웨어 자원의 효율적인 활용을 필수적인 과제로 만들었습니다. 특히 확장 가능한(Scalable) 학습 및 추론 환경을 구축하여 비용과 에너지 소비를 절감하는 것이 그 어느 때보다 중요해지고 있죠. 그렇기에 단원의 마지막 챕터에서 적절한 부동 소수점(Floating Point) 포맷의 선택을 통해 컴퓨팅 리소스를 최적화하는 방법을 간단하게 짚고 넘어가겠습니다.
1. 고정 소수점 (Fixed Point)
먼저 임베디드 시스템에서 가장 널리 쓰이는 32비트 고정 소수점 포맷인 Q16.16 format 으로 제 키를 변환해 보겠습니다. 이 방식은 32비트 중 상위 16비트를 정수부에, 하위 16비트를 소수부에 할당하는 방식입니다.
입력값: $179.9999999999$
변환 과정: $Input \times 2^{16} = 11,796,479.9999…$
저장된 정수값: $11,796,480$ (반올림 발생)
컴퓨터에 저장된 이 값을 다시 꺼내어 실제 어떤 수로 저장되었는지 역산해 보면 다음과 같습니다.
\[\text{복원된 값} = \frac{11,796,480}{65536} = 180.0\]입력했던 값($179.9999…$)과 비교해 보면 약 $0.0000000001$의 정보가 사라지고 $180$으로 퉁쳐진 것을 볼 수 있습니다. (만약 입력값이 $179.99999$였다면 $179.9999847…$로 저장되어 약 $0.000015$ 정도의 오차가 발생했을 것입니다.)
왜 그럴까요?
이는 Q16.16 포맷의 해상도(Resolution) 한계 때문입니다.
Q16.16에서 표현할 수 있는 최소 단위(LSB)는 $2^{-16} \approx 0.0000152$ 입니다. 제 키는 이 최소 단위의 격자(Grid) 사이에 위치하고 있습니다. 고정 소수점 방식은 이 정해진 격자를 벗어날 수 없으므로, 결국 가장 가까운 격자점에 값을 억지로 끼워 맞추면서 필연적인 오차가 발생하게 됩니다.
2. 부동 소수점 (Floating Point)
이번에는 제 키를 IEEE 754 Double Precision (64bit) 으로 표현해보겠습니다.
입력값: $179.9999999999$
Hex 표현:
0x4066 7FFF FFFF FF73
이 값을 비트 단위로 뜯어보면 다음과 같습니다.
S (부호, 1bit): $0$ (양수)
Exponent (지수, 11 bits): $10000000110_{(2)}$ (Bias 1023 + 7 = 1030)
Mantissa (가수, 52bit):
$0110011111111111111111111111111111111111111101110011_{(2)}$
눈여겨볼 점은 가수부(Mantissa)의 비트 패턴입니다.
중간에 1이 끊임없이 연속되는(F…F) 구간은 입력값이 다음 정수인 180에 극도로 가깝다는 것을 보여줍니다. ($179.99…$는 $180 - \epsilon$ 형태이기 때문에 비트가 꽉 차오르는 형태를 띱니다.)
이를 수식으로 복원하면 아래와 같습니다.
\[Value = (1 + \text{Mantissa}) \times 2^{(1030-1023)}\]3. 오차 분석
이제 저장된 값을 십진수로 완벽하게 풀어내어 원래 값과 비교해 봅시다.
원래 입력한 값:
179.9999999999실제 저장된 값:
179.9999999999000067...
고정 소수점(Q16.16)과 달리 오차가 거의 없는 것을 확인할 수 있습니다. 남은 비트들이 소수점 아래 값을 어떻게 채우고 있는지 살펴보면 그 이유를 알 수 있습니다.
\[\text{소수부} = 1 \times 2^{-1} (0.5) + 1 \times 2^{-2} (0.25) + \dots (\text{총 52비트까지 누적})\]물론 부동 소수점도 52비트 가수부라는 공간의 한계로 인해 무한 소수를 완벽히 담을 수는 없습니다. 하지만 소수점의 위치를 유동적으로 움직여(Floating) 유효숫자에 비트를 몰아주기 때문에, 고정된 격자를 사용하는 방식보다 훨씬 더 정밀하게 값을 표현할 수 있습니다.
Floating points in deep learning
컴퓨팅 리소스 최적화의 본질은 “모든 연산이 Single Precision의 정밀함을 필요로 하지는 않는다” 에서 시작합니다. 불필요한 정밀도(precision)는 아키텍처의 에너지 효율성과 메모리 계층 구조의 한계를 극복하기 위한 전략입니다.
따라서 현대 AI 아키텍처는 데이터의 성격에 맞춰 Format의 크기를 줄이는 전략을 취하고 있습니다. 좀 대중적인 포맷들을 중심으로 그 최적화 전략을 살펴보겠습니다.
AI 컴퓨팅 정밀도 및 최적화 전략
1. FP16 (Half Precision) vs BF16 (Brain Floating Point)
과거에는 정밀도를 위해 FP32를 쓰거나, 속도를 위해 FP16을 썼습니다. 하지만 FP16은 지수부가 5비트로 짧아 표현 범위가 좁았고, 이로 인해 학습 중 Overflow/Underflow가 빈번하게 발생하여 별도의 Loss Scaling 기법이 필수적이였다고 합니다.
이를 혁신적으로 해결한 것이 BF16(Brain Floating Point)입니다. BF16은 FP32와 동일한 8비트 지수부를 가집니다. 즉, 가수부를 7비트로 줄이는 대신, 표현 범위를 FP32 수준으로 유지하는 전략을 취한거죠. 덕분에 수치적 안정성이 극대화되어 복잡한 스케일링 없이도 LLM 학습의 표준 포맷으로 자리 잡았다고 합니다.
2. FP8 (Floating Point 8-bit)
NVIDIA Hopper(H100) 아키텍처부터 본격 도입된 FP8은 8비트라는 극도로 제한된 비트를 목적에 따라 두 가지 세부 포맷으로 유연하게 운용합니다.
E5M2 (Range Priority): 지수에 5비트를 할당하여 넓은 범위를 확보합니다. 값의 변동폭이 커서 정밀도보다 범위가 중요한 Gradients(기울기) 및 역전파 연산에 주로 사용된다고 합니다.
E4M3 (Precision Priority): 가수부에 3비트를 할당하여 상대적으로 높은 정밀도를 제공합니다. 정밀도가 결과에 큰 영향을 미치는 Weights와 Forward Activations 표현에 최적화되어 있습니다. 다만, 최대값이 448로 제한적이므로 정교한 Scaling Factor 관리가 동반됩니다.
3. MXFP4 (Microscaling Formats)와 Block Scaling
NVIDIA Blackwell 아키텍처에서 제시하는 MXFP4는 LLM 추론의 고질적인 병목인 Memory Wall(메모리 대역폭 한계)을 극복하기 위한 차세대 규격입니다. 4비트(E2M1 등) 단독으로는 정보 손실이 치명적이기 때문에, 하드웨어 수준의 Block Scaling 기술을 접목했습니다
이는 32개의 요소를 하나의 블록으로 묶고, 이들이 공통의 8비트 Scale Factor(Shared Exponent)를 공유하는 방식입니다. Blackwell의 2세대 트랜스포머 엔진은 이 블록 데이터를 압축 해제 없이 하드웨어에서 직접 연산함으로써, FP16 대비 이론상 최대 20배 이상의 Throughput을 처리 가능하다고 하네요.
4. Mixed Precision Strategy (혼합 정밀도 전략)
현대 AI 최적화에서는 각 포맷을 수치적 특성에 맞게 적재적소에 배치하려고 합니다.
Weights: 모델 파라미터는 통계적으로 분포가 안정적이며 양자화에 강건하므로, FP8이나 MXFP4로 과감하게 다이어트하여 메모리 점유율을 낮춥니다.
Gradients: 학습의 방향을 결정하며 매우 작은 값부터 큰 값까지 널뛰기 때문에, BF16이나 FP8(E5M2) 을 사용하여 수치적 범위를 확보해야 학습이 폭주하지 않습니다.
Bias & Norm Layers: 파라미터 수는 적지만 모델 전체의 수렴성을 결정하는 결정적인 요소입니다. 또한 Layer Norm/Batch Norm은 수만 개의 요소를 합산하는 과정에서 Swamping이 발생하기 쉬우므로, 연산의 정밀도를 보장하기 위해 FP32 혹은 BF16 포맷을 유지하는 것이 모델 붕괴를 막는 핵심입니다.
Dynamic Memory Allocation(동적 메모리 할당)
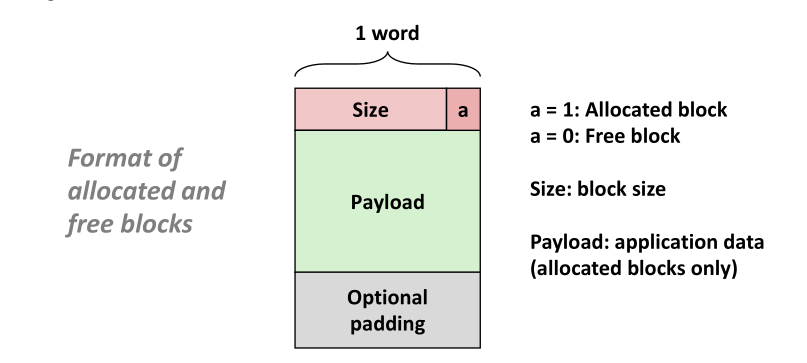
위 이미지가 힙(Heap) 영역에 쌓이는 동적 할당 블록(Dynamic Memory Allocation Block) 의 기본 형태입니다. 이 형태(헤더 + 페이로드 + 패딩)는 malloc과 같은 동적 메모리 할당기(Dynamic Memory Allocator) 가 힙 영역을 관리하기 위해 인위적으로 만든 포장지(Container) 이고, 이 포장지로 감싸 Dynamic Memory Allocator(동적 메모리 할당기) 가 프로세스의 가상 메모리 영역 중 Heap영역을 관리합니다.
Throughput(처리량): 단위 시간당 완료된 요청(malloc/free)의 수
Peak Memory Utilization(최고 메모리 이용률): 힙 전체 크기 대비 실제 사용 중인 Payload(실제로 요청한 크기)의 비율
동적 메모리 할당기는 위 두가지 상충되는 성능을 최대로 올리려고 노력해야하는데요, Throughput은 해당 교과목에서 다루지 않고 Peak Memory Utilization을 떨어트리는 Fragmentation Problem(단편화) 에 대해 다룹니다. Fragmentation Problem은 크게 아래와 같이 두가지로 분류할 수 있습니다.
Fragmentation Problem(단편화 문제)
Internal Fragmentation(내부 단편화): 할당된 블록 크기가
Payload보다 클 때 발생(헤더, 패딩 등으로 인해 발생)External Fragmentation(외부 단편화): 전체 여유 공간은 충분하지만, 연속된 단일 여유 블록이 없어서 할당 요청을 처리할 수 없는 상태
그리고 External Fragmentation Problem을 해결하기 위해서 아래와 같은 관리 전략이 존재합니다.
to managing Dynamic Memory(가용 리스트 관리법)
아래의 방법들은 구현을 위해 추가적인 데이터(헤더, 푸터, 포인터 등)가 필요로 합니다. 이는 Internal Fragmentation을 유발하거나 악화시키기 때문에 External Fragmentation문제를 해결하기 위한 관리법에 가깝습니다
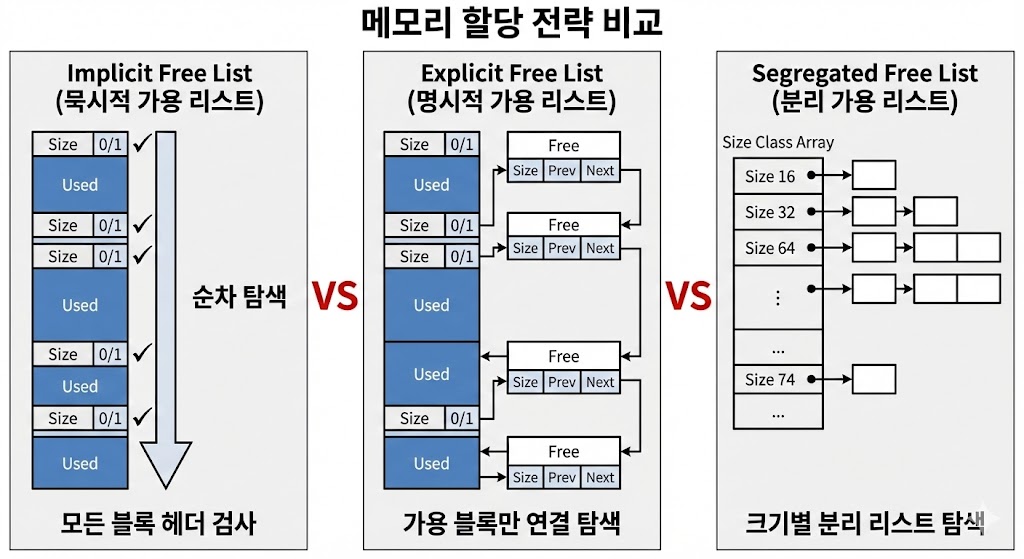
Implicit Free Lists(묵시적 가용 리스트): 모든 블록(Allocation/Free)을 헤더,푸터의 사이즈 정보를 통해 탐색
Explicit Free Lists(명시적 가용 리스트):
Payload영역에Next와Prev포인터를 저장하여, 가용 블록에서 다음 가용 블록으로 점프 하며 탐색 (Implicit Free List와 다르게 Free 영역만 관리)Segregated Free Lists(분리 가용 리스트):
Free영역만 포인터로 관리하되, 크기별로 리스트를 따로 관리
세가지 가용 리스트 관리 방법은 장단점이 존재합니다. 세가지 방법의 장단점은 아래와 같습니다.
| 방식 | 장점 (Pros) | 단점 (Cons) |
|---|---|---|
| Implicit List (묵시적 리스트) | • 구현이 가장 단순함 • 가용 블록 관리를 위한 포인터 공간이 필요 없어 작은 블록도 효율적으로 저장 가능 (Internal Fragmentation 최소화) | • 할당 시 힙의 모든 블록을 순차 탐색해야 하므로 속도가 매우 느림 ($O(N)$) • 힙이 꽉 찰수록 성능이 급격히 저하됨 |
| Explicit List (명시적 리스트) | • 가용 블록만 탐색하므로 할당 속도가 빠름 ($O(Free_Blocks)$) • 메모리가 꽉 차 있어도 탐색 속도가 일정하게 유지됨 | • 가용 블록 내부에 포인터(Next, Prev)를 저장해야 하므로 최소 블록 크기가 커짐 (Internal Fragmentation 증가) • 블록 분할/병합 시 링크 연결 작업이 복잡함 |
| Segregated List (분리 가용 리스트) | • 할당 속도가 가장 빠름 (크기별 리스트에서 즉시 찾음, 상수 시간 $O(1)$ 근접) • 메모리 이용률이 높음 (Best Fit에 근접한 효과) | • 구현이 가장 복잡함 • 여러 개의 리스트를 관리하기 위한 추가적인 메모리 오버헤드가 발생할 수 있음 |
위와 같은 장단점으로 인해 본인의 자원을 파악하고 적절한 관리 방법을 선택하는 것이 중요합니다.
언제, 얼마나 큰 메모리가 요청될지 예측할 수 없는 범용 시스템 (Linux, Windows, macOS 등)에서는 다양한 크기의 요청을 가장 빠르고 효율적으로 처리할 수 있는 분리 Segregated List를 표준으로 사용하고,
- GNU libc (glibc)의 malloc은
ptmalloc이라는 할당기를 사용하는데, 이는 분리 가용 리스트 방식을 고도화한 형태입니다.
임베디드 시스템 / 실시간 시스템에서는 메모리 자원이 매우 부족하여 Segregated List의 복잡한 메타데이터(여러 개의 리스트 헤더 등)가 부담스럽습니다. 그렇지만 빠른 속도는 내야하기에 Explicit List(명시적 리스트) 또는 단순화된 분리 리스트를 사용(x), 선호합니다.
극단적인 실시간 시스템(RTOS)에서는 Fragmentation를 아예 없애기 위해 Pool Allocation(고정 크기 블록 할당) 을 사용하기도 합니다.
Exceptional Flow(예외 처리)
Exceptional Control Flow (ECF) 는 강의에서 다룬 내용보다 깊이가 훨씬 깊습니다. 이 교과목에서 다루지는 않았지만 시스템의 가장 밑바닥인 전기 신호에서 시작해, 최상위 소프트웨어 로직까지 이어지는 거대한 흐름으로 프로세서 설계에서 가장 다루기 어려운 영역입니다.
X86-64의 복잡한 APIC 체계를 파악하기 이전에 OS가 없는 MCU(Cortex-M)의 NVIC을 바라보면 더욱 쉽게 APIC체계를 이해할 수 있습니다.
굉장히 중요한 주제이지만, 배운게 많지 않기에(상위과정 Computer Architecture 존재) 강의 내용보다는 제가 개인적으로 공부한 내용을 중심으로 진행합니다
Exceptional Flow: Cortex-M
Processor Core 옆에 존재하는 NVIC(Nested Vectored Interrupt Controller)의 동작이 중요합니다.
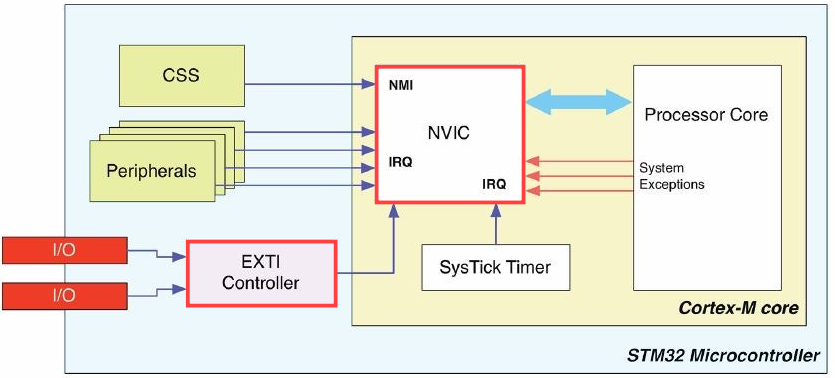
많은 책의 저자들이나 기업에서 Exceptional Flow와 Interrupt를 구분하지 않습니다. 그렇지만 본 포스팅에서는 Exceptional Flow라는 용어를 원인이 내부에 있건 외부에 있건 구별 없이 제어 흐름에서의 예기치 못한 변화를 지칭하는데 사용하고, 사건이 외부적인 요인으로 일어날 경우에만 Interrput라는 용어를 사용하겠습니다.
\(\text{Exception (예외)} = \text{System Exceptions} + \text{External Interrupts}\) ARM 아키텍처에서 정의하는 Exception(예외) 은 “정상적인 프로그램 실행 흐름을 바꾸는 모든 사건”을 통칭하는 가장 큰 집합입니다. STM 코드로 가장 많이 다루는 GPIO Interrupts는 Exception에 포함되어 있는 구조인 것이죠.
STM32 라이브러리(HAL Driver)나 데이터시트에서 NVIC(Nested Vectored Interrupt Controller)라는 이름을 쓰다 보니, 이걸 처리하는 컨트롤러 이름 때문에 싹 다 ‘인터럽트’라고 부르는 습관이 굳어졌다고 합니다. 하지만 엄밀히 말하면 NVIC는 Exception과 Interrupt를 모두 관리합니다.
디테일하게 Interrupt와 System Exception를 다루게 되면, 아래와 같이 성격이 다릅니다.
1. System Exceptions (시스템 예외)
CPU 코어 내부에서 “어? 이거 처리 못하겠는데?” 하고 터지는 예외들입니다. Fault나 Trap에 해당합니다.
Reset: 전원이 켜지거나 리셋 버튼을 눌렀을 때.
NMI (Non-Maskable Interrupt): 무시할 수 없는 치명적인 오류. (이름엔 Interrupt가 들어가지만 System Exception으로 분류됨)
HardFault: 잘못된 메모리 접근, 0으로 나누기 등 치명적인 에러.
SVCall (Supervisor Call): OS가 있을 때, 커널 함수를 호출하기 위한 명령어 (
svc 0). PC의syscall과 같습니다.PendSV, SysTick: OS 스케줄링을 위해 사용하는 타이머 관련 예외.
2. Interrupts (인터럽트)
CPU 코어 외부의 Peripherals들이 보내는 신호입니다. 사용자가 직접 조작하기 쉽습니다.
EXTI: GPIO 핀에 전압 변화가 생겼을 때
TIM: 타이머 카운터가 설정값에 도달했을 때
USART/SPI/I2C: 데이터 송수신이 완료되었을 때
우리가 흔히 컴퓨터 구조나 ARM Cortex-A(리눅스 돌아가는 고성능 칩)에서 배우는 Data Abort나 Prefetch Abort 같은 용어는 Cortex-M에서는 Fault 라는 이름으로 세분화되어있습니다. Cortex-M은 임베디드용이라 더 직관적인 디버깅을 위해 “Abort(그냥 죽었어)”가 아니라 “BusFault(버스에서 에러났어)”, “MemManage(메모리 보호 위반)”라고 구체적인 원인을 알려주는 이름으로 바꼈습니다.
하지만 System Exception이건 Interrupts이건 NVIC 입장에서는 똑같습니다. NVIC는 Exception과 Interrupt 를 하나의 통합된 테이블에서 관리하는데요, 만약 System Exception과 Interrupt가 동시에 발생한다면 NVIC는 출신을 따지지 않고 Priority를 기반으로 스케줄링합니다. 덕분에 유연한 시스템 설계가 가능한겁니다.
근데 HAL라이브러리를 사용하지 않고 Interrupt를 어떻게 하고, System Exception은 또 어떻게 할까요? 두 동작은 결국 동일한 원리입니다. Pending Bit(대기 비트) 를 건들이는 것이죠.
오늘 하루종일 썼는데 결국 다 작성하지 못했네요.. 언젠가 이어서 작성합니다.
Linking(링킹)
Linking은 여러 개의 코드와 데이터 조각을 모아 하나의 실행 가능한 파일로 만드는 과정으로, 컴파일 시스템에서 매우 중요한 단계입니다
링킹을 설명하기 위해서는 Compile Process(컴파일 과정) 에 대해서 알아야합니다.
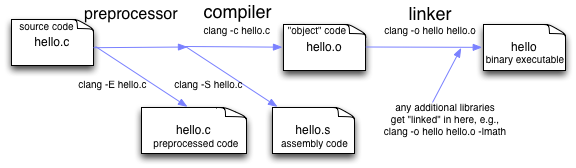
우리가 흔히 C언어로 코드를 작성하고 실행 파일을 만들 때, 단순히 “컴파일한다”라고 말하지만, 실제로는 내부적으로 Preprocessor(전처리기), Compiler(컴파일러), Assembler(어셈블러), Linker(링커) 라는 4단계를 거치게 됩니다.
Compilation System(컴파일 시스템) 4단계
시스템은 소스 파일을 실행 가능한 파일로 만들기 위해 다음 단계들을 순차적으로 수행합니다.
Preprocessor(전처리기):
소스 코드(
hello.c)를 입력받아#include,#define과 같은 지시자를 처리합니다.그 결과로 수정된 소스 프로그램(
hello.i)을 생성합니다.
Compiler(컴파일러):
전처리된 파일(
hello.i)을 입력받아 Assembly(어셈블리) 언어 프로그램(hello.s)으로 변환합니다.이 단계에서 C언어 문법이 기계가 이해하기 쉬운 저수준의 텍스트 형태로 번역됩니다.
Assembler(어셈블러):
어셈블리 파일(
hello.s)을 기계어 명령어로 변환하여 Relocatable Object File(재배치 가능 목적 파일) 인hello.o를 생성합니다.이 파일은 바이너리 형태이지만, 아직 독립적으로 실행할 수는 없습니다.
Linker(링커):
여기서 우리가 다루고자 하는 Linking(링킹) 이 일어납니다.
hello.o파일과 프로그램에서 사용하는 표준 라이브러리(예:printf.o) 등을 하나로 합쳐, 최종적으로 메모리에 로드되어 실행 가능한 Executable Object File(실행 가능 목적 파일) 을 생성합니다.
Linking이란?
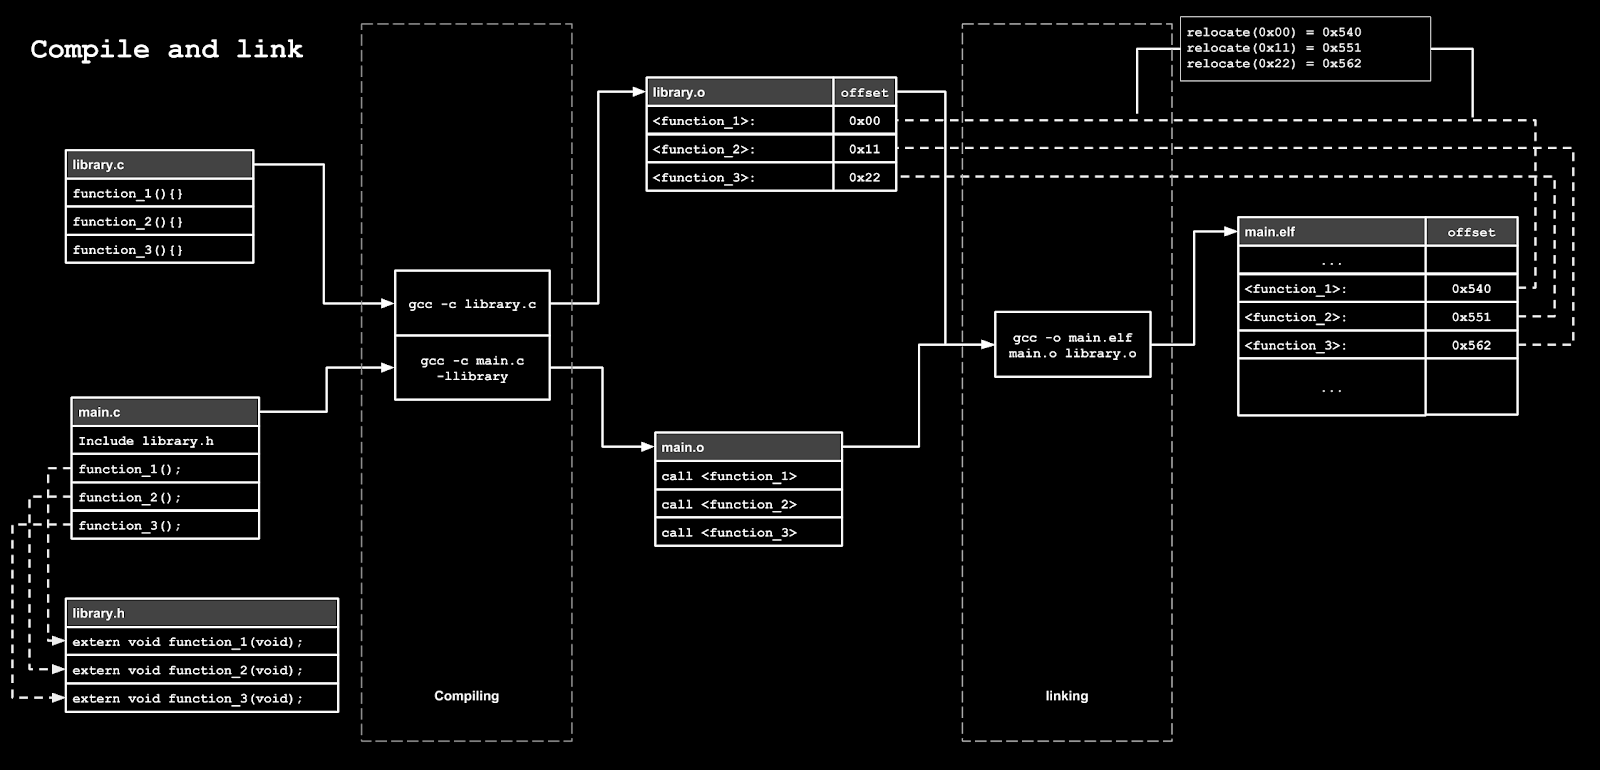
링킹은 Relocatable Object Files(여러 개의 재배치 가능한 목적 파일)을 하나의 Executable Object File(실행 가능한 목적 파일) 로 결합하는 작업입니다.
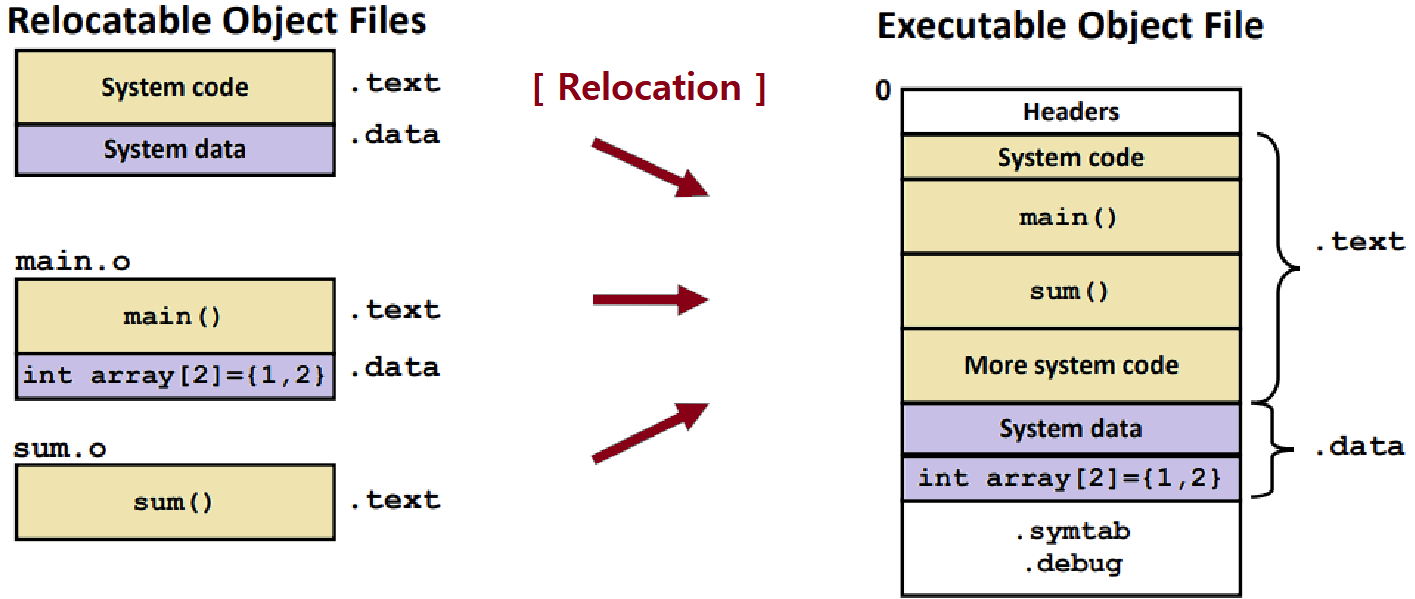
Linker(링커): 링킹을 수행하는 프로그램으로, 컴파일 시점이 아닌 링크 타임(Link time)**, **로드 타임(Load time), 또는 런타임(Run time) 에 수행될 수 있습니다.
주요 역할:
Symbol Resolution(심볼 해석): 각 Symbol Reference를 하나의 Symbol Definition와 연결합니다.
Relocation(재배치): 여러 코드와 데이터 섹션을 하나의 섹션으로 합치고, 심볼의 주소를 실제 메모리 주소로 변경합니다.
Object File(목적 파일)의 종류
목적 파일은 OS마다 다른 확장자로 나타나며, Linux를 기준으로 크게 세 가지 형태로 나눌 수 있습니다.
Relocatable Object File (.o): 바이너리 코드와 데이터를 포함하며, 다른 목적 파일과 결합하여 실행 파일을 만들 수 있는 형태 (컴파일 단계의 결과물)
Executable Object File (a.out): 링커에 의해 생성되며, 메모리에 로드되어 바로 실행될 수 있는 형태
Shared Object File (.so): 로드 타임이나 런타임에 동적으로 로드되고 링크될 수 있는 특별한 형태의 재배치 가능한 목적 파일
심볼(Symbol)과 심볼 테이블(Symbol Table)
링커는 Symbol Table(심볼 테이블) 을 사용하여 심볼을 관리합니다. 심볼 테이블은 .symtab 섹션에 저장되며, 전역 변수와 함수에 대한 정보를 담고 있습니다.
Global Symbols: 모듈
m에서 정의되고 다른 모듈에서 참조할 수 있는 심볼 (ex: 비정적(non-static) 함수, 전역 변수)External Symbols: 모듈
m에서 참조하지만 다른 모듈에서 정의된 심볼 (예:extern변수)Local Symbols: 모듈
m내부에서만 사용되는 심볼 (예:static함수,static변수). 지역 변수(Local variable)와는 다릅니다.
그리고 링커는 각 심볼 참조를 정확히 하나의 심볼 정의와 연결해야 합니다.
Strong Symbol vs Weak Symbol:
Strong: 함수와 초기화된 전역 변수
Weak: 초기화되지 않은 전역 변수
링커의 규칙:
동일한 이름의 Strong Symbol이 여러 개 있으면 링크 에러 발생
Strong Symbol 하나와 여러 Weak Symbol이 있으면 Strong Symbol 선택
여러 Weak Symbol만 있으면 임의로 하나 선택
_주의: 동일한 이름의 전역 변수를 여러 파일에서 잘못 사용하면 예상치 못한 버그가 발생할 수 있기 때문에 전역변수의 사용은 신중해야합니다!
정적 라이브러리(Static Library)와 동적 라이브러리(Shared Library)
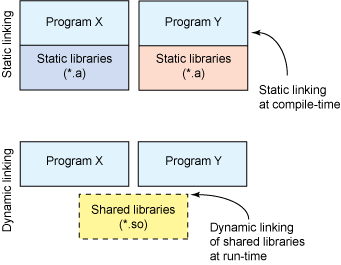
링킹 방식에 따라 라이브러리 활용법이 다릅니다.
Static Library (.a):
관련된 목적 파일(.o)들을 하나의 아카이브 파일로 묶은 것입니다. 링커는 아카이브에서 필요한 모듈만 복사하여 실행 파일을 만듭니다.
단점: 디스크와 메모리 공간을 중복해서 차지할 수 있고, 라이브러리 업데이트 시 다시 링크해야 합니다.
Shared Library (.so):
로드 타임이나 런타임에 메모리 로드 및 링크가 가능합니다.
장점: 하나의 라이브러리 코드를 여러 프로세스가 공유하므로 메모리를 절약할 수 있고, 라이브러리 업데이트가 용이합니다.
Dynamic Linking: 실행 시점에 링커(
ld-linux.so)가 필요한 라이브러리를 로드하고 심볼을 연결합니다.